첫번째 마당.
레고판(프레임웍)을
찾아라.
1막 패러다임을 바꾸자
1장.
절차지향 사고론에서 객체
지향 사고론으로
일반적으로 지금까지 소프트웨어를 개발하는
사고 과정은 다음과 같다. 먼저
사용자가 제공한 입력을 받고 이를 내부에서 정해진 일련의 절차에
따라 가공한 후 , 그
결과를 반환하는 코드를 작성하는 것이다. 이런
사고 과정을 절차적 사고방식, 또는
블랙 박스에 근거한 사고 방식이라고 한다. 예를
들면, C나
파스칼 같은 언어는 이러한 사고 방식에 근거한 언어이다.
이 방식에 익숙한 개발자들은
현실 세계의 문제를 다음과 같이 해결한다.
먼저 문제 해결에 필요한 자료구조를
설정한다. 다음에는
이 자료구조를 이용하여 원하는 결과를 도출하기 위한 일련의 함수를
작성한다. 마치
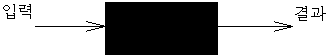
다음과 같이 입력과 결과 사이의 검은 박스를 채워나가는 것이다.
[그림1-1]
절차지향 사고방식
이러한 사고 방식은 "소프트웨어의 위기" 라는 문제를 양산하게 되었다. 소프트웨어의 위기는 고도로 분산된 네트웍 환경과 멀티미디어로 대표되는 다양한 대규모의 데이타, 고성능의 개인용 컴퓨터 등 급변하는 컴퓨팅 환경하에서 봇물처럼 쏟아져 나오는 다양한 사용자의 요구를 충족시키는 데 있어 기존의 절차지향 사고방식이 갖는 한계에 기인한다. 절차지향 사고방식에 의한 소프트웨어는 다음의 한계를 갖는다.
소프트웨어 위기돌파의 선봉장
이러한 한계들로 인해 절차적 사고 방식은 객체 지향 방식이라는 새로운 패러다임으로 일대 변환을 하게 된다. 사실 객체 지향 개념은 오래 전에 시뮬레이션을 위해 개발된 언어인 "시뮬라(SIMULA)"에서 소개됐었다. 객체 지향 개념에 이해가 될 듯하기에 좀 더 부연하자면 시뮬레이션이란 특정한 대상들 사이에서 발생하는 상호관계를 실제 구현해 보는 것인데 이 때 이 대상들은 특정한 행동 방식과 고유한 속성들을 갖게 된다. 이러한 특징은 객체 지향 방식의 사고와 일치한다. 여기서 기억해야 할 것은 객체 지향 방식에서 모든 것은 객체들 사이의 상호작용을 통해 이루어 진다는 것이다.
객체 지향 개념의 도입은 소프트웨어 개발에 있어 생산성과 유지, 보수에 많은 효과를 제공한다. 특히 이 방법은 인간의 사고방식을 그대로 반영하여 문제의 분석과 설계, 구현에 이르기까지 전일적인 해결 방법을 제시한다. 특히, 객체 지향 분석과 설계는 객체 지향 언어인 C++과 자바 같은 언어에서 그대로 구현할 수 있다. 만약 C++이나 자바 같은 객체 지향 언어를 주로 사용하는 분이라면 시간을 내어 객체 지향 분석과 설계에 관한 자신의 방침을 갖고 있는 것이 유리하다..
2장.
C++로 배워보는 객체 지향
사고론
객체 지향 개념을 소개하는 책자나 논문들은
수 도 없이 많다. 그러나
이 개념을 피부로 느끼게 해주고 즉시 적용할 있게 해주는 것을 찾기란
쉽지 않다. 따라서
객체 지향 개념을 쉽게 소개하기 위한 방법을 고민하다 프로그램 언어를
통해 소개하기로 결정하였다. 필자의
경험으로는 중요한 개념을 소개하는 프로그램 예제를 외우거나 출처를
기억함으로서 이를 나중에 응용할 수 있었다.
따라서 본 절에서는 현재 손쉽게 사용할
수 있는 객체 지향 프로그래밍 언어 중 가장 광범위하게 사용되고
있은 객체 지향 언어인 C++을
사용하여 객체 지향 개념을 베워보도록 한다.(
자바의 경우도 객체 지향 언어임은
분명하나 다중 상속처럼 순수한 객체 지향 개념을 충분히 반영하지
않고 있다. 자바
개발자들에 의하면 자바언어를 보다 강건하게 만들기 위해 불필요한
객체 지향 개념을 제거했다고 한다. 자바에
대한 보다 자세한 정보는 필자가 편역한 "코아 자바" 책을
참조하기 바란다. 자바에
대한 여러분의 모든 궁금증을 풀어줄 것이다.
)
참고로 본 절에서는 이미 여러분이 C나
파스칼, 코볼
같은 절차언어에 어느 정도 경험이 있다고 가정한다.
아울러 이 절의 내용을 무사히
숙지한다면 여러분은 여러분의 객체 지향 사고를 별다른 어려움없이
구사할 수 있으리라 확신한다.
원리이해1 객체란
무엇인가?
어떤 이는 "모든
것은 객체다" 라고
말한다. 이
말은 현실 세계에서 인지가능한 모든 것은 객체로 표현된다는 것을
의미한다. 좀
더 현실적으로 생각해보면 이런 사실을 유추해낼 수 있다.
현실 세계의 모든 것이 객체로
표현되면 현실 세계의 객체들간의 상호관계나 객체의 변화 역시 표현돼야
한다. 가령,
현실 세계에서 사람이란 실체는
하나의 객체이다. 사람은
주민등록번호나 나이 같은 공통적인 특성을 갖고 있으며 환경이나
시간의 진행에 따라 각기 다르게 변화한다. 또한
사람은 소속 회사나 소속 학교 등의 다른 실체(객체)와
특정 관계를 갖게 된다. 어떤
사람의 직장이라는 식의 관계는 앞으로 객체를 이해하는 데 많은 도움을
줄 것이다. 왜냐하면
객체를 표현하는 모든 속성은 이러한 관계를 표현하는 것이기 때문이다.
객체는 [그림1-2]과 같이 속성들과 변화들로 구성된다.
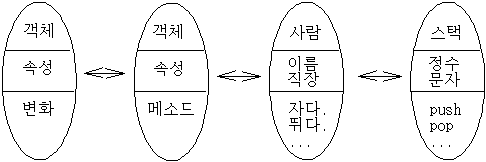
[그림1-2]
객체의 구성
각 객체는 자신의 고유한 속성과 변화로
구성된다. 좀
더 구체적인 용어로서 객체는 자신의 속성과 이를 변화시키는 일련의
메소드로 구성된다고 말한다. 여기서
메소드란 객체의 속성을 변화시키는 일련의 오퍼레이션을 의미한다.
가령, 사람이라는
객체는 이름이나 직장 또는 주민등록번호 같은 속성을 갖고 있으며
잠을 자거나 밥을 먹거나 뛰는 등의 메소드로 구성된다.
좀 더 구체적으로 일련의 원하는
데이타를 특정 구조에 넣거나 빼는 구조인 스택은 원하는 데이타를
속성으로 갖고 있으며 일정한 데이타를 삽입하는 push
메소드와 추출하는 pop
메소드 등을 갖는다.
객체의 특성
앞서 살펴본 대로 객체는 속성과 메소드로 구성되는 데 이러한 객체는 다양한 속성을 갖고 좀 더 다양한 현실 세계를 표현한다. 다음은 객체가 갖고 있는 다양한 특성에 대해 좀 더 구체적으로 살펴본다.
1) 추상화
객체는 속성과 메소드로 구성됨을 살펴보았다.
이때 각 속성은 객체의 메소드를
통해서만 변화가 가능하다. 특정
객체에 어떤 변화를 바란다면 객체내에 정의된 메소드를 통해서만
가능하다. 이처럼
속성과 메소드를 객체내부에 함께 정의함으로서 갖게 되는 특성을
객체의 추상화(Abstraction) 또는
은닉화(Encapsulation)라고
한다. 이러한
특징은 객체의 접근을 일정한 인터페이스인 메소드를 통해서만 가능하게
함으로서 많은 이점을 제공해준다. 가령,
속성은 건드리지 않고 메소드만을
추가함으로서 논리적 독립성을 확보할 수 있으며 확장성시 용이하다.
뿐만 아니라 객체의 속성에 대한
불필요한 조작을 원천적으로 방지할 수 있다.
2) 일반 객체
회사원이라는 객체가 출근하는 회사를 "직장"이라는 속성으로 갖듯이 여러분이 어떤 특정한 객체를 구성할 때 각기 다른 여러 개의 객체를 그 속성으로 갖을 수 있다. 이때 다른 객체를 그 속성으로 갖지 않고 단순하게 자신의 속성만으로 구성되는 객체를 일반 객체라고 한다. 가령, 프로그램시 정수, 실수 등은 다른 객체를 속성으로 하지 않고 고유하게 자신의 속성만으로 구성된다.
3) 복합 객체
복합 객체란
한마디로 하나 또는 여러 개의 단일 객체나 복합 객체를 자신의 속성으로
갖는 객체를 의미한다. 가령,
사람의 속성에는 문자열로 표현되는
이름이나 복합 객체인 회사를 그 속성으로 갖을 수 있다.
이러한 복합 객체는 특정한 기능을
통해 사용자에게 많은 표현력을 제공한다. 예를
들면, 특정
사람이 소속된 회사가 위치한 장소를 표현하거나 알고자 할 경우 ,
이러한 관계를 [그림1-3]
에서 처럼 복합 객체를 통해 표현하며
각 시스템은 이러한 관계를 표현하거나 이용할 수 있는 방법을 제공해야
한다. 예를
들면 사람.회사.장소이름
이라는 식의 표현에서 .(점)은
복합 객체 사이의 이동을 쉽게 표현할 수 있는 하나의 방법이 된다.
다음 [그림1-3]은
복합 객체를 그림으로 표현한 것이다.
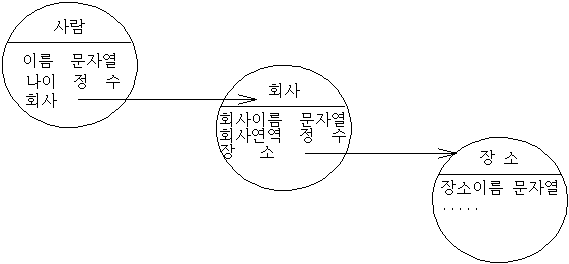 [ 그림1-3
] 복합 객체의 구성 예
4) 객체 식별자
모든 객체는 유일하다.
이 말은 모든 객체는 고유하게
구별되는 특성을 갖고 있다는 말이다. 다시
말해 객체는 실제의 값과는 무관하게 독립적으로 존재하며 이러한
독립성은 각각의 객체가 다른 객체와 구별되는 유일한 식별자를 갖음으로서
확보된다. 가령,
사람이라는 객체는 자신의 유일한
객체의 식별자를 갖고 이를 통해 구별되며 사람이라는 객체의 실제
값들인 홍길동 또는 성춘향은 같은 이름을 갖고 있는 다른 객체와
구별된다. 실제
동명이인일 경우 두 사람은 서로에게 유일한 주민등록번호라는 식별자를
통해 유일하게 구별되는 경우에 이 주민등록번호가 각 사람을 구별하게
해주는 식별자가 된다. 실제,
각 객체 지향 시스템은 적합한
식별자를 구현하게 되는 데 구현방법에 따라 사용가능한 객체의 숫자
등의 제약이 발생한다. 가령,
시스템에서 객체식별자의 개수를
초과하여 객체를 생성할 수 없다. 왜냐하면
중복된 객체 식별자를 사용해서는 안되기 때문이다.
원리이해2 클래스
클래스는 유사한 객체들의 공통특성을
모은 , 해당
객체를 대표하는 객체를 의미한다. 다른
표현으로는 객체를 찍어내는 틀이라고 말할 수 있다.
결국 클래스 역시 객체이다.
클래스는 여러 개의 객체를 생성하기도
하며 소멸시키기도 한다. 또한
클래스에 속해있는 여러 개의 인스턴스(실제
값을 지칭함)에
대해 메소드를 통하여 조작하기도 한다. 클래스들은
서로 간에 특정한 관계를 맺어 현실 세계를 반영한다.
C++이나 자바같은 객체 지향 언어를
사용하는 과정에서 가장 많이 사용하고 친숙해야만 하는 말이 클래스이다.
앞서 언급한 것처럼 클래스는
객체를 생성하기도 하고 소멸시키기도 한다.
따라서 클래스에는 객체를 생성하기
위한 기능과 객체를 소멸시키기 위한 기능을 갖는다.
또한 클래스역시 객체이다.
따라서 클래스는 원하는 자료구조와
함수를 포함한다.
용어 정리 : 클래스에 포함되어있는 자료구조를 데이타 멤버라 하고
클래스에
포함되어 있는 함수를 메소드(또는
멤버 함수)라고
한다.
따라서 클래스는 데이타 멤버와 메소드로 구성되어 갭슐화(encapsulation)된다. 이 캡슐화는 데이타 멤버를 밖으로 들어내지 않고 내부에서만 사용하게 해줌으로서 데이타 멤버를 숨긴다(information hiding). 이 점이 C++에서 클래스가 중요하다고 말해지는 이유중 하나이다. 기존의 파스칼이나 C같은 구조적 프로그래밍 방법에서는 프로그램 작성시 사용하는 중요한 데이타 구조를 중심으로 하여 이 구조를 원하는 대로 조작하기 위해 함수를 작성한다. 즉, 원하는 문제를 표현하기 위한 데이타 구조를 잡고 이 구조를 조작하기 위한 함수를 작성함으로서 문제를 해결한다. 한마디로 데이타 처리중심의 패러다임이다. 이 패러다임은 한가지 중요한 문제에 봉착하게 된다. 즉, 데이타 구조가 변경되면 프로그램의 처리 순서 뿐 만 아니라 함수까지 변경해야 만 한다. 또한 작성된 코드의 재사용이 어렵다는 등의 문제를 발생시킨다. 그러나 객체 지향 패러다임에서는 클래스 내부에 데이타 멤버와 필요한 메소드를 함께 정의함으로서 데이타와 관련된 함수를 강력하게 결합시켜 전체 프로그램에 영향을 미치지 못하게 한다. 따라서 이러한 구조적 프로그램의 문제를 C++에서는 클래스를 이용하여 해결할 수 있다. 다음 < 예제1-1 >은 객체 지향 패러다임에서 클래스를 정의하는 예이다. < 예제1-1 > 의 경우 사람에 대한 정보를 다루기 위한 클래스 정의이다.
< 예제1-1
> ----> 클래스 정의
class Person {
int person_id;
char * person_name;
short person_age;
Person();
Person(char* );
~Person();
PutName(int,char*, short);
};
먼저 클래스는 키워드 class로
시작한다. 이
키워드 다음에 오는 단어가 클래스의 이름이 된다.
또한 {}안에
선언된 것들이 Person 클래스의
멤버이다. 이렇게
클래스를 정의하여 사용할 경우 문제가 생긴다.
다름아니라 클래스의 데이타 멤버에
접근하는 방법에 대한 고려가 필요하다. 결국
클래스의 접근 정도에 따라 클래스의 사용법이 달라지게 된다.
따라서 이 점은 확실히 이해해야
한다. C++에서는
클래스의 멤버에 3가지
접근조정을 가능하게 해주는 데 다음과 같다.
- private
클래스 내부에서만 사용되는 데이타 멤버와
멤버 함수이다. 즉,
한 클래스 내부에서 private로
선언된 데이타 멤버와 멤버 함수는 외부에서 직접 접근할 수 없다.
단 public으로
접근 정도가 선언된 멤버 함수와 그 클래스의 friend를
통해서만 가능하다.( friend는
다음 절에서 자세히 설명한다. 단지
여기서는 친구라는 말뜻 그대로 친구에게 자신의 멤버에 대한 접근허용을
제공한다고 이해하면 될 것이다. )
- protected
protected로 선언되면
private경우처럼
public으로
접근 정도가 선언된 멤버 함수와 그 클래스의 friend를
통해서만 가능하다. 단
protected의
경우 이 클래스로 부터 파생된 클래스와 이 클래스의 friend의
경우 접근이 가능하다.(클래스의
파생에 대한 내용은 뒤에서 자세히 다룬다. 단
여기서는 한 클래스 A로
부터 파생된 클래스 B는
A의 모든
데이타 멤버와 멤버 함수를 갖고있다라고 이해하기 바란다.
바로 이 점이 C++에서
말하는 상속의 개념이다.)
- public
외부에 제공되는 클래스의 인터페이스이다. 즉 외부의 다른 클래스는 이용하고자 하는 클래스에서 public으로 정의된 멤버 함수나 데이타 멤버는 언제고 이용할 수 있다. 만약 어떤 프로그램을 작성하고자 할 때 필요한 데이타 멤버와 멤버 함수를 private나 protected로 선언하고 이 부분에 대한 접근은 일정한 멤버 함수에 정의한 후 public 으로 외부에 제공하면 안정적인 클래스를 만들 수 있다. 가령 다음 < 예제1-2 >는 이 접근 조정 방법을 이용해 클래스를 정의한 예이다.
< 예제1-2
> ----> 접근 조정 방법을
이용 person 클래스
정의
class Person {
private :
int person_id;
char * person_name;
short person_age;
protected:
char* person_address;
int person_tel_num;
public:
Person();
Person(char* );
~Person();
PutName(int,char*, short);
PutTelNum(int);
PutAddress(char*);
PutTelnum(int);
PrintPerson();
};
< 예제1-2
>의 경우 private,
protected, public 은 각기 앞서
설명한 접근범위를 제한하는 키워드이다. 먼저
구문상 이 키워드들 다음에는 :(콜론)이
붙어야 한다. 그러나
일반적으로 private의
경우 따로 명시하지 않고 클래스 멤버 중 제일 앞에 온 것들을 private멤버로
간주하기도 한다. < 예제1-2
>에서 경우 클래스 이름은
Person이다.
클래스 Person은
person_id , person_name , person_age 를
private 데이타
멤버로, person_address , person_tel_num 를
protected 데이타
멤버로 갖는다. person 클래스를
이용하려면 public 에
정의된 멤버 함수를 통해서만 가능하다. 만약
Person 클래스의
내용을 보려고 한다면 PrintPerson() 메소드를
통해서만 가능하다. 만약
<예제1-3>의
경우처럼 직접적으로 private 나
protected 멤버를
직접적으로 접근할 경우 에러가 발생한다.
< 예제1-3
> ----> 접근범위 위반
void test_Person(Person& P)
{
int test_id = P.person_id;
// error발생,person_id는 private
char * test_name = P.person_name;
// error발생,person_name은 private
}
원리이해3 생성자와
소멸자
<예제1-2> 에서 Person 클래스의 public 멤버중 Person() , Person(char*) , ~Person() 이라는 메소드가 존재함을 볼 수 있다. 앞서 언급한 내용을 잠시 다시 한번 생각해보자. 클래스란 객체를 생성하거나 소멸시키는 판이라고 정의한 적이 있다. 그렇다면 과연 어떤 방법을 통해 객체를 생성시키거나 소멸시킬수 있을까라는 문제가 발생한다. C++에서는 이 문제를 생성자와 소멸자라는 특수한 메소드를 사용하여 해결한다. 일단 선언된 클래스는 이 생성자를 통해 객체 인스턴스를 만들어내고 소멸자를 통해 이전에 생성된 객체 인스턴스를 소멸시킨다. 이 생성자와 소멸자는 클래스를 이용하는 과정에서 많은 유용함을 제공한다. 가령, 생성자를 이용하여 생성되는 객체 인스턴스에 암묵적인 값을 정의한다든지 또는 특정한 크기의 메모리를 할당한다든지 하는 경우이다. 마찬가지로 소멸자를 이용하여 할당된 메모리를 힙에 반환하는 역할을 부여하면 메모리 관리를 더욱 효율적으로 할 수 있다. 이러한 생성자와 소멸자는 몇 가지 특징이 있다. 먼저 생성자와 소멸자는 반환 값이 없다. 따라서 반환 값에 대한 타입도 없다. 또한 객체의 생성시 생성자만을 통해서만 가능하고 소멸시는 소멸자를 통해서만 가능하다. 또한 동시에 여러 개의 생성자를 작성할 수 있다. 가령, Person()와 Person(char*)는 서로 다른 2개의 생성자이다.
다음 <예제1-4>는 생성자와 소멸자를 포함한 Person 클래스의 예이다.
< 예제1-4
> ----> person 클래스의
생성자와 소멸자 정의
class Person {
private :
int person_id;
char * person_name;
short person_age;
protected:
char* person_address;
int person_telnum;
public:
Person()
{
person_name=NULL;
person_address=NULL;
cout <<"\n" << ":::called Person class" << flush;
}
Person(char* );
~Person();
PutName(int,char*, short);
PutTelNum(int);
PutAddress(char*);
PrintPerson();
};
inline Person::Person(char * name )
{
if(person_name != NULL) delete person_name;
person_name = new char[strlen(name)+1];
strcpy(person_name,name);
}
Person::~Person()
{
delete [] person_name;
delete [] person_address;
cout <<"\n" << ":::deleted Person class" << endl << flush;
}
이 예제에서 문법적으로 고려할 사항은
멤버 함수를 정의할 경우 ::(범위
조절자)의
사용이다. 먼저
해당 클래스 이름을 정의하고 범위 조절자를 명시한 후 해당 메소드를
정의한다( Person::Person() ). 범위
조절자를 사용하는 이유는 해당 메소드나 데이타 멤버의 소속범위(
Person::person_age처럼 )를
명시하기 위해서이다. 아울러
Person::Person() 처럼
클래스 내부에서 메소드의 실제 코드가 작성된 경우 이 함수는 inline함수와
같은 기능을 한다. inline 메소드는
실제 해당 메소드의 코드내용이 inline 메소드를
호출하는 자리에 채워진다. 따라서
실행중 호출된 함수로의 이동이 없어지게 되어 프로그램 수행이 빨라진다.
원리이해4 인스턴스화
Person 클래스에서
각각의 객체가 만들어지는 과정을 "인스턴스화"라고
한다. Person 클래스판에서
각각의 객체가 만들어지는 인스턴스 과정은 다음과 같다.
Person gildong;
Person *gildongPtr = new Person;
위의 예에서 gildong이라는 객체는 Person클래스의 판을 통해 생성된다. 뿐만 아니라 gildongPtr은 포인터 객체로서 Person 클래스의 크기만큼의 메모리를 할당받고 생성된다. 위와 같이 클래스를 사용하여 여러분은 원하는 객체를 생성할 수 있다. 그러나 이때 하나 재미난 사실을 기억해야 한다. 위와 같이 객체를 생성할 때 항상 불리워지는 메소드가 있다. 이 메소드가 바로 생성자이다. 즉 Person gildong;문장의 경우 Person클래스의 기본 생성자인 Person()을 호출한다. 뿐만 아니라 gildongPrt의 경우에도 C++에서 메모리할당 연산자인 new가 Person 클래스의 기본 생성자인 Person()을 호출하고 이를 통해 객체의 크기와 멤버의 종류 등의 정보를 얻어와 객체를 생성한다. 마찬가지로 다음의 구문에 대해 고민해 보자.
Person gdhong("홍길동");
이 구문의 경우 Person
클래스의 한 객체인 gdhong은
생성시 매개변수로서 "홍길동"을
갖는다. 이
매개변수는 Person 클래스의
Person(char*) 생성자를
호출하고 이 생성자는 Person 클래스의
객체를 생성하며 person_name이라는
데이타 멤버에 "홍길동"이라는
문자열을 복사한다. 결국
person_name이
"홍길동"인
객체를 생성한 것이다. 추가적으로
C++에서는
같은 이름의 함수가 복수 개 존재하는 것을 허용한다.
즉 Person(),
Person(char*)는 같은 이름의
다른 함수이다. 다르다는
것은 매개변수의 형이 다르다는 의미이다. C++은
엄격한 데이타 형 검사를 하는 언어이기 때문에 위의 두 생성자는
같은 이름이지만 다른 형을 가졌기 때문에 다르게 인식된다.
이러한 방법을 C++에서는
오버로딩이라고 하는데 자세한 내용은 뒤에서 자세히 다룬다.
생성자와 마찬가지로 소멸자 역시 메소드다. 따라서 이 메소드는 객체가 생성된 후 자신의 역활을 충실히 수행하고 난후 불리워져 객체의 일생을 마치게 한다. 일반적으로 프로그램의 종료시 자동적으로 호출된다. <예제1-4> 의 경우 자동적으로 호출되어 만약 person_name과 person_address에 메모리가 할당되어 있으면 그 메모리를 힙에 반환하는 메소드인 delete연산자를 수행한다.
원리이해5 상속(계승,Is-A)
상속은 클래스들 사이의 특수한 이해관계를
지칭하는 데 아버지의 특성을 아들이 물려받거나 또는 아버지와 어머니의
특성을 동시에 물려받거나 하는 경우처럼 특정 클래스의 속성과 메소드를
다른 클래스가 물려받는 경우에 이 두 클래스 사이에는 상속 관계가
있다라고 말한다. 이
때, 상속을
제공하는 클래스를 상위 클래스(superclass)
또는 기본 클래스(base
class), 토대 클래스라
하고, 상속받는
클래스를 하위 클래스(subclass)
또는 유추된 클래스(derived
class) , 또는 파생 클래스라고
한다. 이러한
관계는 일정한 계층도로 표현이 가능한데 이를 클래스 계층도(class
hierarchy)라 한다.
또한 상위 클래스가 하나일 경우에는
단일 상속 이라 하고 두 개 이상의 클래스로부터 동시에 상속을
받는 경우 다중 상속이라 한다. 이러한
상속 개념은 다음의 장점들을 제공한다. 먼저
공통된 특성을 상위 클래스에 선언하고 하위 클래스에서 그 특성을
상속받음으로서 현실 세계를 더욱 간결하게 모델링하게 해주며 또한
메소드 역시 상속받음으로서 코드 재사용을 가능하게 해준다.
[그림1-4]를
참조해 보자. 구급차
클래스는 자동차 클래스를 상위 클래스로 하여 자동차 클래스의 모든
속성과 메소드를 상속받는다. 이
경우 자동차 클래스 하나만의 속성과 메소드를 상속받는 경우 단일
상속이라 하고 자동차 클래스외에 비상 클래스처럼 다른 클래스를
동시에 상속받는 경우 다중 상속이라 한다. 실제
구급차 클래스는 자동차와 구급 클래스의 모든 속성을 갖고 있다.
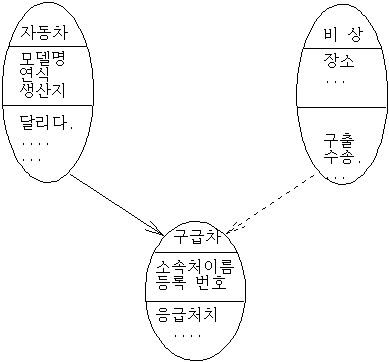
[그림1-4]
상속 관계
이러한 클래스관계는 다른 클래스들 사이에서
원하는 클래스의 멤버를 상속받아 재사용할 수 있으며 유지보수가
쉽다는 장점이 있다. 가령,
소방차라는 클래스를 정의할 경우
소방차클래스는 자동차클래스의 특성과 비상사태라는 특성을 포함한다.
이때 별도의 멤버 정의없이 기존의
자동차클래스와 비상클래스를 상위 클래스로 상속받으면 간단히 해결되며
이후 유지보수도 쉬워진다.
1. 상속범위
클래스에서 접근범위를 조정하는 것과
마찬가지로 클래스들 사이에서 상속 관계의 설정시 각기 상속받아
접근할 수 있는 범위는 원하는 목적에 따라 다르다.
가령, 상위
클래스를 public, private, protected등으로
받을 수 있고 virtual 이라는
개념으로 받을 수도 있다. 상속받는
범위와 정보에 따라 각기 다른 목적으로 사용할 수 있다.
다음의 예를 들어 설명하면서
보다 자세히 살펴보자.
class X {
// 기본이 private
int privat_emember;
protected :
int protected_member;
public :
int public_member;
};
- public
상위 클래스를 public으로 상속받으면 상위 클래스의 멤버중 public과
protected 멤버를 상속받고 접근할 수 있다. 단 private멤버는 상속받지
않는다.
다음은 그 예이다.
class Y : public X {
derivedY();
};
Y::derivedY()
{
private_member;
//error발생->private_member는 private멤버임
protected_member;
//문제없음->protected_member는 protected멤버임,
//따라서 유추된 하위 클래스에서 사용가능
public_member;
//문제없음->public_member는 public멤버임
}
- private
상위 기본 클래스의 public멤버와
protected멤버를
유추된 하위 클래스의 private멤버로
상속된다. 이
말은 유추된 하위 클래스의 멤버 함수에 의해서만 접근될 수 있다.
단 private는
상속되지 않는다.
앞서의 내용을 정리하면 다음과 같다.
| 기본 클래스 멤버 접근도 | public상속 | private상속 |
| public | public | private |
| protected | protected | private |
| private | 상속 안됨 | 상속 안됨 |
[ 표 1-1 ] 상속된 클래스 멤버의 접근도
- protected
상위 클래스에 대한 protected상속은
private상속과
동일하나 상속받은 멤버를 다시 하위의 클래스들에게 접근을 허용한다는
사실이 다르다.
- virtual
앞서의 기능이 상위 클래스의 멤버를 상속받아 사용할 경우 상위 클래스의 정보를 공유하는 정도에 대한 명시라면 virtual은 정보의 공유 기술이다.
여러 개의 클래스들이 동시에 하나의
상위 클래스에서 부터 멤버를 상속받을 경우 복수 개의 하위 클래스들이
하나의 상위 클래스를 공유하거나 각기 개별적으로 상위 클래스를
갖을 수 있다. 전자의
경우처럼 공동의 상위 클래스를 공유하기 위해서 C++에서는
virtual이라는
키워드를 사용한다. 왜냐하면
C++은 타입검사가
엄격한 언어이기 때문이다. virtual은
C++에서
정보를 공유하기위한 기능을 제공한다. 다음의
예는 virtual을
이용한 정보공유의 예이다.
class X { };
class Y1 : public virtual X { };
class Y2 : public virtual X { };
class Z : public virtual X, public Y1, public Y2 { };
이 경우 클래스 Y1,Y2는
하나의 클래스 X를
공유한다, 그러나
만약 virtual을
선언하지 않으면 클래스 Y1,Y2는
각기 하나씩 2개의
X를 사용한다.
따라서 virtual을
통한 정보의 공유는 프로그램의 크기를 줄이고 성능을 향상시킬 수
있다. 그림으로
표현하며 다음과 같다.
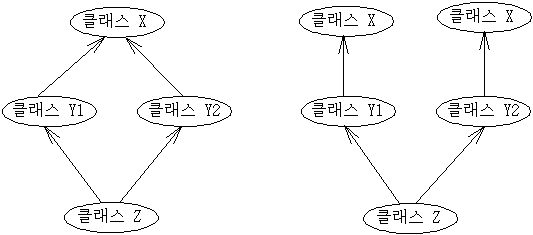
[그림1-5]
virtual사용
[그림1-6]
virtual사용 안함
2. 상속시 인스턴스화
상속 관계를 통해 클래스들은 일정한
계층구조를 만들어 낸다. 따라서
이 계층구조에서 하위 클래스는 상위 클래스의 데이타 멤버와 메소드를
물려받는다. 따라서
하위 클래스를 통해 객체를 생성할 경우 일정한 방식에 의해서 객체를
생성한다. 이
방식이란 다음과 같다. 가령,
new를 사용하거나 클래스 선언에
의해서 하위 클래스를 생성할 경우 가장 상위의 생성자가 호출되고
가장 하위의 클래스까지 연속적으로 생성자가 호출된다.
반대로 선언된 클래스의 객체가
정의된 범위를 다하거나 delete등에
의해서 소멸될 경우 생성시와 반대의 순서로 소멸자가 호출된다.
<예제1-5>는
이 사실을 극명하게 보여준다.
<예제1-5>
----> 상속시 생성자와 소멸자의
호출순서
#include<iostream.h>
#include<string.h>
class X {
public:
X(){ cout <<" class X has been created! " << endl; }
~X(){ cout <<" class X has been destoryed!" << endl; }
};
class Y : public X {
public:
Y(){ cout <<" class Y has been created! " << endl; }
~Y(){ cout <<" class Y has been destoryed!" << endl; }
};
class Z : public Y{
public:
Z(){ cout <<" class Z has been created! " << endl; }
~Z(){ cout <<" class Z has been destoryed!" << endl; }
};
void main(void)
{
Y* y = new Y;
}
실행결과:
X has been created!
Y has been created!
Z has been created!
Z has been destoryed!
Y has been destoryed!
X has been destoryed!
복수 상속 관계의 경우에도 인스턴스화되는 과정은 위와 같이 단일 상속의 경우와 마찬가지이다. 그러나 동일한 두개의 상위 클래스의 경우 그 순서는 구현하는 컴파일러마다 다르다. 그러나 일반적으로 왼쪽의 클래스에서 오른쪽으로 생성자가 호출된다.
3. 상위 클래스에
대한 하위 클래스의 접근
앞서 살펴본 바와 같이 상위의 기본 클래스는
public,private,protected로
선언된다. 따라서
상속받는 정도에 따라 상위 클래스에 대한 정도가 다르다.
예를 들면,
다음의 클래스가 있다고 하자.
class X { public : int dataX };
class Y1 : public X { };
class Y2 : protected X { };
class Y3 : private X { }
이 경우 X의
public멤버에
접근하는 것처럼 X의
포인터에 Y1를
할당하여 이용할 수 있다. 가령,
void testAssign(Y1* Y1ptr, Y2* Y2ptr, Y3* Y3ptr)
{
X* Xptr = Y1ptr; //문제없음-> X는 Y1의 public기본 클래스임
Xptr = Y2ptr; //error발생->X는 Y2의 protected기본 클래스임
Xptr = Y3ptr; //error발생->X는 Y3의 private기본 클래스임
}
또한 만약 Y2의
하위 클래스 Z가
다음과 같다면 클래스Z는
클래스X에
접근할 수 있다. 왜냐하면
클래스 X는
클래스 Y2의
protected 기본
클래스이고 Y2는
Z의 상위
클래스이기때문에 Z는
X에 대한
접근이 가능하다.
class Z : public Y2 { void methodZ(Y1*, Y2*, Y3* ); };
Z::methodZ(Y1* Y1ptr, Y2* Y2ptr, Y3* Y3ptr)
{
X* Xptr = Y1ptr; //문제없음
Xptr = Y2ptr; // 문제없음
Xptr = Y3ptr; // error
}
마지막으로 클래스 Y3의
경우 클래스 X를
private 기본
클래스로 갖기때문에 Y3의
멤버 함수인 methodY3()와
friend만이
X에 접근할
수 있다.
class Y3 : private X { void methodY3(Y1*, Y2*, Y3*); };
Y3::methodY3(Y1* Y1ptr, Y2* Y2ptr, Y3* Y3ptr)
{
X* Xptr = Y1ptr;// 문제없음
Xptr = Y2ptr; // error
Xptr = Y3ptr; //문제없음
}
원리이해6 복합
객체(IS-PART-OF)의
구현
앞서 우리는 복합 객체를 하나 또는 여러 개의 단일 객체나 복합 객체를 자신의 속성으로 갖는 객체로 정의하였다. 이 복합 객체는 C에서 구조체내에 다른 구조체를 정의하는 경우와 마찬가지로 한 클래스내의 데이타 멤버가 다른 클래스를 타입으로 갖는 경우이다. 가령, 지금까지의 모든 내용을 종합해보기 위해 다음을 생각해 보자. 어떤 사람에 대한 정보를 일련의 리스트 구조를 통해 관리한다고 해보자. 이 문제를 지금까지 배운 것으로만 구현하도록 한다. 이 문제를 풀기위해 가장 먼저 해야 할 것은 클래스를 찾는 것이다. 이 문제의 경우 사람의 정보를 담을 수 있는 사람클래스와 이 사람클래스를 통해 생성된 객체들의 정보를 리스트구조로 만들기 위한 리스트 클래스가 필요하다.
사람의 정보를 담는 person클래스는
앞서 정의한 것에 또 다른 사람을 가리키기 위한 포인터만 추가하면
된다. Person클래스의
나머지 멤버 함수의 정의는 다음과 같다.( 또한
앞서 정의한 Person 클래스를
상속받는 클래스를 정의해도 된다.)
<예제1-6>
---> Person 추가된 데이타
멤버와 멤버 함수
class Person {
....
Person *next; -> 추가된 부분
....
};
Person::PutName(int id,char* name, short age)
{
person_id = id;
if(person_name != NULL) delete Name;
person_name = new char[strlen(name)+1];
strcpy(person_name, name);
person_age = age;
}
Person::PutTelNum(int num)
{ person_telnum = num; }
Person::PutAddress(char* address)
{
if(person_address != NULL) delete person_address;
person_address = new char[strlen(address)+1];
strcpy(person_address,address);
}
Person::PrintPerson()
{
cout << "person Id :\t" << person_id << endl << flush;
cout << "Person Name :\t" << person_name << endl << flush;
cout << "Person Age :\t" << person_age << endl << flush;
cout << "Person Telnum :\t" << person_telnum << endl << flush;
cout << "Person Addr :\t" << Person_address << endl << flush;
}
또한 이 Person클래스의
리스트 구조를 만들 리스트 클래스의 정의가 필요하다.
먼저 이 리스트 클래스는 사람에
관한 정보를 담기 위한 데이타 멤버와 리스트 구조를 위해 자기자신을
가리키는 포인터를 필요로 한다. 또한
리스트의 삽입이나 삭제, 추가
등의 기본 연산이 필요하다. 또한
이 리스트정보를 확인해 보기 위한 멤버 함수도 필요하다.
특히 전체 리스트 정보를 확인해
보거나 리스트번호나 사람의 id, 이름
등 특정한 키워드등에 의한 조회도 필요하다.
이와 같은 기능의 리스트클래스를
정의할 때 한가지 고민거리가 생긴다. 사람에
관한 정보를 어떻게 표현할 것인가. 가령,
사람에 대한 모든 정보를 각기
데이타 멤버로 정의할 수도 있을 것이다. 이때
유용하게 사용할 수 있는 것이 사람이라는 클래스를 데이타 멤버로서
포함시킴으로서 간단히 이 문제를 해결할 수 있다.
앞서 계속적으로 언급했듯이 C++에서
모든 프로그램은 클래스 객체들 사이의 상호작용에 의해 표현된다.
따라서 이렇게 다른 클래스를
포함하면 포함한 클래스의 내용이 변하더라도 크게 문제가 되지 않으며
이후 연속적인 확장이 용이하다는 장점이 있다.
가령, Person클래스에
이 사람이 근무하는 회사의 정보를 추가할 경우 단지 Person클래스의
한 데이타 멤버로서 회사정보를 나타내는 클래스인 company클래스를
그 멤버로서 정의하면 된다. 리스트
클래스는 <예제1-1>과
같이 정의된다.
<예제1-7> ----> 사람 클래스의 리스트 표현
class ListPerson
{
private;
Person *personHead;
Person *personTail;
public:
ListPerson();
~ListPerson();
insert_person(int, char*, short, char*, int);
delete_person(int);
append_person(int, char*, short, char*,int);
print_personList();
print_personList(int);
};
ListPerson::ListPerson()
{
personHead = NULL;
personTail = NULL;
}
ListPerson::~ListPerson()
{
if(personHead) delete personHead;
if(personTail) delete personTail;
}
ListPerson::insert_Person(int id, char* name, short age, char* addr, int telnum)
{
if(personHead == NULL) {
personHead = new Person;
personTail = personHead;
}else {
personTail->next = new Person;
personTail = personTail->next;
}
personTail->PutName(id,name, age);
personTail->PutTelNum(telnum);
personTail->PutAddress(addr);
}
ListPerson::print_personList()
{
for(personHead;;personHead = personHead->next)
{ personHead->printPerson(); }
}
사람정보를 리스트 구조로 만드는 과정에만
필요한 멤버 함수만 정의하도록 한다. 전체
작성된 리스트구조는 [그림1-7]과
같다.
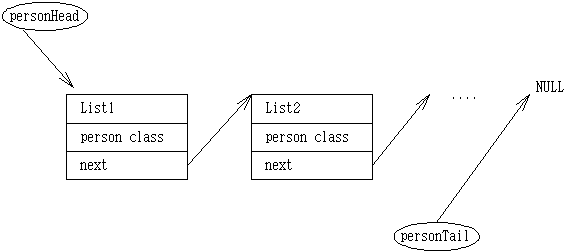
[ 그림1-7
] 전체 리스트 구조
먼저 Person클래스는
자기자신을 가리키는 포인터를 멤버로 갖는다.
따라서 ListPerson클래스는
Person정보를
리스트구조로 유지하기 위해 personHead와
personTail 두개의
포인터를 유지한다. 최초의
경우 ListPerson클래스의
인스턴스가 생성될 때 이 클래스의 생성자가 호출되며 personHead와
personTail 포인터가
널값으로 초기화된다. ListPerson클래스의
인스턴스가 생성된 후 personHead에
최초의 person객체를
생성하고 이 객체에 personTail을
함께 가리키게 한다. 이후
personTail을
계속적으로 증가시키면서 person객체를
추가한다. personHead는
항상 최초의 리스트를 가리키고 있다.
원리이해7 상속과
복합관계
상속 관계가 세로축으로 클래스들 사이의
관계를 정립하는 개념이라면 가로축으로 클래스들의 관계를 정립하는
개념이 복합 객체의 개념이다. 여기서
기억할 점은 상속과 복합 객체의 개념이 C++에서
클래스를 이용하여 현실 세계를 3차원(
가로축의 클래스와 세로축의 클래스
)으로 표현하는
모델링 능력을 제공한다는 점이다. 또한
이 모델링 능력은 바로 C++의
프로그램으로 맞아 떨어진다. 또한
기능적으로 복합 객체는 C에서
구조체를 접근하는 방법과 마찬가지 방법으로 많은 의미를 부여한다.
가령 다음의 예는 많은 의미를
함축한다.
class person { class company { class location {
... ... ...
company mycompany; location address; char* city;
... ... ...
}; }; }
위의 클래스 선언에서 어떤 사람의 회사가
서울에 위치한 것의 의미는 person.address.city
== "서울"이라는
복합 객체에 대한 접근 그 자체로서 표현된다.
이렇듯 상속과 복합 객체는 현실
세계를 모델링하고 이 모델링을 C++코드로
바로 매핑한다.
원리이해8 구조체와
클래스
C++에서 구조체는
C에서의
구조체와 다르다. 왜냐하면
클래스는 구조체의 개념을 포함한 더욱 포괄적인 구조체로서 접근범위와
함수 등을 내부에 포함하기 때문에 C++에서
구조체는 내부에 메소드를 포함할 수 있다. 그러나
구조체로 정의된 것은 내부의 모든 데이타 멤버와 메소드가 public으로
정의된다. 따라서
C++ 클래스에서
제공하는 정보의 은닉화나 캡슐화는 기대하기 힘들다.
가령 <예제1-8>에서
person클래스는
다음과 같이 구조체로 정의될 수 있다. 단
내부의 모든 멤버와 메소드는 외부에 드러나게 된다.
따라서 뜻하지 않게 외부의 다른
것에 의해서 리스트의 내용이 변할 수 있다.
< 예제1-8
> ---> 구조체와 클래스
struct Person{ class Person{
int person_id; public:
char* person_name; int person_id;
print_person(); char* person_name;
Person(); Person();
~Person(); ~Person();
} print_person();
}
원리이해9 친구클래스(Friend)
멤버 함수나 상속 관계가 아니더라도
특정 클래스의 private부분에
대한 접근을 허가한 클래스를 그 클래스의 친구(friend)라
한다. 사실
C++에서
캡슐화나 정보의 은닉화는 가장 중요하고 기본적인 개념이다.
이러한 개념을 지원하는 클래스는
일정한 방식에 의해서 상호간에 작용한다. 이
일정한 방식이 메소드이다. 그러나
friend를
사용하면 이러한 방식없이 클래스의 멤버에 접근할 수 있다.
따라서 가급적이면 friend를
사용하지 않는 것이 좋다. friend의
사용에 대해서 좀 더 자세히 살펴보자.
friend선언은 클래스상에의
어느 곳에서나 가능하다. 즉,
private나 public등
어느 곳에서나 선언이 가능하다는 말이다. 또한
클래스들 사이의 friend클래스선언도
가능하며 friend 메소드의
선언도 가능하다. 다음은
friend의
선언의 예이다.
<예제1-9>
---> 친구 클래스의 사용
class Gildong;
class DonghwaBank;
class Younghan {
....
// 클래스 donghwaBank의 friend function
friend double DonghwaBank::creadit(char* name);
//friend class
friend class Gildong;
....
};
위의 클래스 예제를 보면 DonghwaBank
클래스의 credit
멤버 함수는 실제 Younghan
클래스의 멤버 함수가 아니더라도
Younghan의
private클래스멤버에
접근할 수 있다. 또한
클래스 Gildong은
Younghan에
대한 접근을 허용받는다.
원리이해10 추상화
클래스와 구체화 클래스
추상화 클래스(Abstract
class)는 객체 지향의 고유한
특성인 상속기능을 더욱 풍부하게 한다. 좀
더 구체적으로 살펴보면 추상화 클래스는 표현하고자 하는 일반개념의
가장 추상화된 표현이다. 가령,
원이나 직선,
사각형 등 각종 도형을 그린다고
할 때 이들 도형을 그리는 작업에서 가장 공통적인 것들이 존재한다.
이러한 공통적인 것이 추상화
클래스가 된다. 다음
[그림1-8]은
추상화 클래스의 대표적인 예에 대한 그림과 실제 클래스의 예이다.

[그림1-8]
추상화 클래스와 구체화 클래스
[그림1-8]에서
shape라는
클래스는 원이나 직선, 사각형
같은 다른 클래스에서 공통적으로 필요로 하는 인터페이스 메소드를
제공한다. 다시
말해 추상화 클래스는 항상 다른 클래스의 기본 클래스로서 가장 상위에
위치한다. 다음은
추상화 클래스의 몇 가지 특징을 정리한 것이다.
- 추상화 클래스는 다른 클래스의 토대 클래스(base class)로서만 사용된다.
- 추상화 클래스는 함수의 반환 타입이나 매개변수로서 사용될 수 없다.
- 추상화 클래스는 극명한 타입 변환에 사용될 수 없다.
- 추상화 클래스에 대한 포인터 선언과 참조 선언은 가능하나 직접적인
객체 선언은 할
수 없다.
shape myshape; // 잘못됨
shape *myshape_ptr; // 사용가능
shape & returnshap(shape&); // 사용가능
- 만일 순수한 가상 함수가 하나라도 있다면 추상화 클래스이다. 가상 함수에
대한 자세한 내용은
계속 이어진다.
가령, 원
클래스같이 실제 구체적인 구현부분이 포함된 클래스를 구체화 클래스라
한다. 대부분의
구체화 클래스는 그 최상위 클래스에 추상화 클래스를 둔다.
이렇듯 추상화 클래스와 구체화
클래스를 이용하면 잘 디자인된 클래스 계층도를 구성할 수 있으면
일단 잘 구성된 클래스 계층도는 유지,보수
및 확장이 용이하다.
원리이해11 가상
함수(virtual function)
일단 특정 클래스 내부에서 virtual이란
키워드에 의해서 선언된 함수는 특정 클래스의 하위 클래스에서 같은
이름의 함수로 선언될 수 있다는 것을 의미한다.
가령, [그림1-8]에서
처럼 shape클래스의
draw()함수는
가상 함수로 선언되었는데 그 하위 클래스인 circle에서
같은 이름의 draw()함수의
선언이 가능하다. 그러나
실제 가상 함수는 그 사용에 있어서 프로그램의 수행시간에 호출하는
객체의 타입에 의해서 결정되기 때문에 다양하게 사용될 수 있다.
예를 들면,
원을 그릴 때는 원클래스의 draw()가,
직선을 그릴 때는 직선클래스의
draw()가
사용될 수 있다. 다음
[예제1-10]은
가상 함수의 사용 예를 보여준다.
<예제1-10> ---> 가상 함수
#include<iostream.h>
class Vclass1{
public: virtual void Vfunction()
{ cout << "Vclass1 called" << endl << flush; }
};
class Vclass2{
public: void Vfunction()
{ cout << "Vclass2 called" << endl << flush; }
};
class Vclass3{
public:void Vfunction()
{ cout << "Vclass3 called" << endl << flush; }
};
void main()
{
Vclass1 V1, *V1_ptr;
Vclass2 V2;
Vclass3 V3;
V1_ptr = &V1;
V1_ptr->Vfunction();
V1_ptr = &V2;
V1_ptr->Vfunction();
V1_ptr = &V3;
V1_ptr->Vfunction();
}
------ 실행결과 ------
Vclass1 called
Vclass2 called
Vclass3 called
가상 함수의 선언시 일단 최상위에서
virtual로
선언되면 하위 클래스에서 다시 선언할 필요는 없다.
[그림1-8]의
오른편에서 draw()가상
함수는 순수한 가상 함수라 하는데 이 말은 실제 함수의 실행부분
없이 초기화된 형태를 말한다. 다음은
가상 함수를 사용할 경우 주의해야 할 사항들이다.
- 가상 함수는 호출하는 객체의 타입에 의존한다. 그러나 다른 함수의 경우
객체를 의미하는 포인터와 참조에 의존한다.
- 가상 함수는 항상 멤버 함수여야 한다. 즉 전역 함수는 가상 함수가 될 수 없다.
- 가상 함수는 정적
멤버(static member)이면
안된다. 왜냐하면
가상 함수는 객체의 타입에 따라 동적으로 결정되기 때문이다.
원리이해12 템플릿(Template)
템플릿은 전문적인 객체 지향 용어로
파라메터라이즈 타입(Parametrixed Types)으로
불린다. 좀
더 쉽게 말하면 복수 개의 객체에 대한 공통의 연산을 중복되지 않고
하나의 클래스 선언으로 보장하는 기능을 의미한다.
가령, 다음의
예를 보자.
int max(int x, int y)
{
return (x>y) ? x : y;
}
int max(long x , long y)
{
return (x>y) ? x : y;
}
이 경우 두개의 max()함수는
입력인자와 반환 값이 다를 뿐 그 처리 과정상의 코드는 똑같다.
이 경우 2개의
함수를 동시에 선언하여 사용해도 가능하다.
왜냐하면 원리이해14에서
배우게 될 오버로딩기능이 이를 지원하기 때문이다.
그러나 템플릿 기능을 이용하면
다음과 같이 단 한번만으로도 가능하다.
template <class T>
T max( T x , T y)
{
return (x>y) ? x : y ;
}
템플릿을 선언하려면 사용자는 template란
키워드를 사용하면 된다. 또한
사용될 매개변수와 각종 자료형은 T라는
것으로 표현된다. 이
T는 실제
컴파일러에 의해서 사용되는 자료형에 적합한 형태의 함수를 불러주게
된다. 실제
필자의 경우 템플릿을 아주 필요할 경우가 아니면 사용하지 않는 데
그 이유는 실제 컴파일러는 템플릿을 지원하기 위해 각기 지원하는
자료형에 맞는 일련의 함수를 미리 컴파일하여 갖고 있어야 하기때문에
컴파일시 상당한 시간이 걸리며 디버깅이 어렵기 때문이다.
그러나 이 템플릿 기능은 자료형에
종속되지 않는 함수나 클래스를 구현할 때 아주 유용하다.
다음은 템플릿을 이용한 클래스의
구현 예이다.
<예제1-11> ---> 템플릿 클래스의 사용 예
//
// 이 파일은 템플릿을 이용한 스택의 구현 함수이다.
//
#include <iostream.h>
template<class T>
class stack{
T* v;
T* p;
int sz;
public :
stack(int s) { v = p = new T[sz = s]; }
~stack() { delete[] v; }
void push( T a ) {*p++ = a;cout <<"---"<< a << "\n"; }
T pop() { return *--p; }
int size() const { return p - v; }
};
void main()
{
int result;
int i;
char* result1;
stack<int> si(100);
stack<char*> sc(100);
for(int j=0; j <= 3; j++) {
cout << "input integer:";
cin >> i;
si.push(i);
}
for(int k=0; k <= 3;k++) {
result = si.pop();
cout << result << endl << flush;
}
}
------ 실행결과 ------
input interger:10
---10
input interger:20
---20
input integer:30
---30
input integer:40
---40
40
30
20
10
원리이해13 동적
바인딩(dynamic binding)
동적 바인딩이란 말은 말 그대로 프로그램의
실행중에 실제 바인딩 작업이 이뤄지는 것을 말한다.
일반적으로 특정 변수의 타입은
프로그램의 컴파일 시간에 결정된다. 이
경우를 정적 바인딩이라 한다. 정적
바인딩과는 달리 프로그램의 실행시간에 타입이 결정되는 동적 바인딩은
변수나 연산자에서 필요한 타입을 동적으로 결정함으로서 프로그램의
실행에 많 은 유연성을 부여한다. 실제
프로그램을 작성하다 보면 하나의 연산자 이름으로 그 대상이 되는
객체의 타입에 따라 다른 연산으로 적용되는 것이 바람직한 경우가
많다. 예를
들어 멀티미디어를 다루는 응용 프로그램에 서 미디어를 보여주는
display()라는
연산자를 작성한다고 해보자. 정적
바인딩만을 지원하는 경우 각 미디어의 타입에 맞추어 각자 미디어를
보 여주는 display()에
관련된 연산자를 작성해야 한다.(각기
다른 이름으로) 그러나
동적 바인딩을 제공하면 하나의 연산자인 display()를
최상위 클래스에 정의하고 그 하위 클래스에 각기 미디어의 특성에
맞는 display()를
작성하면 실행 시간에 자동적으로 각 미디어에 적합한 display()가
호출되도록 할 수 있다. 이렇듯
하나의 메소드 이름인 display()로
여러 미디어를 보여주는 메소드를 재정의하여 사용하는 것을 중복(overroading)이라고
한다. 또한
앞서 원리이해11에서
살펴본 가상 함수도 동적 바인딩의 한 예이다.
원리이해14 중복(overloadding)
중복은 앞서 살펴본대로 동적 바인딩의
구체적인 예이다. 이
중복 기능은 크게 다음의 2가지
형태로 분류된다.
- 함수 중복
함수 중복의 경우 일반적으로 사용자가 동일한 이름을 갖는 복수 개의 함수를 정의하는
것을 의미한다.
- 연산자 중복
연산자 중복은 + , - , * 같이 시스템에서 제공하는 연산자에 사용자가
원하는 기능을
부가하여 사용하는 것을 말한다.
함수 중복과 연산자 중복 모두 프로그램이 수행되는 시점에 각 함수가 결정되어 수행된다는 점에서 사용자는 이 기능을 이용하여 좀 더 유연성있는 코드를 작성할 수 있다. 이 말은 좀 더 해결하고자 하는 문제를 쉽게 표현할 수 있는 기능을 제공한다는 말도 포함하고 있다. 좀 더 이 부분을 자세히 살펴보자.
- 함수 중복
함수 중복은 지금까지 자주 보아왔던
것과 유사하다. 즉,
같은 이름의 복수 개 함수의 선언을
의미한다. 이
때 주의할 것은 만약 함수의 이름과 인자가 같은 경우 컴파일러는
처리하지 못한다는 사실이다. 왜냐하면
타입과 이름이 같다면 동일한 함수로 인식하기 때문이다.
다음은 그 사실을 보여준다.
print(char *lastname);
print(char* firstname); // 에러
발생, 함수이름과
인자가 같음
insert(char* firstname);
insert(char* firstname, char* lastname); // 에러없음
다음은 함수 중복을 사용한 프로그램의
예이다.
<예제1-12
>---> 함수 중복의 사용
#include<iostream.h>
class person {
int age;
char* firstname;
char* lastname;
public:
person(){};
person(int,char*);
person(int,char*,char*);
void print();
void print(int);
};
person::person(int Age,char* first)
{
age = Age;
firsrname = new char[strlen(first)+1];
strcpy(firstname,first);
lastname = new char[strlen("NONE")+1];
strcpy(lastname,"NONE");
}
person::person(int Age,char* first, char* last)
{
age = Age;
firsrname = new char[strlen(first)+1];
strcpy(firstname,first);
lastname = new char[strlen(last)+1];
strcpy(lastname,last);
}
person::print()
{
cout << "last name:\t" << lastname << endl;
cout << "first name:\t" << firstname << endl;
cout << " Age:\t\t" << age << endl;
}
person::print(int Age)
{
age = Age;
cout << "last name:\t" << lastname << endl;
cout << "first name:\t" << firstname << endl;
cout << "changed age:\t" << age << endl;
}
void main()
{
person *p1 = new person(10,jackson);
person *p2 = new person(10,mickle,jackson);
p1->print();
p2->print(20);
}
<예제1-12>에서는
하나의 person클래스에
대한 생성자를 3개,
print라는 메소드를 2개
작성하였다. 컴파일러는
이 경우 함수의 인자가 다르기때문에 다른 함수로 인식해서 처리한다.
생성자나 print같은
함수 작성법을 함수 중복이라 한다.
- 연산자 중복
연산자 중복은 시스템에서 제공하는 연산자에
대한 중복기능을 의미한다. 가령,
대표적인 C++
헤더 파일중 하나인 complex.h를
보면 복소수를 처리하기 위한 클래스를 볼 수 있다.
가령, 두
개의 복소수를 합할 경우 일반적으로 다음과 같이 하나의 수에 다른
수를 더하게 할 수 있다.
a.add(b) 또는
b.add(a)
그러나 연산자 중복을 이용하면 다음과 같이 표현할 수 있다.
a + b
이 표현은 일반적으로 사용하는 덧셈에
대한 표현과 동일하다. 이
기능을 이용하면 얼마든지 프로그래머가 만든 클래스형에 대한 연산수식을
가능하게 한다. 다음
[표1-2]는
C++에서
연산자 오버로딩이 가능한 연산자이다.
+ - * / % ^ & | ~ ! = < > += -+ *=
/= %= ^= &= |= << >> >>= <<= == != <=
>= && || ++ -- [] () new delete
[표1-2
] C++에서 중복 가능한 연산자
먼저 연산자 중복에는 일정한 선언방식이
있는 데 그 선언방식은 다음과 같다. 예를
들어, +연산자는
두 person객체의
이름을 하나로 붙이는 데 사용할 수 있다.
반환타입 객체명::operator 연산자();
예)
void person::operator+(char* name);
다음 <예제1-13>은
연산자 중복의 실제 사용 예이다.
<예제1-13>]
---> 연산자 중복의 예
#include <iostream.h>
class Point {
int X,Y,Z;
public:
Point(){};
Point(int x,int y,int z){ X=x; Y=y; Z=z;}
Point operator+(Point);
Point operator-(Point);
Point operator=(Point);
Point operator++(Point);
void print();
};
Point Point::operator+(Point p)
{
Point tmp;
tmp.X = X + p.X;
tmp.Y = Y + p.Y;
tmp.Z = Z + p.Z;
return tmp;
}
Point Point::operator-(Point p)
{
Point tmp;
tmp.X = X - p.X;
tmp.Y = Y - p.Y;
tmp.Z = Z - p.Z;
return tmp;
}
Point Point::operator=(Point p)
{
X = p.X;
Y = p.Y;
Z = p.Z;
return *this;
}
Point Point::operator++(Point p)
{
X++;
Y++;
Z++;
return *this;
}
void Point::print()
{
cout <<"X , Y , X" << endl;
cout << X << "," << Y << "," << Z << end;
}
void mail()
{
Point P1(10,10,10);
Point P2(20,20,20);
Point P3(30,30,30);
P1.print();
P2.print();
P3.print();
P3 = P1 + P2;
P3.print();
P3 = P2 - P1;
P3.print();
P3 = P2 = P1;
p3++;
P3.print();
}
앞선 <예제1-13>에서는
몇 가지 기본적인 연산자에 대한 중복만을 소개했다.
연산자 중복시 주의해야 할 점은
연산자 의미를 정확히 사용해야 한다는 점이다.
가령, +의
중복시 그 기능에 *기능을
넣는다면 그 모든 책임은 프로그래머가 져야 한다.
(참고)===================================================================
C와 C++
컴퓨터를 능숙하게 다루게 되면 이용하던 프로그램들이 제공하는 기능보다 더 많은 바램이 생기는 것은 당연한 이치이다. 마찬가지로 지금까지 일반적으로 응용 프로그램 개발 시 가장 많이 애용되던 언어는 C 언어였다. 물론 지금까지도 C 언어가 보편적으로 가장 널리 사용되고 있다. 80년대 초 C 언어가 각광받던 시기에 이 언어는 이식성과 효율성이 좋고 유연하며 강력하다는 등의 화려한 수식어구속에서 급속히 퍼져나갔다. 특히, UNIX OS가 C 언어로 만들어 지면서 더욱 유명해졌다. 이러한 장점들 외에 C 언어가 각광받을 수 있었던 이유는 그 동안 수 많은 개발자와 프로그래머들 사이에서 문제를 해결하기 위한 방법으로 사용되어 왔던 절차 지향 사고 방식과 C 프로그램의 프로그램 기술방식이 일치한다는 것이다. 그 동안 컴퓨터 개발분야에서 지존의 자리를 지키던 C 언어와 절차 지향 사고 방식이 사라지면서 새로운 개발 방식인 객체 지향 방식과 이 방식의 구현 언어인 객체 지향 언어로서 C++이 등장한 것이다.
C++의 족보
C++은 80년대초 AT&T 벨 연구소의 자네 스트라스트럽(Bjarne Stroustrup)이 사건 추진 모의실험(Event-driven simulation)을 하기위해 Simula67에서 클래스 개념을, Algol 68에서 연산자 중복(operator overloading)과 프로그램 코드내에 변수선언이 가능하게 하는 기능을 가져오고 기존의 C언어를 확장한 변종(hybrid) 객체 지향 언어로서 탄성했다. 이 변종이란 말은 기존의 C같은 비객체 지향 언어에 객체 지향을 수용함을 강조한 말이다. 물론 Simula, Smalltalk, Actor, Eiffel같은 순종 객체 지향 언어도 존재한다. 순종 객체 지향 언어에서는 비객체 지향 방식의 코드 작성이 불가능하고 프로그램 수행시 효율이 떨어진다.
 [ 그림1-9 ] C++의 가계도
보다 나은 C로서의 C++
앞서 살펴온 것을 종합해 보면 C++언어는 기존의 C언어에 객체 지향 개념을 도입한 것처럼 보인다. 사실 맞는 말이다. 그러나 C++은 기존의 C언어에 보다 향상된 기술을 제공하였다. 결국 C++은 향상된 C에 객체 지향 개념을 첨가한 언어라는 말이 정확한 답일 것이다. 자 이제 좀더 구체적으로 향상된 C로서의 C++을 살펴보자.
프로그램을 하다 보면 가장 자주 쓰는 기능들 중 하나가 주석을 다는 것이다. C에서는 프로그래머가 /* */ 를 사용하여 주석을 달았다. 물론 이 구문도 C++에서 사용할 수 있다. C++에서는 이 주석외에 한 줄 주석 기능을 제공하는 데 //을 사용한다. 다시 말해 //이후부터 그 줄 끝까지는 주석을 의미한다. 단 주석의 범위는 한 줄을 초과하지 않는다. /*와 */사이의 //는 무시되며 마찬가지로 // 이후의 /* */도 무시된다. 다음의 예는 이 두가지 주석의 사용 예이다. /* 특정 정보를 // 무시됨 다스플레이 하는 함수 */ display( struct person* ) { printf... // print name /* 무시됨 */ ... } // end of function
C프로그램을 할 경우 간단하면서도 빠른 수행을 요구하는 함수를 만들 때 매크로를 주로 이용한다. 그러나 이 매크로는 다음의 단점들이 있기 때문에 가급적이면 사용되지 않았었다. 먼저, 매크로는 인자(Argument)를 검사할 수 없기 때문에 디버깅을 할 수 없다. 따라서 생각치 못한 버그를 유발할 수 있다. 또한 매크로에서는 증가연산자의 사용시 생각치 못하는 결과를 유발할 수 있다. 다음은 C에서 매크로의 사용 예이다. #define sqr(a) (a * a) sqr( 1 + 2 ); // 1 + 2 * 1 + 2로 치환되어 5가 된다. sqr( i++ ); // i++ * i++ 로 되어 2만큼 증가한다. 이러한 맹점을 해결하고자 C++에서는 inline함수를 지원한다. inline 함수는 함수가 불리워진 곳에 함수의 코드가 직접 대입되어 프로그램의 수행시 스택 조작같은 연산을 줄여 수행속도를 높일 수 있다. 단 프로그램의 크기가 커질 수 있다라는 흠이 있다. 만일 inline함수를 사용할 경우 다음의 제약을 기억해야 하며 가급적 작고 많이 사용되는 함수에 이용하는 것이 좋다. - 호출되기 전에 미리 정의되어야 한다. - 재귀 호출은 허용되지 않는다. - 함수 포인터는 존재하지 않는다. - 한 수식 내에서 두 번 이상 호출되지 않는다. - while, for, goto, switch 문을 사용할 수 없다. 다음은 위의 C 매크로를 inline함수를 이용하여 작성한 예이다. inline int sqr(int i ) { return ( i * i ); } int main(void) { sqr( 1 + 2 ); // 9를 반환한다. }
C++에서는 const상수를 선언할 수 있다. 이 상수는 프로그램의 실행중에는 변하지 않는다. 기존의 C에서는 "#define size 10" 와 같이 const상수를 정의하였다. 그러나 C++에서는 "const int size = 10;"와 같이 정의 할 수 있다.
C에서 변수를 사용하기 전에 첫번째 문 이전에 선언돼야 한다. 그러나 C++에서는 문중 어느 곳에서나 선언하여 사용할 수 있다. C에서의 변수 선언 C++에서의 변수 선언 int i,j; int i = 0; char *cp; char *cp = " Park gildong "; ..... int j = strlen(cp); cp = " Park gildong "; j = strlen(cp) ; ....
C에서 자료형을 검사하기 위해서는 변수의 데이타 타입을 포함한 함수선언을 미리 해야 한다. 가령, char를 원하는 곳에 char*가 넘어갈 경우, 프로그램의 실행시에 "segmentation fault"라는 끔찍한 메세지를 보게 된다. 그러나 C++의 경우 인수의 데이타 타입을 엄격히 검사하며 만약 불일치하더라도 자동으로 변환이 가능하면 변환하여 처리한다. DoubleMul( 2, 3 ); // 정수인 2,3은 자동으로 2.0 , 3.0으로 변환된다. double DoubleMul( double i, double j ) { return(i * j); } 만약 C에서 정수형을 플롯형으로 변환하려면 float f ; int i; f = (float) i; 라고 명시해야 한다. 그러나 C++에서는 다음과 같이 사용할 수 도 있다. int i = 1; float f = float(i); 이것은 float 클래스의 생성자에 의한 것이다.
C++에서는 같은 이름을 갖은 2개 이상의 함수를 정의할 수 있다. 단 이 함수는 인자의 개수와 타입이 같아서는 안된다. 왜냐하면 C++은 타입검사가 엄격할 뿐만 아니라 검사시 타입뿐 만 아니라 개수도 검사하기 때문이다. 따라서 같은 이름의 함수가 같은 개수와 타입의 인수를 갖으면 에러가 발생한다. 다음은 적절한 사용 예이다. int multiply( int i , int j) { return i * j; } -------------------> (1) double multiply( double di, double dj ) { return di * dj; } -------------------> (2) ...... multiply( 10, 10 ); --------------------> (1) 호출 multiply( 10.0, 10.0 );--------------------> (2) 호출
이 기능은 C에 익숙한 사용자들에게 있어 가장 생소한 부분중의 하나라고 생각된다. 기존의 C에서는 값에 의한 호출과 포인터를 이용하여 참조에 의한 호출을 제공했다. 따라서 참조에 의한 호출인 경우 포인터를 사용하는 것을 일일이 기억하고 실제 변수를 넘길 때 &를 붙여주어야 한다. 그러나 C++에서는 직접 refrence(&)를 매개변수로 넘김으로서 이를 간단하게 해결할 수 있다. 다음은 전통적인 두 정수의 값을 교환하는 swap함수의 C와 C++의 구현 예이다. - C에서의 swap - C++에서의 swap #include <stdio.h> #include <iostream.h> swap( i, j) swap( int &i, &j ) int *i,*j; { { int tmp = i; int tmp; i = j; tmp = *i; j = tmp; *i = *j; } *j = tmp; int main(void) } { main() int a=1, b=2; { swap(a,b); int a = 1, b = 2; return TRUE; swap( &a, &b ); } } 이 기능은 프로그램을 간편하게 할 뿐만 아니라 진정한 의미에서 call by reference 를 구현한 기능이라 할 수 있다. 또한 이 기능은 여러 개의 포인터로 인한 낭비를 막아 주는 역할도 한다. 또 하나 기억해야 할 것인 reference로 선언한 변수는 선언 즉시 초기화해야 한다. 즉, int &age; 의 경우 에러가 발생한다. 선언과 동시에 초기화되기 않았기 때문이다. 따라서 int &age = myAge; 처럼 선언과 동시에 존재하는 실체로 초기화를 시켜주어야 한다.
C++에서는 선언된 변수에 지정값(Default value)을 갖게 할 수 있다. 이때 지정값을 갖는 변수는 뒤부터 선언되어야 한다. 예를 들면 다음과 같다. myShow( 100 ); int myShow( int age, char* ="Hong GilDong", int tel = 820 ) { ..... } 이 경우 myShow는 age가 "100"이고 나머지는 지정된 값의 매개변수가 넘겨진다. 마지막으로 강조하는 점은 지정값을 갖는 변수는 뒤부터 선언해야 한다는 것이다.
C++은 C에서
사용하는 printf()나
scanf()와
달리 진보된 입출력 메카니즘을 제공한다. 실제
C를 사용하는
사용자는 자신이 입력하거나 출력하고자 하는 형태를 알고 이를 명시해야
한다. 그러나
C++에서는
그런 자세한 정보 없이도 입.출력이
가능하다. 좀
더 자세히 말하면 C++에서는
stream이라는
개념을 지원하여 출력을 위해 cout 클래스를
, 입력을
위해 cin을,
표준 에러조작을 위해 표준 출력인
cerr을 제공한다.
사용자는 이 클래스에 C++입력
연산자인 >>, 출력
연산자인 <<를
사용하여 원하는 내용을 입,출력할
수 있다.
가령, 아래와 같이 C로 작성을 하려면 해당 입,출력 형태를 정확히 알고 있어야 한다. #include <stdio.h> main() { int age; char name[30]; printf("input your age ! : \n" ); scanf("%d", age); printf("input your name( < 30) \n"); scanf("%s", name); printf("your name is %s and age is %d", name, age ); } C++로 재작성하면 다음과 같다. 아래의 예에서 endl은 newline을 의미한다. #include <iostream.h> // 표준 입출력 헤더 파일 main(void) { int age; char name[30]; cout << " input your age !:"; << endl; cin >> age; cout << " input your name(<30) "<< endl; cin >> name; cout <<" your name is" << name <<and your age is<< age << endl; } 이러한 기능이 가능한 것은 C++의 객체 지향 개념중 하나인 연산자 중복( Operator Overloading )을 통해서이다. 연산자 중복은 함수의 이름을 중복해서 사용할 수 있는 것처럼 +,-,/ 같은 연산자에 자신이 원하는 기능을 정의하여 사용할 수 있는 기능이다.
C++에서 ::연산자는 실제 클래스를 정의할 경우 그 클래스에 소속된 것들을 지칭하는 데 주로 사용된다. 다시 말해 범위를 명시하는 데 사용된다. 그러나 이 뿐만 아니라 특정 범위내에서 전역변수를 지칭하는 경우에도 사용된다. 다음의 예를 보면 그 사용을 정확히 알 수 있다. printAge() { int myAge = 18; // 전역변수 ( global variable ) for( int i =0; i < 2 ; i ++ ) { int myAge = 20; // 지역변수 ( local variable ) myAge++; // 지역변수 증가 ::myAge++; // 전역변수 증가 cout << "My Age" << myAge << endl; // 지역변수 출력 } cout << "My Age" << myAge << end1; // 전역변수 출력 }
C나 C++이나 특정한 변수에 원하는 메모리를 할당하고 이를 사용한 후 반환해야 한다. 그러나 C의 경우 원하는 타입이나 크기 등의 정보를 알고 malloc() 이나 alloca()등의 함수를 호출한 후 free()함수를 통해 반환한다. 그러나 C++에서는 new, delete를 제공하여 메모리 관리를 더욱 원활하게 해준다. 먼저 new는 시스템의 메모리 힙으로부터 메모리를 할당받고 delete는 할당받은 메모리를 돌려주는 역할을 한다. 가령, C에서 문자형 포인터 변수 c에 메모리를 할당하기 위해선 다음과 같이 작성해야 한다. char* c = (char*)malloc(size); // 메모리 할당 free(c); // 메모리 해제 그러나 C++에서는 다음과 같이 간단하게 메모리를 생성, 해제할 수 있다. char* c = new char(size); // 메모리 할당 delete c; // 메모리 해제 아울러 할당받은 메모리는 반드시 시스템에게 돌려주어야 한다는 사실을 기억하자.
=====================================================================
1막을 마치며
1막에서 우리는 기존의
사고방식이었던 구조적 패러다임의 문제점들과 이 문제점들에 대한
해결 방안으로서 등장한 새로운 패러다임인 객체 지향에 대해 살펴보았다.
특히, 우리는
클래스, 객체,
상속, 생성자,
연산자 오버로딩처럼 객체 지향
패러다임에서 제공하는 다양한 기능을 C++ 객체지형
언어를 통해 살펴봄으로서 보다 실제적으로 객체 지향 개념이 무엇인지
배울 수 있었다.
[ 다음 | 이전 ]