두번째 마당.
객체 프레임웍(CORBA)의
이해
3막
CORBA 표준
이해
1장 OMG와
OMA, CORBA
1.1 분산
객체 시스템의 태동 배경
사용자들은 생산성있는 응용 프로그램을 원할 뿐만 아니라 파일이나 데이터베이스처럼 다양한 데이터 저장공간으로 부터 정보를 얻길 원한다. 뿐만 아니라 다른 사용자들과 자료를 공유하고 서로 통신하길 원하고 있다. 이렇듯 다양한 요구사항을 만족시키는 프로그램을 작성하기 위해서는 서로 다른 운영체제와 네트웍 환경 등 이종의 환경하에서 작동가능한 클라이언트/서버 소프트웨어를 개발해야 할 뿐만 아니라 개발된 소프트웨어는 분산 환경에서 서로 다른 시스템과도 쉽게 통합할 수 있어야 한다. 그러나 이러한 요구사항을 만족시키는 소프트웨어를 작성하기란 결코 쉽지 않다. 특히, 이종의 분산 환경에서 여러 종류의 응용 프로그램을 통합하기 위한 결합 방식을 필요로 한다.
우리는 지금까지 이러한 문제를 해결하는
고급 방법으로 기존의 RPC(Remote
Procedure Call)방식이나 마이크로소프트의
OLE(Object Linking and Embedding)같은
방식을 사용해왔다. 그러나
RPC의
경우 기존의 구조적 패러다임을 기반으로 하기 때문에 아주 복잡하고
규모가 큰 프로그램을 작성하는 데 있어 많은 한계가 있다.
또한 OLE의
경우에도 윈도우 객체들만의 호환을 지원하기 때문에 진정한 분산
시스템 표준이라고 말하기 어렵다.
그러나 이러한 문제들을 해결할
수 있는 방식으로 대두된 것이 OMG(Object
Management Group)에서 제정한
CORBA(Common Object Request Broker
Architecture) 표준안이다.
1.2 OMG의
활동
OMG는
1막
2장에서
언급한 것 처럼 1984년
설립된 컴퓨팅 관련 회사들의 컨소시엄이다.
현재 700여
개의 업체들이 참가하여 CORBA표준을
확장 중에 있다. 사실
엄밀히 말해, CORBA는
OMG에서
제안한 OMA(Object Management
Architecture)표준의 일부이다.
OMA는 분산 환경하에서 필요로
하는 전반적인 객체 솔루션을 제공한다.
이에 반해 CORBA는
OMA의
일부분으로서 주로 분산 환경하에서 객체간의 통신 기능과 이를 조작하는
데 필요한 기능들을 주로 언급하고 있다.
마찬가지로 ORB는
CORBA 표준안에서
주로 통신 부분만을 담당하고 있다.
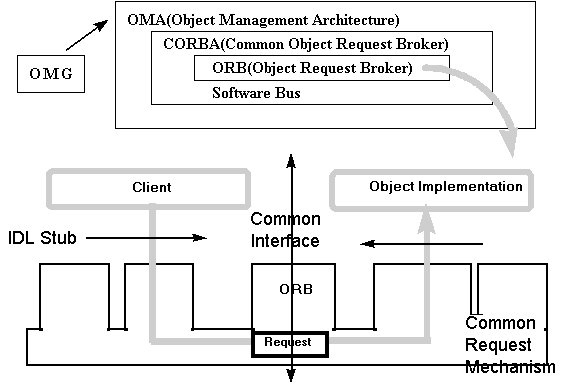
[ 그림3-1
] 은 OMG
에서 발표한 OMA
와 CORBA
, ORB사이의 관계를 표시한 것이다.
실제 그림에서 처럼 CORBA
는 OMA의
한 부분이고 ORB는
CORBA 의
핵심기술을 말하는 것이다. 따라서
ORB는
CORBA 클라이언트와
구현 객체(Object Implementation)사이의
통신 역할을 담당한다. OMG와
CORBA, ORB에
대해서는 뒤에서 자세히 살펴본다.
현재 OMG는
1990년
OMA를
발표한 이래 지금까지 CORBA2.0
명세를 발표하였으며 3.0
명세를 논의 중에 있다.
[
그림3-1
] OMG , OMA , CORBA의 관계
다시 OMG에
대해 관심을 돌려보자. OMG는
특정 표준을 제정하거나 소프트웨어를 개발하는 회사가 아니라 컨소시엄에
가입한 회사들이 제출한 명세를 관리하고 처리하는 역할만을 수행한다.
따라서 OMG는
다양한 기술 문제를 손쉽게 제출하고 관리하기 위한 조직을 갖고 있다.
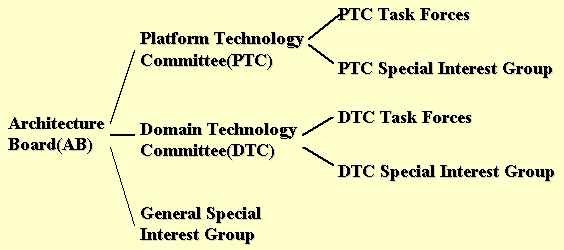
현재 OMG의
조직 구성은 [ 그림3-2
] 과 같다.
이 그림에서 OMG의
각 기술 위원회는 해당 기술 명세를 아키텍쳐 보드(AB)에
제출한다. AB는
두개의 기술 위원회인 플랫폼 기술 위원회(PTC)와
도메인 기술 위원회(DTC) 와
관심사항 그룹(SIGs)으로
이루어져 있다. 각
위원회에서 수행하는 일들은 다음과 같다.
PTC는
CORBA자체의
하부 기술들에 대한 표준 명세를 작성하는 일을 진행한다.
여기서 진행하는 일과 하위 그룹들은
다음과 같다.
ORB/Object Service Task Force(OSTF)
Common Facilities Task Force(CFTF)
Object Analysis and Design Task Force(OADTF)
Internet Special Interest Group(ISIG)
Japan Special Interest Group(JSIG)
Real-Time Special Interest Group(RTSIG)
DTC는
다양한 현실 세계에서 CORBA를
기반으로 하는 응용 분야에 대한 명세를 작성하는 일을 진행한다.
여기서 진행하는 일과 하위 그룹들은
다음과 같다.
- CORBAmed Task Force : 의료 분야에 대한 솔루션
- Telecommunications Task Force(CORBAtel) : 통신분야에 대한 솔루션
- Manufacturing Domain Task Force(CORBA manufacturing) : 공장 제어 분야에 대한 솔루션
- Financial Domain Task Force(CORBA financial) : 은행 분야에 대한 솔루션
- Interactive Multimedia & Electronic Commerce Domain Task Force : 멀티미디어 서비스에 대한 전자 지불, 사용 권한, 로얄티 등에 대한 솔루션
- Business Objects Domain Task Force(BODTF)
: 웍플로우,
문서 처리를 포함하여 경영 업무
전반에 관한 솔루션
- Transportation Special Interest Group(TSIG)
: 수송 산업에 대한 솔루션
관심사항 그룹(General
Special Interest Group)은 OMG
전반에 걸쳐 연관된 명세에 대해
연구하는 그룹으로서 AB에
직접 명세를 보고한다. 여기서
진행하는 일과 하위 그룹들은 다음과 같다.
[
그림 3-2
] OMG의 조직 구성
1.3 OMA
1.3.1 CORBA 객체
모델
먼저 OMA를
이해하는 데 있어 가장 기본이 되는 것은 바로 객체지향 개념이다.
왜냐하면 OMA가
제공하는 모든 서비스는 객체개념을 기반으로 하기 때문이다.
다음은 OMA의
코아 객체 모델을 정리한 것이다.
인터페이스 같은 부분을 제외하고는
1막에서
살펴본 객체지향 개념과 동일하다.
- 객체 = 애트리뷰트 + 메소드
객체는 프로그램에서 데이터 형을 갖는
변수같은 애트리뷰트(상태)와
함수같은 메소드(행동)로
구성된 일련의 코드를 의미한다.
예를 들어 ,
자동차란 객체는 바퀴와 핸들
등의 애트리뷰트를 갖을 뿐만 아니라 전진이나 후진 등의 메소드도
포함하고 있다.
- 갭슐화(Encapsulation)
갭슐화는 객체를 구성할 때 애트리뷰트와
메소드를 함께 포장한 후 객체의 애트리뷰트에 접근하기 위해서는
해당 객체의 메소드만을 통해서 가능하게 한다.
이 캡슐화는 다른 객체와 해당
객체를 추상적으로 구분할 수 있게 해준다.
따라서 고도의 모듈화가 가능하다.
- 다중성(Polymorphism)
다중성이란 하나의 메소드 이름으로 여러
개의 서로 다른 기능을 제공하는 메소드를 만들 수 있는 기능을 의미한다.
예를 들어 ,
Insert( int ) , Insert( char* ) 처럼
같은 이름으로 서로 다른 기능을 하는 메소드를 작성할 수 있다.
- 상속 , 상위 클래스 , 하위 클래스
상속이란 한 클래스가 갖고 있는 애트리뷰트와
메소드를 특정 클래스가 물려받는 관계를 말하며 이때 물려주는 클래스를
상위 클래스 , 물려받는
대상이 되는 클래스를 하위 클래스라고 한다.
예를 들어 ,
트럭같은 클래스는 자동차 클래스의
애크리뷰트와 메소드를 상속받을 수 있다.
왜냐하면 자동차는 트럭에 필요한
애트리뷰트와 메소드를 포함하고 있기 때문이다.
이때 자동차 클래스를 상위 클래스
, 트럭
클래스를 하위 클래스라고 한다.
- 인터페이스
인터페이스는 C++에서
클래스와 유사한 것이다. 하지만
인터페이스는 클래스와 달리 특정 객체를 생성하지 못한다.
다시 말해,
인터페이스는 단지 클라이언트와
구현 객체사이의 인터페이스 정의만을 포함한다.
따라서 실제 구현 코드를 갖지
않는다. 이
점을 제외하고는 C++의
클래스와 동일하다. 인터페이스에
대해서는 IDL을
다루는 다음 막에서 보다 자세히 다룬다.
1.3.2 OMA
이미 어느 정도 이해하겠지만 CORBA는
네트웍상에 위치한 클라이언트 객체와 구현 객체사이의 통신을 담당하는
역할을 한다. 이
역할만으로는 실제 업무에서 필요로 하는 모든 기능을 제공하지 못한다.
이에 반해 OMA는
CORBA의
기능을 포함하여 실제 업무에서 필요로 하는 모든 객체 기술을 하나의
프레임웍으로 제공한다. 실제,
이 프레임웍이 바로 OMG에서
목표로 하고 있는 현존하는 모든 객체 기술을 기반으로 한 통합 기술이자
OMG가
지향하고 있는 객체 기술에 대한 미래이다.
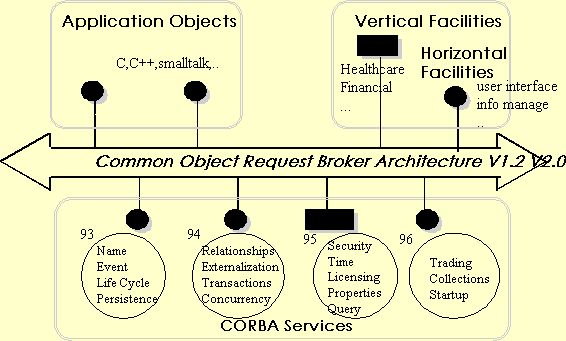
OMA는 [그림3-3]과
같은 구조로 이루어져 있다: 객체간의
통신을 담당하는 CORBA를
중심으로 시스템을 구축할 때 필요로 하는 모든 기능들을 제공하는
CORBA 서비스(Services)
계층과 은행이나 항공 분야 등
특정 도메인상에서 시스템을 구축할 때 필요로 하는 기능들을 제공하는
CORBA 지원(facility)
계층으로 나뉜다(
계속해서 CORBA
서비스와 지원 기능에 대해서
자세히 다룬다). 그리고
마지막으로 최종 사용자들이 이용하게 될 응용 프로그램 객체들이
위치한다. 현재
CORBA에
대한 표준은 사실상 마무리된 상태이다.
하지만 CORBA
서비스와 CORBA
지원 기능들은 계속해서 추가되고
있는 상황이다. CORBA 서비스의
경우 CORBA 공급업체나
제3의
업체에 의해서 개발되고 있으며 CORBA
지원 기능의 경우 OMG의
도메인 기술 위원회(DTC)에서
해당 분야에 대한 방법론을 작성하고 있다.
OMA의 각 부분에 대해서는 뒤에서
보다 자세히 다루도록 한다.
[ 그림3-3
] OMA(Object Management Architecture)
2장.
CORBA 2.0의 이해
2.1. ORB(Object Request Broker) 구조
이해
ORB는
[그림3-4]에서
처럼 클라이언트와 구현 객체사이의 중계자 역할을 수행하는 여러
가지 컴포넌트와 인터페이스로 구성되어 있다.
ORB를 단정적으로 말한다면 분산된
객체들을 클라이언트/서버
관계로 만들어 주는 핵심적인 객체 미들웨어라고 할 수 있다.
ORB는 클라이언트 객체가 구현
객체의 오퍼레이션을 호출할 때 ORB는
클라이언트의 호출을 받아 자신이 가지고 있는 구현 객체들의 정보를
참조하여 클라이언트가 원하는 구현 객체를 찾고 클라이언트에서 보내
준 서비스 요청 정보를 해당 구현 객체에게 전달하여 해당 객체로
하여금 그 작업을 수행하게 한다.
그리고 작업이 완료되면 ORB는
역으로 그 결과 값을 받아 클라이언트에게 전달하는 역할을 수행한다.
ORB는
이렇게 클라이언트와 구현 객체들을 연결 시켜주는 역할을 해줌으로
써 클라이언트는 구현 객체가 어디에 있든 상관하지 않고 단지 원하는
객체의 오퍼레이션을 간단히 호출할 수 있게 된다.
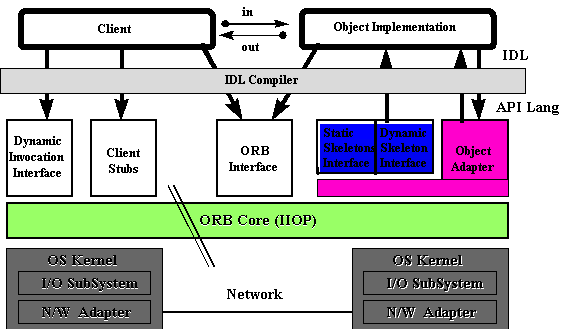
각 ORB
구성 요소들의 기능들은 다음과
같다.
CORBA 객체를
생성할 때 가장 최초의 작업은 클라이언트와 구현 객체 사이의 인터페이스를
IDL이라는
언어로 정의하는 것이다. 그런
다음, 해당
인터페이스들을 IDL 컴파일러를
사용하여 컴파일한다. IDL 컴파일러는
IDL 인터페이스들을
C, C++, 자바,
스몰톡,
코볼 같은 구현 언어로 변환하여
클라이언트에는 스터브를, 구현
객체에는 스켈로턴이라는 통신 코드를 자동으로 생성해 낸다.
여러분은 이들 스터브와 스켈로턴을
클라이언트와 구현 객체가 통신을 하기 위한 프로그램 코드라고 생각하면
된다. 이
코드는 컴파일시 클라이언트와 구현 객체사이의 통신 기능이 확정되기
때문에 이를 정적 IDL 스터브/스켈로턴이라
한다. 클라이언트는
스터브를 이용하여 ORB와
통신을 하며 서버는 스켈로턴을 경유하여 ORB와
통신을 한 후 클라이언트에서 보내온 서비스 요청을 받아들이게 된다.
이 때,
서로 다른 운영체제 하에서 발생하는
데이타 형의 불일치 등은 자동으로 스터브와 스켈로턴에 의해서 처리된다.
CORBA 프로그래머는 이 과정에
신경을 쓸 필요가 없다.
정적 IDL
스터브와 스켈로턴을 이용하여
컴파일시 클라이언트와 구현 객체사이의 호출이 결정되는 것과 달리
CORBA는
프로그램이 실행 중이더라도 호출하고자 하는 구현 객체의 오퍼레이션을
찾고 이를 호출할 수 있는 동적 호출 인터페이스를 정의해 놓았다.
정적 IDL
스터브를 통하여 구현 객체를
호출하는 것은 이미 컴파일시 프로그램내에 정의해 놓은 것을 사용하지만
, 동적
호출은 클라이언트가 직접 필요한 객체의 메소드을 인터페이스 저장소(Interface
Repository)에서 찾아 해당 객체에게
원하는 서비스를 요청할 수 있다.
정적 호출과 동적 호출에 대해서는
뒷 장에서 보다 자세히 다룬다.
ORB 인터페이스는
클라이언트나 구현 객체에서 ORB에서
제공하는 오퍼레이션을 직접 호출하고자 할 때 스터브나 스켈로턴
등의 인터페이스를 통하지 않고 직접 ORB에
접근하기 위하여 제공된 인터페이스이다.
동적 스켈로턴 인터페이스는 스켈로턴과
스터브를 갖고 있지 않은 다른 외부 객체의 메소드를 호출하고자 하는
구현 객체들을 위해 제공되는 메커니즘이며 클라이언트에서 이용하는
동적 호출과 유사한 인터페이스이다.
DSI는 해당 메세지의 매개변수를
통해 해당 객체나 메소드를 찾는다.
이 메커니즘은 ORB와
ORB의
사이의 연결 모듈(브리지)을
구현하거나 COM같은
다른 외부 모듈과의 연결 모듈(게이트웨이)을
구현하는데 매우 유용하다.
ORB 핵심
통신 서비스 위에 위치하고 있으며,
구현 객체 대신에 클라이언트
객체의 서비스 요청을 받아 들인다.
요청을 받아 들인 객체 아답터
은 해당 구현 객체에 객체 참조자(object
reference)를 부여하고 활성화
시키며, 스켈로턴을
통해 해당 메소드를 호출한다.
CORBA 표준을 준수하는ORB들은
반드시 위의 기능을 지원하는 기본 객체 아답터 (
BOA , Basic Object Adapter )를
지원해야 한다.
[그림3-4]에서는
보여지지 않지만 CORBA는
두개의 자체 데이타베이스를 갖는다.
하나는 인터페이스에 대한 정보를
저장하는 인터페이스 저장소라는 데이타베이스이고 다른 하나는 구현
객체의 정보를 저장하는 구현 저장소 데이타베이스이다.
먼저,
인터페이스 저장소를 살펴보자.
CORBA IDL 로
작성된 모든 인터페이스 정보는 인터페이스 저장소에 저장된다.
이곳에 저장된 정보를 사용하여
클라이언트 객체가 제출한 서비스 요청에 대한 인터페이스 정보를
조회할 수 있으며 해당 요청이 정당한지 검사할 수 있다.
( 실제 클라이언트 객체의 서비스
요청은 앞서 살펴본 것처럼 원하는 객체의 메소드 호출을 의미한다.
따라서 이 메소드 호출시 전달되는
파라메터의 타입이 정확한지 검사할 때 인터페이스 저장소를 이용한다.
)
인터페이스 저장소는 다음의 [그림3-5]과
같은 구조로 인터페이스 정보를 관리한다.
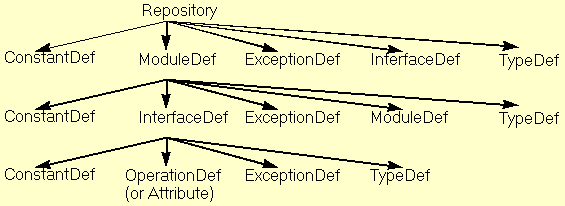
[
그림3-5
] 인터페이스 저장소의 구조
인터페이스 정보와 마찬가지로 구현
객체의 정보도 구현 저장소에 저장된다.
저장되는 정보들로는 구현 객체의
물리적인 위치나 서버 구동 방식,
사용 프로토콜 등 객체 아답터
이 구현 객체를 구동시키는데 필요한 것들이다.
이 정보들은 해당 서비스에 합당한
구현 객체를 구동시키는데 사용된다.
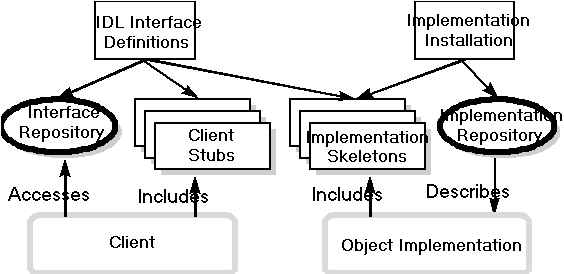
다음 [그림3-6]은
IDL로
작성된 응용 프로그램에서 인터페이스 저장소와 구현 저장소가 사용되는
예이다. IDL로
작성된 인터페이스는 IDL 컴파일러를
통해 컴파일시 인터페이스 정보가 인터페이스 저장소에 저장된다.
또한 최종 작성된 구현 객체에
대한 정보는 구현 저장소에 저장된다.
이렇게 저장된 정보는 각기 클라이언트와
구현 객체가 실행될 때 이용된다.
[ 그림3-6
] IDL 과 인터페이스 저장소,구현
저장소
2.2 CORBA 호출
원리 이해
CORBA를
이해하는 데 있어 객체지향 개념이 가장 기본이 됨을 강조한 바 있다.
또 하나 정확히 이해해야 할 것이
CORBA의
호출 원리를 이해하는 것이다.
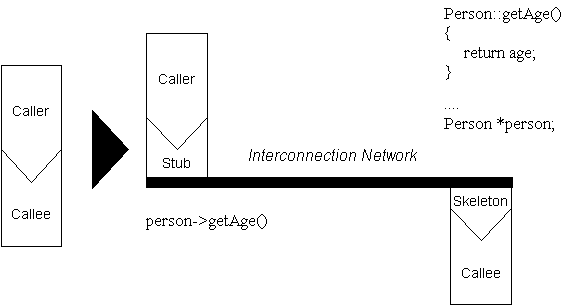
먼저 CORBA
에서 서비스가 호출되는 원리는
[그림3-7]와
같다. 기존의
객체지향 코드에서는 메소드의 호출자와 이에 대한 호출 처리자가
하나의 프로세스로 존재한다.
그러나 만약 메소드의 호출과
이에 대한 처리가 네트웍을 기준으로 양분된다면 어떻게 될까?
실제 이에 대한 대답은 간단하다.
먼저 호출하는 쪽 ,
클라이언트에는 네트웍을 통해
서비스를 호출하고 이에 대한 결과를 전달받는 코드를 작성해 주고
호출 처리자 측 , 구현
객체쪽에서는 네트웍상으로 전달되는 서비스 호출을 받고 이를 처리한
후 다시 클라이언트에게 전달해주는 코드를 작성해 주면 된다.
이러한 기능을 수행하는 코드를
전자는 스터브(Stub)
, 후자는
스켈로턴(Skeleton)이라
한다.
예를 들어,
만약 구현 객체로 Person이라는
클래스를 작성했다고 가정하자.
만약 클라이언트가 Person클래스의
getAge()라는
메소드를 호출할 때 이 호출은 클라이언트측 getAge()
스터브를 통해 원격지의 스켈로턴으로
전달된다. 이
과정에서 스터브는 해당 메소드의 호출에 필요한 각종 정보를 네트웍으로
전달하기 위해 포장(마샬링,
Marshall) 을 해야 한다.
이 포장된 정보는 getAge()의
스켈로턴에 의해서 포장이 풀려지고(언마샬,
Unmarshall) 호출된다.
처리된 getAge()의
결과는 다시 네트웍을 통해 클라이언트 스터브에게 전달되기 위해
포장되고 전달된다. 클라이언트쪽의
getAge() 스터브는
스켈로턴을 통해 넘겨받은 결과의 포장을 풀고 해당 결과값을 처리한다.
실제 이러한 과정을 통해 CORBA
객체의 호출이 이루어진다.
이때 스터브와 스켈로턴을 위해
필요한 모든 기능의 코드는 CORBA에
의해서 자동적으로 제공된다.
[
그림3-7
] CORBA 호출 원리
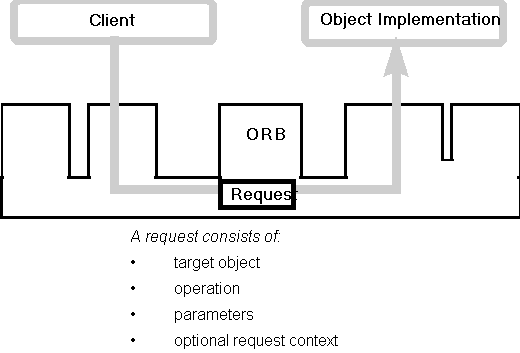
클라이언트 객체는 위의 호출 과정을
통해 해당 구현 객체에게 서비스(메소드)를
요청(request)한다.
이 때,
[그림3-8]
처럼 클라이언트의 요청에는 구현
객체와 해당 메소드, 각종
파라메터, 그리고
필요에 따라 컨텍스(context) 객체라는
것을 보낸다. 현재
로서 여러분은 컨텍스 객체는 요청된 결과를 다른 용도로 이용하기
위한 객체라고 이해하면 된다.
4막에서 컨텍스 객체에 대해 자세히
다룬다.
[
그림3-8
] CORBA 클라이언트와 객체 구현사이의
통신
2.3 CORBA 구성
요소 이해
자!
이제 전반적으로 ORB와
CORBA의
작동원리에 대해 이해했다면 각각의 CORBA
구성요소들에 대해 보다 자세히
살펴보자.
2.3.1 CORBA 클라이언트
부분과 구동 과정
CORBA 클라이언트는
구현 객체에 서비스 요청을 담당한다.
이때 [그림3-9]에서
처럼 CORBA 클라이언트는
정적인 호출 방법인 스터브를 사용하거나 동적 호출 인터페이스를
이용할 수 있다. 또한
ORB에서
제공하는 기능을 직접 이용하기도 한다.

[
그림3-9
] CORBA의 클라이언트 부분
다음은 각각의 부분에 대한 설명이다.
클라이언트 스터브는 정적 호출이라고도
한다. 왜냐하면
메소드 호출이 컴파일시 스터브에 의해서 미리 결정되기 때문이다.
동적 호출은 실행중에 원하는 메소드를
동적으로 호출할 수 있는 기능을 말한다.
이를 위해 CORBA는
인터페이스 저장소라는 데이터베이스에 해당 클래스의 모든 인터페이스를
저장해 두고 동적 호출시 이를 참조하여 해당 메소드를 수행한다.
다음은 클라이언트 객체의 동적
호출 과정과 이 때 이용하는 인터페이스들이다.
이 과정은 원하는 객체를 선언하는 것이다.
이 과정은 ORB의 get_interface라는 메소드를 사용하여 해당 구현 객체의 객체
참조자를 얻어오는 것이다.
CORBA는 매개변수를 전달하기 위해 특별한 형태의 자료 구조를 이용한다.
이를 NVList(NamedValue
list)라 부른다.
typedef unsigned long Flags;
struct NamedValue {
Identifier name; // 매개변수 이름
any argument; // 매개변수
long len; // 매개변수 값의 길이와 개수
Flags arg_modes; // 전달인자 모드 플래그
};
create_list를
사용하여 NVList를
작성한다.
ORBStatus create_list(
in long count;
out NVList new_list;
);
ORBStatus create_request(
in Context ctx; // 컨텍스 객체
in Identifier operation; // 메소드
in NVList arg_list; // 메소드의 매개변수
inout NamedValue result; // 메소드 결과
out Request; // 새롭게 생성된 request
in Flags req_flags; // request 플래스
);
invoke를 사용하고 서비스를 요청하고 결과를 얻어온다.
send를
사용하여 해당 서비스를 요청한 후 다시 본래의 프로그램에 복귀한다.
결과는 나중에 get_response나
get_next_response를
사용하여 얻어온다. CORBA는
send/get_response외에
oneway라는
특수한 비동기 호출 방식을 사용한다.
이 방식은 메소드 선언시 oneway
키워드를 사용함으로서 결과를
필요로 하지 않는 메소드임을 나타낸다.
Interface Request{
status add_arg( in identifier name,
in identifier name,
in TypeCode arg_type,
in void* value,
in long len,
in Flags arg_flags);
status invoke( in Flags invoke_flags);
status delete();
status send( in Flags invoke_flags);
status get_response( in Flags response_flags);
};
실제 CORBA
프로그래머는 이 두 방법을 잘
이해하고 있어야 하며 적절하게 사용해야 한다.
왜냐하면 시스템의 성능에 아주
큰 영향을 미치기 때문이다. 다음은
정적 인터페이스와 동적 호출 인터페이스를 비교한 표이다.
먼저 정적인 호출 방법은 ORB에서
제공하는 기본 API기능을
이용하여 서비스를 요청하는 것이다.
따라서 가장 손쉽게 CORBA
프로그램을 작성할 수 있다.
그러나 마우스 프로그래밍처럼
프로그램이 수행 중에 특정한 서비스의 호출이 필요할 경우 정적인
방법으로는 불가능하다. 따라서
이러한 상황에서는 동적 호출 인터페이스를 사용한다.
클라이언트는 동적 인터페이스
호출 방법을 이용하여 다음과 같은 일을 할 수 있다.
- 프로그램 실행 중에 원하는 객체를 찾는다.
- 프로그램 실행 중에 원하는 객체의 인터페이스를 찾는다.
- 프로그램 실행 중에 원하는 서비스를 생성한다.
- 프로그램 실행 중에 원하는 서비스를 요청한다.
- 프로그램
실행 중에 원하는 서비스의 결과를 받는다.
이 뿐만 아니라 동적 인터페이스 호출은
동기화 호출 방식과 비동기 호출 방식 모두를 지원한다.
따라서 사용자는 다양한 응용
프로그램을 작성할 수 있다. 단점으로는
프로그램시 많은 정적 호출에 비해 많은 코드와 노력이 필요하다는
것이다.
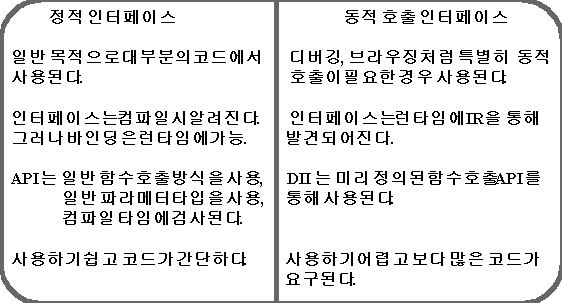
[ 표3-1 ] 동적 호출 대 정적 호출
통신 기능과 메소드 호출 등 ORB의
기본기능을 제공한다. 이
기능은 클라이언트 객체와 구현 객체 모두에 적용된다.
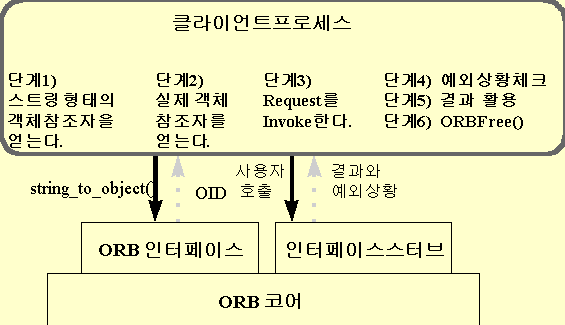
지금까지의 과정을 정리하는 차원에서
[ 그림3-10
]을 참조하면서 클라이언트 객체가
구동되는 과정을 살펴보자.
단계1) 먼저 , 클라이언트 객체를 하나 생성하고 해당 객체의 이름을 얻어 온다.
단계2) string_to_object()을 사용하여 문자열 형태의 이름을 실제 객체 참조자로 바꾼다.
단계3) 정적 호출이나 동적 호출 방법을 사용하여 해당 객체의 메소드를 호출한다.
단계4) 예외 상황을 검사하고,
단계5) 이상이 없으면 해당 결과를 활용한 후,
단계6)
마지막에 ORBFree()를
사용하여 클라이언트와 ORB사이의
연결을 종료한다.
[
그림3-10
] 클라이언트 구동 과정
2.3.2 CORBA 구현
객체 부분 및 구동 과정
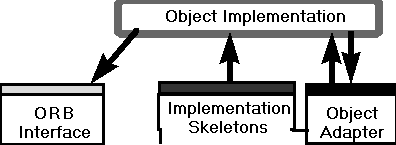
구현 객체는 스켈로턴을 통해 클라이언트의
서비스 요청을 처리한다. CORBA
구현 부분은 이 기능을 수행하기
위해 [그림3-11]처럼
구현 스켈로턴 , 객체
아답터 , ORB 인터페이스로
구성되어 있다. 각각의
기능은 다음과 같다.
[
그림3-11
] CORBA의 구현 객체 부분
구현 스켈로턴은 클라이언트의 서비스
요청에 대한 구현 객체를 직접 호출하는 역할을 한다.
이때 서비스 요청이 제공되는
정보를 해석하고 이를 통해 구현 객체에 전달하며 처리된 결과를 포장하여
네트웍을 통해 클라이언트에게 전달한다.
객체 아답터는 CORBA를
적용하려는 분야에 따라 다양하게 선택되어 사용되어 질 수 있다.
가령,
데이터베이스가 필요하다면 데이터베이스
아답터를 사용할 수도 있다. 그러나
CORBA1.1에서는
기본적인 객체 아답터(BOA , Basic
Object Adapter) 만을 정의하고
있다.
객체 아답터 의 역할을 단계별로 살펴보면
다음과 같다.
1) 먼저, 구현 객체를 구현 저장소에 등록한다.
2) 그런 다음, 프로그램 수행 중에 새로운 구현 객체의 인스턴스를 생성한다.
새롭게 생성된 구현 객체에 유일한 객체 식별자를 부여하고 이를 중복되지 않게 관리한다.
3) 그런 다음 ORB에게 새로운 구현 객체가 생성되었음을 알린다.
4) ORB를
통해 전달된 클라이언트 객체의 서비스 요청을 받고 이를 스켈로턴을
통해 구현 객체에게 전달(Up-call)하며
적합한 메소드를 호출한다. 이
때, 스켈로턴은
전달된 파라메터를 적절하게 해석해 준다.
객체 아답터 은 해당 구현 객체를 호출하기
위해 구현 저장소(Implementation
Repository)를 참조한다.
따라서 참조하기 전에 모든 구현
객체에 대한 정보는 미리 저장되어 있어야 한다.
저장되는 정보로는 구현 객체의
물리적인 위치, 이름,
활성화 정책,
사용 프로토콜 등 다양하다.
이 중에서 활성화 정보는 객체
아답터가 구현 객체를 활성화시킬 때 이용된다.
일반적으로 기본 객체 아답터에서
구현 객체를 활성화시키는 정책들은 다음의 4가지가
있다.
BOA가 자동적으로 활성화시키고 여러 개의 구현 객체를 포함하고 있다.
BOA가 활성화시키지 않고 사용자가 손수 서버를 구동시킨다. 기능은 shared와 동일하다.
BOA가 활성화 시킨다. 단 오직 한 서버에 하나의 구현 객체만이 존재한다.
클라이언트 객체가 메소드를 호출할 때
마다 BOA가
해당 구현 객체를 하나씩 생성한다.
해당 메소드를 수행 후 해당
구현 객체를 종료한다.
실제 어떤 정책을 사용할 것인가에 따라
성능상의 영향을 받기 때문에 시스템의 상황에 적합한 정책을 결정해야
한다. 일반적인
상황에서 어떤 방법이 가장 좋다라고 결정하기는 어렵다.
클라이언트 부분에서 처럼 통신 기능과
메소드 호출 등 ORB의
기본 기능을 제공한다.
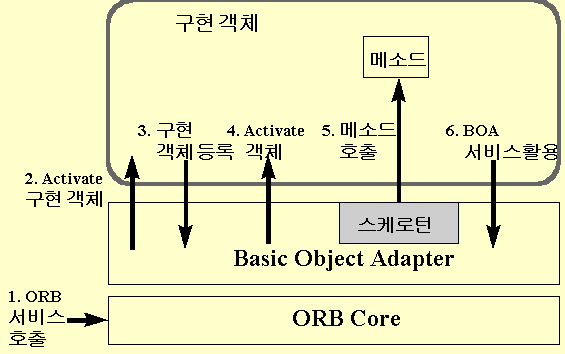
앞서와 마찬가지로 [그림3-12]을
참조하면서 구현 객체가 구동되는 과정을 살펴보자.
단계1) ORB는 클라이언트 객체의 서비스 호출 요청을 받고 구현 저장소를 참조한 후 구현 객체의 활성 여부를 검사한다.
단계2) 구현 객체가 활성중이지 않을 경우 활성화(Activate)시킨다. 이 때, 구현 객체에게는 BOA와 통신하는 데 필요한 정보를 전달받는다.
단계3) 구현 객체는 impl_is_ready 메소드를 호출하여 BOA에게 자신의 존재를 등록한다.
단계4) BOA는 단계3에서 등록된 구현 객체를 활성화시킨다.
단계5) BOA는 스켈로턴을 통해 클라이언트가 요청한 메소드를 호출한다.
단계6)
구현 객체에 대한 모든 이용이
끝나면 BOA에서
제공하는 deactivate_impl 메소드를
호출하여 구현 객체를 비활성화시킨다.
[
그림3-12
] 구현 객체 구동 방법
2.3.3 인터페이스
정의어
IDL은
C나
C++ , 스몰톡같은
구현 언어는 아니다. 단지,
객체지향 개념을 기반으로 한
인터페이스 정의어이다. 따라서
IDL을
사용하면 구현언어의 컴파일러에 상관없이 CORBA
응용 프로그램을 작성할 수 있다.
다시 말해,
일단 작성된 IDL
응용 프로그램은 IDL컴파일러를
통해 자동으로 분산 환경하에서 작동되는 특정 프로그래밍 언어의
코드로 변환된다. 사용자는
이 코드를 이용하여 원하는 응용 프로그램을 작성하면 된다.
다음 [그림3-13]은
IDL의
역할을 잘 나타내 주고 있다. 현재
IDL은
표준으로 C , C++ 언어로의
매핑을 지원하고 있으나 많은 제품들은 자바나 스몰톡,
Ada, 코볼 같은 언어로의 매핑도
지원하고 있다. 다음은
IDL의
특징을 정리한 것이다.
- 특정 프로그램 언어와 컴파일러에 독립적이다.
- 다중 상속을 지원하는 등 대부분의 객체지향 개념을 지원한다.
- 구현을 위한 언어가 아니다. 즉, 프로그래밍 언어가 아니다.
- 동적
호출 메커니즘을 제공한다.
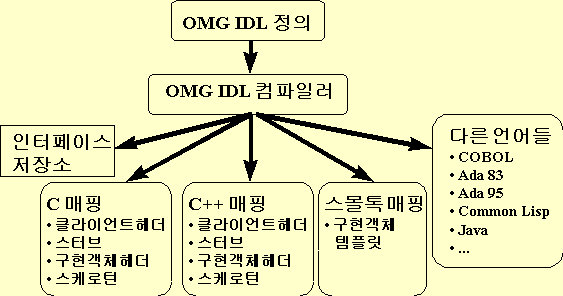
[그림3-13
] IDL 의 역할
실 예로 다음은 IDL로
은행계정 클래스를 정의한 것이다.
IDL언어는 실제 C++처럼
원하는 클래스를 interface라는
키워드를 사용해서 선언할 수도 있으며 이 interface안에
애트리뷰트와 메소드를 선언할 수도 있다.
아울러 각종 데이터 타입도 존재한다.
interface account {
readonly attribute float balance;
readonly attribute string name;
void make_lodgement(in float f);
void make_withdrawal(in float f);
; };
<예제3-1>
IDL로 작성된 account
인터페이스
실제 IDL에서
가장 기본이 되는 단위는 인터페이스 이다.
이 인터페이스는 애트리뷰트와
메소드로 구성된다. 다음은
IDL의
사용문법을 간단하게 정리한 것이다.
대부분의 문법은 C++의
것과 비슷하다. 그러나
파라메터_타입의
경우 클라이언트와 구현 객체 사이로의 이동 방향에 따라 in
, out , inout으로 선언할 수
있다. in의
경우 클라이언트에서 구현 객체로 ,
out은 구현 객체에서 클라이언트로
, inout은
양방향으로 이동이 가능한 파라메터를 의미한다.
인터페이스 := INTERFACE 메소드 | 애트리뷰트
메소드 := 리턴타입 메소드 이름 ( 파라메터_타입 파라메터)
리턴타입 := void | boolean | ...
메소드 이름 := 문자열
파라메터_타입 := in | out | inout
type := int | boolean | float | ...
파라메터 := 문자열
애트리뷰트 := [readonly] ATTRIBUTE 리턴타입 애트리뷰트_이름
애트리뷰트_이름
:= 문자열
[표
3-2 ] IDL 사용문법
인터페이스를 선언하기 위한 문법뿐만 아니라 IDL은 기본 자료형을 제공한다. 다음은 IDL로 사용가능한 기본 자료형들이다. 이 기본 자료형을 사용하여 작성된 인터페이스를 새로운 자료형으로 사용할 수 있다.
short, long, unsigned short, unsigned long, float, double, char,
boolean, octet, any, string, constant, struct, typedef, sequence,
arrays, exceptions, enum,
union, contexts

[
그림3-14
] IDL 자료형
다음 막에서 IDL에
대해 보다 자세히 다룰 것이다.
2.4. CORBA의
여러 가지 구성방법
CORBA는
클라이언트와 구현 객체, 그리고
ORB의
배치에 따라 여러 구성 방법을 갖는다.
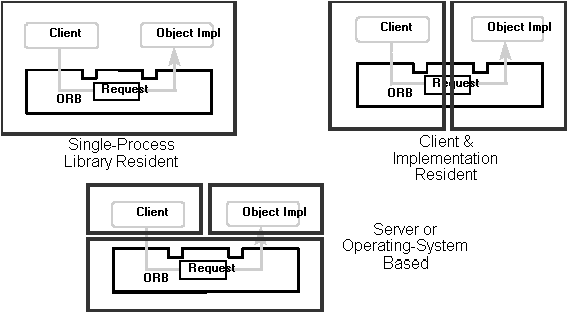
일반적으로 [그림3-15]
에서 처럼 크게 3가지
방법이 존재한다.
1) 단일 프로세스 라이브러리 형태(Single-Process Library Resident)
단일 프로세스 내부에서 라이브러리를
통해 클라이언트와 구현 객체사이의 서비스가 진행되는 방법이다.
이 방법은 분산된 환경에 적합하지
않다.
2) 클라이언트와 구현 객체 라이브러리 형태(Client & Implementation Resident)
또 하나의 방법은 분산 객체 시스템에서
제공하는 기능이 클라이언트용 라이브러리와 구현 객체용 라이브러리
형태로 존재하고 이를 이용하여 분산된 환경에서 응용 프로그램을
작성한다. 작성된
프로그램은 별도의 프로세스로 존재한다.
3) 서버 또는 운영체제 형태(Server or Operating-System Based)
마지막으로 기존의 운영체제에 분산 객체
기능을 추가하거나 별도의 분산 객체 데몬 프로그램이 존재하여 클라이언트와
분산 객체사이의 서비스를 주관하는 방법이 있다.
현재 대다수의 CORBA
구현 제품은 두 번째와 세 번째
방법을 사용하여 분산 객체 시스템을 개발하고 있다.
[
그림 3-15
] CORBA의 여러 가지 구조
2.5. CORBA V1.2 대
V2.0
지금까지 살펴본 CORBA의
기능들은 대부분 1.2를
기준으로 하는 것들이다. 그러나
현재 CORBA는
2.0 안이
확정되었으며 3.0을
준비하고 있는 실정이다. 과연
CORBA2.0에
어떤 기능들이 강화되었는지 정리해 보자.
CORBA2.0에서
강화된 부분은 크게 다음과 같다.
저장소
각 부분에 대해 좀 더 자세히 살펴보자.
2.5.1 CORBA 2.0 코어
CORBA 1.2 표준안의
가장 큰 단점은 다른 CORBA 제품과
호환이 되지 않는다는 것이다.
가령,
A사에서 공급하는 CORBA
제품과 B사의
제품은 호환이 되지 않는다. 왜냐하면
각 사에서 객체를 인식하는 방법이 틀리기 때문이다.
이러한 문제점를 해결하는 데
중점을 둔 것이 CORBA 2.0 표준안이다.
따라서 CORBA
2.0은 기존의 CORBA
1.2의 기능에 다음의 기능들을
추가하였다.
CORBA 2,0에서는
구현 객체가 실행 시간에 요청된 서비스의 파라메터를 해석하여 다른
구현 객체의 메소드를 호출하는 동적 스켈로턴 인터페이스 방식을
추가하였다. 특히
이 기능은 다른 ORB들
사이의 서비스 교환시 유용한 기능이다.
특히,
동적 스켈로턴 인터페이스를 이용하면
마이크로소프트의 COM/OLE와
같은 다른 객체에 대한 게이트웨이를 생성할 수 있을 뿐만 아니라
다른 ORB사이에서도
특별한 기능의 게이트웨이를 만들 수 있다.
초기화는 기존의 CORBA
1.2 지원 제품에서 ORB를
초기화하는 과정을 표준화하기 위한 인터페이스이다.
여기에는 ORB를
초기화 하고 ORB에
대한 객체 참조자를 얻기 위한 인터페이스로 ORB_init과
BOA를
초기화하고 BOA에
대한 객체 참조자를 얻기 위한 BOA_init
인터페이스,
최초 원하는 객체를 찾는 데
사용하는 인터페이스로 구현 객체의 목록을 제공해주는 list_initial_services
, 해당 구현 객체의 객체 참조자를
해석해주는 resolve_initial_reference
등 이 있다.
각 단계별 절차와 인터페이스들의
명세는 다음과 같다.
1단계) ORB를 초기화하고 해당 ORB를 사용하기 위한 참조자를 얻어온다.
typedef string ORBid;
typedef sequence<string> arg_list;
ORB ORB_init(inout arg_list argv , in
ORBid orb_identifier);
2단계) BOA를 초기화하고 해당 BOA의 참조자를 얻어온다.
BOA BOA_init(inout arg_list argv, in
BOAid boaidentifier);
3단계) 원하는 초기 서비스들에 대한 목록을 얻어온다.
typedef string ObjectId;
typedef sequence<ObjectId> ObjectIdList;
ObjectIdList list_initial_services();
4단계) 원하는 서비스의 객체 참조자를 얻어오고 이를 통해 원하는 작업을 진행한다.
Object resolve_initial_reference(in
ObjectId identifier) raises(LnvalidName);
앞서 설명한 것처럼 인터페이스 저장소는
구현 객체에 대한 동적 호출시 해당 인터페이스에 대한 타입 검사를
비롯하여 CORBA 객체를
운영하는 데 필요한 모든 인터페이스 정보를 저장하고 있다.
서로 다른 ORB
객체들 사이의 호환을 위해서는
이 들, 인터페이스
저장소에 있는 정보들을 이용할 필요가 있다.
이를 위해 CORBA2.0에서는
기존의 CORBA 1.2에
정의되어 있던 Repository 인터페이스를
확장하고 저장소에 대한 갱신(updates)
기능을 지원한다.
뿐만 아니라 new
메소드를 통해 IR객체를
생성하고 이를 프로그램 실행 중에 접근할 수 있게 해 준다.
다시 말하자면 모든 IDL
생성자를 위해 인터페이스 저장소
객체 타입을 생성할 수 있게 해 준다.
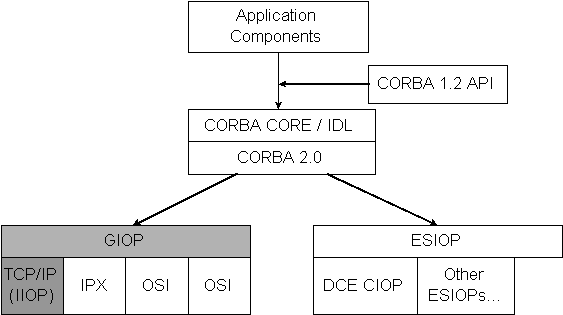
CORBA2.0에서는 ORB사이의 호환을 위해 [그림3-16]과 같은 프로토콜 구조를 제안하였다. 이 구조에서 보면 크게 필수적인 요구사항으로 GIOP(General Inter-ORB Protocol)와 이를 TCP/IP상에 구현한 것이 있다. 옵션 사항으로는 ESIOP(Environment-Specific Inter-ORB Protocols)가 있다. 자세한 내용은 2.6절에서 자세히 설명한다.
[
그림3-16
] ORB간 호환 구조
2.5.3 IDL-C++, 스몰톡
바인딩 지원
초기 CORBA
1.2 표준에서는 IDL
언어를 C언어로
매핑시키는 것만을 규정했었다.
그러나 2.0에서는
IDL언어를
C++와
스몰톡 언어(스몰톡80,
스몰톡 Portability)로
매핑하기 위한 명세를 포함시켰다.
특히 ,
C++ 바인딩쪽에서는 C++과
함께 C 코드를
사용할 때 필요한 새로운 C 바인딩
규칙도 지원한다. 이를
통해, CORBA 사용자는
같은 프로세스내에서 C와
C++을
함께 사용할 수 있으며 컴파일 플래그 옵션으로 기존의 C매핑을
포함하여 원하는 방법을 선택적으로 사용할 수 있다.
스몰톡의 경우,
자바 언어처럼 사용한 메모리를
자동적으로 처리해 주는 가베지 컬렉션(garbage
collection) 기능이 포함되어
있기 때문에 CORBA 응용
프로그램의 메모리를 직접 관리할 필요가 없다.
다음은 참고로 스몰톡 매핑 규칙을
요약한 것이다. 스몰톡
언어를 경험한 분이라면 이해할 수 있을 것이다.
- Operation & attribute -> 스몰톡 메세지
- Object reference -> 모든 스몰톡 객체가 접근가능한 객체
- enumeration -> smalltalk CORBAenum 프로토콜
- struct -> smalltalk Dictionary
- union -> smalltalk CORBAunion 프로토콜
- sequence -> smalltalk OrderedCollection
- array -> smalltalk Array
- exception -> Dictionary 클래스
2.6 CORBA 상호연동
메커니즘, IIOP
비록 CORBA
그 자체는 700여
개가 넘는 회사들의 합의에 의한 표준 시스템 통합 기술이지만 이
표준을 구현한 제품들은 각기 다른 구현 방법을 사용한다.
뿐만 아니라 실제 CORBA를
다양한 분야에서 사용할 경우 여러 종류의 CORBA제품을
사용할 수도 있다. 이런
상황에서 가장 필요한 기술은 서로 다른 CORBA제품들
간의 상호연동과 다른 외부 서비스들과의 상호 연동 기술이다.
CORBA 시스템과 다른 서비스와의
연동은 5막에서
다루는 주제이다. 이
장에서는 CORBA 시스템의
상호연동 방법들에 대해서 정리해 본다.
2.6.1 CORBA 상호연동
방법론
CORBA 상호연동이란
[그림3-17]처럼
클라이언트 객체가 ORB의
종류나 프로토콜에 상관없이 모든 구현 객체를 이용할 수 있게 해주는
기능을 말한다. 예를
들면, ORB A상에
존재하는 클라이언트 객체는 ORB
A에 존재하는 구현 객체 외에
ORB B에
존재하는 구현 객체의 메소드도 호출할 수 있다.
반대로 ORB
B상의 클라이언트 객체도 ORB
A의 구현 객체를 호출할 수 있다.
이 기능을 지원하기 위해서는
먼저 표준화된 프로토콜과 ORB
초기화 방안 등 많은 기능을 필요로
한다.
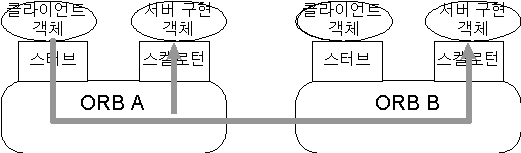
[그림3-17]
CORBA 상호연동
CORBA 상호연동을
위해 CORBA2.0 명세는
[그림3-16]처럼
ORB간
상호연동을 위한 프로토콜 구조와 ORB간의
상호연동 구조를 정의하였다.
ORB간
상호연동을 위한 프로토콜 구조는 모든 ORB제품들이
지원해야 만 하는 부분으로서 GIOP(General
Inter ORB Protocol )와 이를
TCP/IP상에
구현한 IIOP(Internet Inter-ORB
Protocol)가 있다.
먼저,
GIOP는 ORB들
사이의 통신을 위한 일련의 메시지 형태와 공통의 데이타 표현을 명시한다.
GIOP로 명시된 클라이언트의 요구사항은
TCP/IP를
비롯하여 일련의 네트웍을 공유하여 다른 ORB에게
바로 전달된다. 이때
IDL로
정의된 데이터 타입을 네트웍 메시지 형태로 변환하기 위해 CDR(Common
Data Format)이라는 표현 방법을
사용한다. 다음은
GIOP에서
사용하는 메세지 형태이다.
* 클라이언트 객체의 메세지 형식: Request, CancelRequest, LocateRequest
* 구현 객체의 메세지 형식 : Reply, LocateReply, CloseConnection
* 양쪽에
공통적인 메세지 형식 : MessageError
GIOP는
연결지향 프로토콜(connection-oriented
protocol)로서 TCP/IP를
기반으로 하기 때문에 전송상의 신뢰성을 보장한다.
GIOP등의 CORBA
표준 프로토콜을 사용할 때 또
하나 고민해야 할 부분은 서로 다른 ORB들상에서
생성된 객체를 어떻게 표준화시킬 것인가 하는 것이다 앞서도 잠시
언급했듯이 ORB들은
자체적으로 고유한 객체 표현 방식을 사용한다.
따라서 이 문제로 인해 CORBA
V1.2에서는 ORB간의
상호연동이 불가능했었다. 이를
해결하기 위해 CORBA2.0에서는
표준 객체 참조자 양식으로 IOR(Inter-operable
Object Reference)을 정의하였다.
IOR에는 다음의 정보들이 표현된다.
객체 타입 ,
프로토콜 ,
이용가능한 ORB
서비스,
객체 참조자의 널 값 유/뮤
정리하면,
IOR에는 원격지상의 ORB를
통해 해당 객체의 서비스를 호출하는 데 필요한 모든 정보가 포함된다.
다음 [그림3-17]은
IOR을
사용하는 시나리오를 단계별로 보여준다.
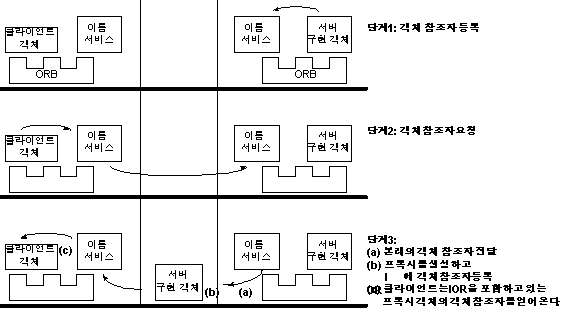
[
그림3-17]
IOR 사용 시나리오
CORBA 2.0에서
정의한 GIOP를
TCP/IP상에서
구현한 것을 IIOP(Internet Inter-ORB
Protocol)라고도 하는데 여기서는
GIOP로
정의된 메세지가 TCP/IP상에서
어떻게 구현되는 가를 정의하고 있다.
IIOP의 중요한 의미 중 하나는
별도의 노력없이 인터넷상에서 CORBA
응용 시스템을 개발할 수 있게
해준다라는 것이다. 왜냐하면
인터넷의 기본 프로토콜이 TCP/IP이기
때문이다. 따라서
TCP/IP상에
만들어진 객체간 통신 프로토콜인 IIOP는
자연스럽게 인터넷상에서 객체간의 통신을 보장해 준다.
결국 CORBA
2.0 을 지원한다는 말은 TCP/IP
상에서 GIOP를
사용하여 서로 다른 ORB들
사이의 메소드 호출을 지원한다는 말이다.
GIOP와
IIOP가
필수적인 요구 사항인데 반해 ESIOP(Environment-Specific
Inter-ORB Protocol)는 옵션사항으로서
DCE처럼
특정한 분산 서비스 시스템들과의 호환을 위해 설정된다.
현재 DCE가
그 첫번째 호환 대상으로서 정의되어 있다.
DCE/ESIOP에 따르면 GIOP의
CDR로
표현된 메시지는 DCE에서
해석이 가능하도록 변환되어 진다.
따라서 ESIOP를
사용하면 보안기능이나 디렉토리 서비스 등 DCE에서
제공하는 추가적인 기능을 이용할 수 있다.
2.6.3 ORB간
상호연동 구조
ORB 브리지란
말 그대로 ORB사이의
교량 역할을 해주는 모듈을 말한다.
따라서 브리지를 구성하면 ORB간에
상호연동이 가능해진다. 현재
브리지는 [그림3-18]처럼
두가지 방법으로 구현할 수 있다-인-라인
브리지( In-line bridge) , 요청-수준
브리지( Request-level bridge
).
인-라인
브라지
인-라인
브리지의 경우 ORB내부에
직접 전송 모듈을 추가하여ORB간의
직접적인 통신을 지원한다.
요청-수준
브리지
요청-수준
브리지는 ORB에서
제공하는 API를
사용하여 ORB간의
통신이 이루어진다. 클라이언트는
스터브나 DII를
사용하여 다른 ORB 상의
구현 객체를 마치 자신의 ORB상에
있는 구현 객체처럼 호출한다.
이 호출은 DSI를
사용하는 양쪽 ORB사이의
브리지를 통해 전달된다. 원격지상의
ORB는
이 요청을 받고 처리한다.

[
그림 3-18a
] 인-라인
브리지

[
그림 3-18b
] 요청-수준
브리지
2.6.3.2 ORB간
브리지 구성 방법
브리지를 통해 다양한 규모의 CORBA
응용 시스템을 구축할 수 있다.
CORBA에서는 이를 위해 CORBA
도메인이란 개념을 제공한다.
CORBA 도메인은 다양한 용도와
목적에 의해 구분되는 논리적인 개념의 공간이다.
예를 들면,
여러분은 관리 차원이나 ORB종류,
네트웍 프로토콜,
서비스 별로 도메인을 구성할
수 있다. 따라서
이러한 도메인을 구성하려면 브리지를 사용하여 ORB
시스템들간에 네트웍을 구성해야
한다.
브리지는 프로토콜에 따라 풀-브리지(Full
Bridge)와 해프(Hald
Bridge)-브리지로
나뉜다. 풀-브리지는
두개의 도메인을 직접 연결해주는 역할을 한다.
다시 말해,
공통의 프로토콜을 사용한다.
이에 반해 해프-브리지는
서로 다른 도메인을 사용하는 두개의 도메인을 연결해주는 역할을
한다. 성능면에서는
풀-브리지가
해프-브리지보다
유리하다. 왜냐하면
해프-브리지의
경우 서로 다른 프로토콜사이에서 메세지 형태를 맞추기 위해 다양한
변환 작업을 수행해야 하기 때문이다.
이들 브리지를 이용하여 다양한 도메인을
구성하고 이 들 도메인을 묶어 낼 수 있다.
CORBA 표준에서는 두가지 묶는
방법을 제공한다-직접
브리징(Immediate Bridging)
, 중간 브리징(Mediate
Bridging) 또는 백본 브리징(Backbone
Bridging). 직접
브리징의 경우 [그림
3-19a]처럼
각 프로토콜을 그물처럼 연결한다.
그러나 중간 브리징은 [그림3-19b]처럼
중간에 통일된 백본 프로토콜을 위치시켜 연결부를 단순화 시키다.

[
그림3-19a
] 직접 브리징

[
그림3-19a
] 중간 브리징
3장.
CORBA 서비스들
3.1 CORBA 서비스란?
CORBA 서비스는
금융이나 통신 등 특정 분야에 국한되지 않고 광범위하게 CORBA
객체를 조작하는 데 필요한 모든
서비스들을 지원하기 위한 인터페이스 명세이다.
[그림 3-20]에서
처럼 CORBA 서비스는
OMA의
하단부에 위치한다. 위치가
상징하듯이 CORBA 응용
프로그램들은 이 기능들을 이용하여 원하는 작업을 수행한다.
CORBA 서비스는
계속해서 진행되고 있는 CORBA
표준이다.
따라서 필요에 따라 추가될 수
있다. [그림
3-20]에서
처럼 CORBA서비스는
1993년
COSS1(Common Object Service Specification
1) 명세부터 1996년
COSS5까지
계속해서 진행되고 있다(참고로
초기 CORBA service라는
이름은 COSS로
불리워 졌었다).

[그림
3-20] OMA에서
CORBA 서비스
각 CORBA
서비스의 종류와 내용은 다음과
같다.
| COSS1 | 1993년 | 명명 서비스 , 이벤트 서비스, 생명 주기 서비스 , 지속성 서비스 |
| COSS2 | 1994년 | 객체 관계 서비스, 동시성 서비스, 트렌젝션 서비스, 외형화 서비스 |
| COSS3 | 1995년 | 보안 서비스, 시간 서비스. |
| COSS4 | 1995년 | 질의 서비스, 라이센스 서비스, 특성 서비스 |
| COSS5 | 1996년 | 트레이딩 서비스 , 컬렉션 서비스, 변화 관리 서비스 |
[
표3-3
] CORBA 서비스의 종류와 내용
3.2 CORBA 서비스의
종류와 내용
3.2.1 COSS1
모든 객체는 초기 생성에서 부터 소멸되는
시점까지 일련의 생명주기를 갖는다.
또한 한 객체를 복사,삭제
하는 등 다양한 조작 기능을 갖는다.
이러한 서비스를 제공하는 기능이
생명 주기 서비스이다.
생명 주기 서비스를 위해 CORBA는
3개의
인터페이스를 제공한다-FactoryFinder
, GenericFactory , LifeCycleObject.
각 인터페이스가 제공하는 기능은 다음과
같다.
CORBA에서 모든 객체는 Factory라는 이름의 인터페이스를 통해서 생성된다. GenericFactory 인터페이스는 create_object라는 메소드를 통해 새로운 객체를 생성해낸다.
모든 객체는 서로 다른 크기와 타입을
갖으며 각기 운영 환경에 따라 다르게 생성되기 때문에 공통의 Factory를
갖을 수 없다. 따라서
FactoryFinder 인터페이스에서
제공하는 find_factories 라는
메소드를 통해 해당 Factory 인터페이스를
찾는다.
일단 생성된 객체는 복사,이동,제거
등 다양하게 조작된다, 이를
위해 CORBA는
LifeCycleObject 라는
인터페이스를 제공한다. LifeCycleObject는
해당 객체의 복사를 위해 copy
메소드를 ,
이동을 위해 move
메소드를 ,
제거를 위해 remove
메소드를 제공한다.
Copy 메소드의 경우 해당 객체를
복사하고 복사한 객체의 객체 참조자를 반환한다.
이에 반해 move
메소드는 FactoryFinder가
존재하는 범위내에서 한 객체를 다른 곳으로 이동시킨다.
복잡한 시스템을 디자인할 경우,
특정 객체에게 이벤트를 전달하여
새로운 서비스를 요구하거나 수행시키기 위한 서비스가 필요하다.
이러한 기능을 제공하는 것이
이벤트 서비스이다. CORBA
이벤트 서비스는 멀티캐스트 기능을
제공한다. 다시
말해, 복수
이벤트 제공자들과 수용자들을 지원한다는 것이다.
이러한 기능들을 위해 CORBA
이벤트 서비스는 객체간의 상호작용을
위해 두가지 스타일의 이벤트 모델을 제공한다-Push
스타일,
Pull 스타일.
[그림
3-21]은
CORBA 이벤트
서비스 모델이다. 이
모델을 보면 크게 이벤트를 제공하는 공급자 응용 객체와 이를 소비하는
소비자 응용 객체가 존재한다.
이들 사이에는 이벤트를 전달해
주는 채널인 이벤트 채널 객체가 존재한다.
이벤트 채널 객체는 이벤트 팩토리
인터페이스를 통해 생성된다. 소비자는
공급자가 생성한 이벤트 채널을 통해 이벤트를 전달받는다.
이 과정에서 Push
모델은 이벤트 공급자가 주도적으로
소비자에게 이벤트를 전달하는 방식이고 Pull
모델은 소비자가 주도적으로 공급자의
이벤트를 이용하는 방식이다.

[그림3-21]
이벤트 서비스 모델
사용자들은 CORBA객체를
이용할 때 문자열 형태의 객체 이름을 사용한다.
그러나 실제 CORBA객체를
조작하기 위해서는 사람을 유일하게 식별해주는 주민등록번호같이
객체에게 유일한 이름인 객체 참조자를 이용해야만 한다.
그러나 객체 참조자는 문자열
이름처럼 쉽게 이용할 수 있는 것이 아니다.
따라서 CORBA는
사용자들이 이용하는 문자열 형태의 객체 이름을 실제 객체의 이름인
객체 참조자로 매핑시켜 주는 서비스를 제공한다.
이러한 서비스가 명명 서비스이다.
명명 서비스는 [그림3-22]처럼
디렉토리 구조의 명명 규칙을 지원한다.
이 그림을 보면 잘 짜여진 디렉토리
구조를 볼 수 있다. 가장
하위 레벨의 a2는
sys와
bin 이라는
명명 컨텍스 (Naming Context)아래
위치한다. 이를
sys::bin::a2라는
방식으로 구별한다. 명명
컨텍스는 이름들의 범위를 정의한다.
명명 서비스에서 제공하는 주요 메소드는 다음과 같다.
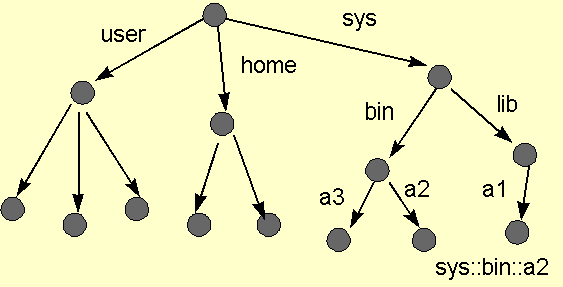
[
그림3-22
] 디렉토리 구조의 명명 서비스
파일이나 데이타베이스에 자료를 저장하지
않는 한 프로그램중에 생성된 모든 객체는 프로그램의 종료와 더불어
정보를 잃어버리고 마는 일시성 객체이다.
따라서 지속적으로 정보를 저장하고
싶은 경우 일시성 객체와 달리 원하는 정보를 지속적으로 저장해주는
객체를 생성해야 한다. 이러한
객체를 지속성 객체라 하며 CORBA
지속성 서비스는
이러한 지속성 객체를 생성해 준다.
[그림 3-33]은 지속성 서비스 모델의 구조를 보여 준다. 클라이언트에게 제공되는 지속성 객체(PO , Persistent Object)는 지속성 프로토콜을 통해 지속성 데이타 서비스를 이용하여 데이타스토어에 정보를 저장한다. 데이타스토어는 객체지향 데이타베이스나 관계형 데이타베이스 또는 파일 시스템이 될 수 있다. 지속성 데이타 서비스는 각 데이타스토어 특성에 맞게 지속성 객체를 조작하는 기능을 담당한다. 예를 들어, 데이타 스토어가 객체지향 데이타베이스인 경우 객체지향 데이타베이스 표준인 ODMG93(Object Database Management System)명세를 통해 지속성 객체를 조작하며 관계형 데이타베이스의 경우 동적 데이타 객체 프로토콜을 사용하여 조작한다. 또한 직접 접근(Direct Access) 프로토콜을 사용하여 파일 시스템같은 데이타스토어를 이용할 수 있다. 이러한 지속성 프로토콜은 지속성 데이타 관리자에 의해서 관리되며 클라이언트에게 단일하게 보여지고 제공된다. CORBA 지속성 서비스는 이러한 기능을 제공하기 위해 PO인터페이스를 제공한다.
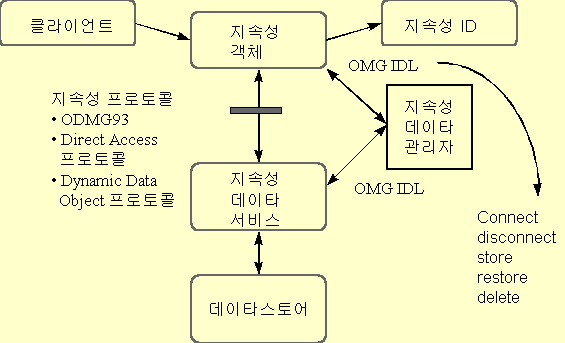
[
그림3-33
] 지속성 서비스 모델
참고로 직접 접근 프로토콜은 선소프트에서
제안한 프로토콜로 IDL같은
데이타 정의어를 사용하여 지속성 객체에 직접 접근하여 이용할 수
있게 해 준다. 이에
반해, 동적
데이타 객체 프로토콜은 IBM에서
제안한 프로토콜로 IDL없이
사용자가 동적으로 SQL 질의를
작성하여 지속성 객체를 다루게 해준다.
마지막으로 ODMG93은
C++를
사용하여 데이타 객체를 조작하게 해주는 명세이다.
3.2.2 COSS2
일반적으로 데이타를 이동시킬 경우 스트림이라는
기술을 사용한다. 예를
들면 유닉스나 도스상에서 파이프라인(|)같은
명령어를 사용하여 두개의 명령어를 결합하면 앞의 명령어를 수행한
결과를 뒤의 명령어가 연속적으로 받아서 이용할 수 있다.
이런 것처럼 데이타를 스트림이라는
연속화된 개념으로 추상화하고 이것을 네트웍이나 프로세스에 상관없이
이동시킬 수 있다. 이처럼
객체의 외형화란 일련의 객체를 스트림 형태로 처리하여 파일이나
데이타베이스처럼 다른 형태의 객체로 바꾸는 것을 객체 외형화
서비스라고 한다.
객체 외형화 서비스에는 객체를 메모리나
디스크 또는 네트웍상의 다른 곳으로 변형하는 외형화와 다시 객체
형태로 바꾸는 내형화를 모두 포함하고 있다.
가령,
여러분은 외형화를 통해 객체를
전자우편 형태로 바꾸어 사용할 수 도 있으며 수신한 전자우편을 내형화하여
다시 객체로 변경할 수 있다.
객체 외형화 서비스를 지원하기 위해
CORBA는
여러 형태의 스트림 인터페이스를 정의하고 있다.
향후 객체 외형화 서비스는 데이타간의
교환 기능을 제공할 예정이다.
현실 세계의 모든 사람들이 부모나 형제,
친구처럼 다른 사람들과 일정한
관계를 갖는 것처럼 객체들간에도 일정한 관계가 발생한다.
예를 들면,
1막에서 살펴본 것처럼 부모 클래스와
자식 클래스는 부자지간이라는 관계를 갖으며 C++에서는
상속이라는 기능을 이용하여 표현하였다.
이처럼 객체들 사이에서 발생하는
다양한 관계들을 정의하게 해주는 서비스가 객체 관계 서비스이다.
[그림
3-34]는
객체들 간의 관계를 잘 표현해 주고 있다.
아래 그림에서 jhpark이라는
객체는 소유자라는 역할을 부여받으며 엘란트라 객체는 소유당하는
물건이라는 역할을 갖는다. 이들
사이에는 소유라는 관계가 발생한다.
이러한 관계는 [그림
3-34]와
같은 그림으로 표현되며 그래프 구조를 갖게 된다.
실제 객체들 사이의 관계를 모델링하는
분야는 객체지향 분석과 디자인이다.
만약,
여러분들이 이 분야에 관심이
있다면 그래디 부치의 "객체지향 분석과 디자인"처럼 해당
분야에 대한 전문서를 참조하기 바란다.
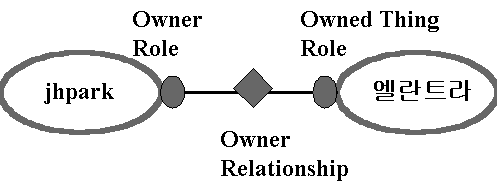
[
그림 3-34
] 객체 관계 서비스
객체 관계 서비스는 둘 또는 그 이상의
객체들 사이의 연관성을 표현하고 이들 연관성을 표준방법을 통해
다른 응용 프로그램에 의해서 접근하고 유지할 수 있게 해준다.
이를 통해 CORBA
응용 시스템은 객체들 간의 관계를
다양하게 조작할 수 있다.
트렌젝션은 더 이상 나누어 지지 않는
하나의 작업 단위이다. 가령,
특정 값을 읽거나 갱신하는 것
등은 하나의 작업 단위이다. 이러한
트렌젝션은 ACID라는
다음의 특성을 만족해야 한다.
트렌젝션에 의한 모든 변화는 완전히 수행되거나(commit)나 완전히 이전 상태로 되돌아간다(commit).
트렌젝션에 의해 변화된 부분은 변하지 않는다.
한 트렌젝션에 의한 변화는 다른 트렌젝션에 의해서 영향을 받지 않는다.
정상적으로 수행된 트렌젝션에 의한 변화는
변하지 않는다.
이러한 트렌젝션은 거의 모든 응용 시스템에서
필수적으로 사용되는 기능이다.
이를 지원하기 위해 CORBA는
객체 트렌젝션 서비스(OTS)라는
명세를 지원한다. OTS는
CORBA응용
시스템 개발에 있어 가장 필수적인 기능 중 하나이다.
OTS가
제공하는 기능들은 다음과 같다.
가장 기본적인 트렌젝션 모델은 트렌젝션의
시작(begin_transaction)과
정상적인 종료나(commit_transaction)
, 비 정상적인 종료(abort_transaction)로
끝난다. 이러한
트렌젝션을 플랫 트렌젝션이라고 한다.
플렛 트렌젝션 : begin_transaction
~ // 실제 수행 작업
commit_transaction // 정상적인 종료
begin_transaction
~ // 실제 수행 작업
abort_transaction // 비정상적인
종료
플랫 트렌젝션외에 간혹 한 트렌젝션내에
다른 트렌젝션을 중첩해서 사용할 경우가 있다.
이 경우의 트렌젝션을 중첩된
트렌젝션이라고 한다.
중첩된 트렌젝션 : begin_transaction begin_transaction
~ // 실제 수행 작업
commit_transaction commit_transaction
// 정상적인 종료
begin_transaction begin_transaction
~ // 실제 수행 작업
commit_transaction abort_transaction
// 비정상적인 종료
OTS는
플랫 트렌젝션과 중첩된 트렌젝션 모두를 지원한다.
OTS는
아래 그림과 같은 서비스 모델을 갖는다.
이 모델의 주요 구성 요소는 다음과
같다.
트렌젝션 클라이언트는 begin과 end로 마크되는 블럭내에서 일련의 메소드를 호출하는 클라이언트 객체이다. 일단 트렌젝션 클라이언트 객체에 의한 호출은 ORB를 거쳐 트렌젝션 서비스에게로 전달된다. 여기서 트렌젝션 서비스는 트렌젝션 컨텐트라는 쓰레드를 생성하여 트렌젝션 클라이언트에게 할당한다. 쓰레드를 할당받은 트렌젝션 클라이언트는 원하는 트렌젝션 메소드를 호출한다. 이 호출은 해당 트렌젝션에 참여한 다른 모든 객체들에게도 전달된다. 트렌젝션 클라이언트는 메소드 호출을 마친 후 commit이나 rollback을 호출하여 해당 트렌젝션을 종료한다.
트렌젝션 서버는 트렌젝션에 영향을 미치는 객체들의 집합이다. 그러나 이 들 객체는 내부에 데이타를 갖고 있게 않다. 따라서 트렌젝션에 영향을 미칠 뿐이지 시스템 붕괴처럼 유사시 발생하는 문제로 인해 해당 값을 이전 값으로 회복할 필요가 없다. 따라서 트렌젝션 서버는 트렌젝션의 수행에 관여하는 것이 아니라 ORB를 통해 회복가능한 서버를 호출하는 역할을 수행한다. 단, 트렌젝션을 시작 이전단계로 되돌리는 롤백(roll-back) 작업은 수행할 수 있다.
회복가능한 서버는 트렌젝션의 성공적인
수행(commit)이나
이전으로 복귀(roll-back)에
의해서 영향을 받는 데이타를 갖는 객체들의 집합이다.
데이타베이스나 트렌젝션 파일들은
대표적인 회복가능한 서버이다.

[
그림 3-35
] 객체 트렌젝션 서비스 모델
도서관에 있는 정보들은 한 명이 독점할
수 있는 것이 아니라 여러 사람에 의해서 공유되는 것이다.
만약,
한 명이 이 정보를 독점한다면
다른 사람들은 이를 이용할 수 없다.
또한 다른 사람이 이용하는 중간에
해당 정보에 변경을 가한다면 기대치 않은 부정확한 정보를 얻을 수
있다. 마찬가지로
CORBA 응용
시스템에서 하나 또는 그 이상의 객체들이 동시에 특정 자원을 이용할
필요가 있을 경우, 한
객체에 의해서 독점되지 않도록 이를 제어해야 한다.
또한 다른 객체들이 자원을 이용하고
있을 때 이 객체에 변경을 가하지 못하도록 해야 한다.
이러한 기능이 동시성 제어
서비스이다. 일반적으로
동시성 제어 서비스는 앞서 설명한 트렌젝션 서비스와 맞물려 언급되거나
사용되어 진다.
동시성 제어 서비스 API는
동시에 여러 객체들이 특정 자원에 접근할 때 락(Lock)을
통해 원자성을 보장해준다. 여기서
락이란 금고의 열쇠를 채우는 것처럼 다른 객체가 해당 자원에 접근하지
못하도록 하는 기능을 말한다.
이를 이용해 해당 자원의 안정성과
독점을 제어할 수 있다.
동시성 제어 서비스에서 제공하는 락
모드는 다음과 같다:
read, write, intension read, intension
write, upgrade
이들 락모드는 한 객체에 설정되는 락집합(lockset)을
통해서 사용된다. 락집합은
특정 자원에 연관되어 있는 락들의 집합니다.
여기서 자원이란 변화되는 데이타를
갖는 객체를 의미한다. 만일,
특정 객체가 트렌젝션의 영향을
받고 이를 보호하기 위해 락을 사용한다면 먼저 해당 객체의 락집합을
생성해야 한다. 왜냐하면
모든 락들은 락집합을 통해 얻어지기 때문이다.
CORBA 동시성 제어 서비스는 이러한
락집합을 제어하기 위해 락조정자(lock
coordinator)를 제공한다.
락조정자는 commit이나
rollback을
통해 트렌젝션이 완수되면 해당 락들을 풀어주는 역할을 수행한다.
이를 위해 동시성 제어 서비스는
다음의 인터페이스를 제공한다 -
LockSetFactory , LockSet , TransactionalLockSet, , lockCoordinator
.
3.2.3 COSS3
네트웍을 기반으로 한 분산 환경하에서
운영되는 시스템들의 골치거리 중 하나는 보안 문제이다.
외부로 부터의 불법적인 침입은
전체 시스템의 운영과 무결성에 치명적인 문제를 일으킨다.
특히,
분산 객체 시스템은 기존의 다른
분산 시스템과 달리 구성 측면에서 동적으로 규모 조정가능하며 클라이언트인
동시에 서버 역할을 수행하기 때문에 보안상의 많은 고려사항이 존재한다.
이러한 보안상의 문제를 해결하고자 제안된
서비스가 객체보안 서비스이다.
객체 보안 서비스는 OMA
아키텍쳐에 전체에 걸쳐 적용되며
무결성과 신뢰성 등 다른 기능들과 밀접하게 연관되어 있다.
현재 객체 보안 서비스는 ORB에
기반한 보안 메커니즘을 제공한다.
다시 말해 ,
별도의 보안 모듈없이 ORB
자체에서 보안 기능을 담당하는
것이다. 이러한
방법은 보안 메커니즘으로 인해 발생하는 성능 저하 문제를 최소화
시킬 수 있다.
다음은 객체 보안 서비스에서 제공하는 ORB기반의 보안 모델이다. 이 모델은 C2 차원의 보안 기능을 제공한다. C2는 미정부가 제정한 보안 표준 등급으로 운영체제등에 접근하기 위해 사용자ID와 암호 등의 인증(Authentication) 절차를 거치도록 한 것을 말한다. 일반적으로 운영체제의 경우, 패스워드를 기반으로 한 인증 메커니즘을 사용한다. 그러나 패스워드 중심의 인증 메커니즘은 해커같은 외부의 공격자로 부터 쉽게 공략된다. 이러한 문제를 미연에 방지하고자 CORBA 보안 서비스는 커버로스같은 제3의 인증 서버에 의한 인증 메커니즘을 제공한다. 다음 그림은 객체 보안 서비스 모델이다. 이 모델의 특징은 모든 보안 메커니즘이 ORB내부에 위치한다는 것이다. 또한 CORBA 서비스를 이용하는 클라이언트 객체는 ORB내부에서 제공하는 인증 서버를 통해 유일한 인증ID를 제공받고 이를 통해 안전하게 서비스를 이용할 수 있다는 것이다. 인증ID는 오직 ORB내부에 있는 인증 서버를 통해서만 관리되고 변경된다. 클라이언트는 인증ID를 받은 후 원하는 구현 객체와 통신하기 위한 보안 토큰을 전달받는다. 이 토큰을 갖고 구현 객체와 통신을 하며 서비스를 이용할 수 있다.

[
그림 3-36
] 객체 보안 서비스 모델
클라이언트 객체가 부여받은 인증ID는
ORB를
통해 구현 객체에게 자동적으로 알려진다.
구현 객체는 해당 자원에 대한
클라이언트의 접근 심사를 수행한다.
이 과정을 인가(Authorization)과정이라
한다. 이
인가 과정은 접근 조정 목록(ACL,Access
Control List)을 참조하여 이루어
진다. ACL을
통해 클라이언트의 접근 자격이 적합하면 구현 객체는 서비스를 제공한다.
이러한 인증 및 인가 과정 외에
객체 보안 서비스는 ORB상의
이벤트를 관리하고 모니터링하기 위해 감사(Audit)
기능을 제공한다.
미국같이 아주 넓은 나라에서는 주마다
시간의 차이가 발생한다. 따라서
각 지역에 해당하는 시간 차이를 인지하지 못한다면 약속이나 시간별
계획은 무산되고 말 것이다. 마찬가지로
시간은 프로그램마다 다르게 표현되고 컴퓨터마다 다르다.
예를 들어,
X/Open DCE의 시간 서비스는 절대시간을
3자리의
이진수로 표현한다.
결국,
ORB를 기반으로 한 분산 환경하에서
특정 시간 순서에 따른 이벤트를 처리하기 위해서는 이들 시간을 동기화시키는
서비스가 필요하다. 바로
이 서비스가 시간 서비스이다.
CORBA 시간 서비스는 DCE
시간 서비스가 사용하는 것과
동일한 시간 표현 방법인 UTC(Universal
Time Coordinated)를 사용한다.
UTC는 항상 그리니치 시간 지역을
참조한다.
3.2.4 COSS4
전화료나 TV시청료를
내는 것처럼 특정 서비스를 이용하고 이용료를 내는 것은 당연한 이치이다.
서비스 제공업자가 제공한 서비스에
부응하는 대가를 받지 못한다면 어떻게 될까?
마찬가지로 인터넷같은 네트웍상에서도
여러 서비스들의 사용료를 받기 위한 방법들이 필요하다.
이런 목적에서 만들어진 서비스가
라이센스 서비스이다.
라이센스 서비스는 본래 IBM,
디지탈,
그레디언트사에서 제안하였다.
CORBA 라이센스 서비스는 ORB를
기반으로 한 컴포넌트들의 사용에 대한 라이센스를 관리하는데 관심을
둔다.
라이센스 서비스는 컴포넌트들에 대한
라이센스를 관리하기 위해 두개의 인터페이스를 제공한다-LicenseServiceManager
, ProducerSpecificLicenseService. LicenseServiceManager는
여러분의 컴포넌트에 적합하게 작성된 특정한 라이센스 서비스를 이용하게
해주며 ProducerSpecificLicenseService는
컴포넌트가 사용되어 질 때 사용자에 대한 정보를 전달받는 기능(start_use)과
사용을 마쳤을 때 서비스를 종료하는 기능(end_use),
그리고 주기적으로 서비스의 사용을
검사하는 기능(check_use)을
제공한다.
CORBA에서
모든 객체는 IDL을
통해 정의되는 정적인 속성만을 갖는다.
그러나 분산 환경하에서 객체를
조작하다 보면 이와 달리 동적으로 특정 객체에 새로운 속성을 정의할
필요가 있다. 바로
이런 기능을 제공하는 것이 특성 서비스이다.
특성 서비스는 동적으로 특정 객체와
관련된 속성을 추가할 수 있는 기능을 제공한다.
다른 표현으로 말하자면,
프로그램 수행중에 새로운 데이타
멤버를 클래스에 추가하게 해주는 기능이다.
특성 서비스를 제공하기 위해 CORBA는 동적으로 작성되는 속성의 자료형으로 any 타입을 사용한다. any로 작성된 속성은 프로그램 수행중에 어떤 자료형으로도 변환되어 사용될 수 있다. 또한 PropertySet과 PropertySetDef라는 인터페이스를 제공한다. PropertySet은 객체의 특성들에 대한 검사나 삭제, 특성 정의 등을 지원하며 PropertySetDet는 PropertySer을 상속받아 특성들의 모드를 변경하고 제어하는 역할을 한다.
현재 가장 일반적으로 이용되는 데이타베이스는
보통 관계형 데이타베이스 시스템이다.
이 들 시스템이 각광받는 이유
중 하나는 SQL(Structured Query
Language)이라는 질의어를 제공하기
때문이다. 많은
사람들이 표준화된 SQL을
사용하여 손쉽게 원하는 데이타를 저장하고 추출할 수 있다.
마찬가지로 객체지향 시스템에서도
이와 유사한 방법들을 필요로 한다.
현재 객체지향 데이타베이스의
표준화를 진행하고 있는 ODMG는
객체지향 표준 질의어로 OQL(Object
Query Language)을 제안하였다.
현재 OMG는
이들 표준화 과정에 참여하고 있다.
이러한 노력들의 일환으로 IBM을
비롯하여 사이베이스, 선소프트
, 탤리전트
등 여러 관련 회사들(Tailgent,Itasca,Objectivity,Obtos,O2)이
CORBA 질의
서비스를 작성하였다. 여러분이
이 질의 서비스를 이용하여 원하는 질의를 수행하면 그 결과로서 컬렉션(collection)
형태의 결과를 되돌려 받는다.
뒤에서 설명하겠지만 컬렉션은
일련의 객체들의 묶음이다. 따라서
질의 서비스는 컬렉션 서비스와 밀접하게 연관되어 있다.
현재 질의 서비스는 크게 컬렉션 인터페이스와
질의 인터페이스로 제공된다. 컬렉션
인터페이스의 경우 새로운 컬렉션을 생성해 주는 CollectionFactory와
생성된 컬렉션에 원하는 객체들을 추가(add_element)하거나
삭제(remove_element)하는
등의 기능들을 제공하는 Collection
인터페이스,
컬렉션상의 객체들을 찾기 위해
앞,뒤로
컬렉션상의 위치를 이동시켜 주는 Iterator
가 있다.
질의 관련 인터페이스는 실제 질의를
작성하고 이를 수행하며 수행 결과를 컬렉션으로 제공해주는 역할을
한다. 해당
인터페이스로는 사용자가 명시한 질의의 정당성을 평가하고 수행해
주는 역할을 하는 QueryEvaluator와
사용자의 질의를 구성해주는 Query인터페이스,
그리고 Query객체를
생성하고 QueryEvaluator를
관리하는 QueryManager인터페이스가
있다. 마지막으로는
QueryEvaluator와
Collection 인터페이스를
상속받아 특정 컬렉션 객체에 대한 질의를 수행하게 해주는 QueryableCollection
인터페이스가 있다.
3.2.5 COSS5
전화 번호를 조회하기 위해 가장 손쉽게
이용할 수 있는 방법은 114 전화
안내를 이용하는 것이다. 원하는
인명이나 상호 등을 알려주면 해당 전화번호를 알 수 있다.
CORBA에서 트레이딩 서비스는
바로 114 전화
안내같은 서비스이다. 만일
CORBA를
이용하여 새로운 구현 객체를 구현했다고 하자.
이 구현 객체를 이용하기 위해서는
미리 어떤 서비스를 이용할 수 있고 이 서비스를 이용하기위해서는
미리 프로그램 작성 중에 무슨 인터페이스가 필요한 지 알아야 만
한다. 그러나
이 구현 객체를 트레이딩 서비스를 통해 등록하면 프로그램 수행 중에
구현 객체를 이용할 수 있다. 마치
114 데이타베이스에
새로운 인명이나 상호를 등록하고 이를 이용하는 것과 같다.
클라이언트 객체는 프로그램 수행
중 트레이딩 서비스를 통해 원하는 서비스를 제공하는 구현 객체를
찾고 동적 호출 기능을 사용하여 원하는 서비스를 호출할 수 있다.
컬렉션이란
객체들을 일련의 묶음으로 만들어 주는 역할을 제공한다.
예를 들어,
여러분은 동일한 객체들을 일렬로
묶거나(list) , 서로
다른 객체들의 꾸러미(bag)로
만들 필요가 있다. 이러한
기능을 제공하는 것이 컬렉션 서비스이다.
일반적으로 컬렉션에는 리스트(list),
스택(stack),
백(bag),
큐(queue),
배열(array),
트리(tree)
객체들이 포함된다.
이들 컬렉션 객체들은 내부에 객체를
추가하거나(add) 삭제(delete)하는
등 다양한 메소드를 제공한다.
특히,
이 들 컬렉션 객체는 주로 질의
서비스와 함께 사용된다.
간혹 프로그램을 이용하거나 개발하다
보면 버전(version)이라는
용어를 자주 듣는다. 버전은
시간의 진행에 따른 프로그램의 변화 정도를 의미한다.
다시 말해,
버전이 높을 수록 가장 최근에
개발된 것을 의미한다. 이와
유사하게 객체 변화 관리란 시간에 따른 객체의 변화추이를
관리하는 것을 말한다. 객체
변화 관리를 다른 말로는 버전 관리라고도 한다.
CORBA 객체들은
두개의 관점에서 시간적 변화를 갖는다.
먼저,
IDL로 정의한 인터페이스들이
시간에 따라 변경될 수 있으며 개발된 컴포넌트들이 시간에 따라 변화될
수 있다. 객체
변화 관리 서비스는 이들 모두의 시간 추이에 따른 변화를 관리한다.
따라서 객체 변화 관리 서비스를
이용하면 해당 객체들의 버전을 알 수 있다.
이 버전 정보를 이용해 이전에
개발된 구현 객체 외에 새롭게 개발된 다른 버전의 동일 객체를 이용할
수 도 있다.
앞서 COSS1에서 COSS5 까지 CORBA 서비스로 규정된 서비스들에 대해 살펴보았다. 이들 기능 외에 있는 새롭게 제안되고 있는 서비스들이 있어 간략하게 소개하도록 한다.
객체 기동 서비스는
시스템 파괴나 오동작시 객체와 트렌젝션의 상태를 원상태로 회복시키는
기능을 말한다. 일반적으로
DBMS에서는
회복(recovery) 기능이라고
말한다.
메세징 서비스는
객체간에 주고받는 메세지들의 트래픽을 보다 신뢰성있고 비동기적으로
전송하는 서비스를 말한다.
4장.CORBA
지원 기능들(Common
Facility)
앞서 살펴본 CORBA
서비스들은 실제 CORBA
공급업체나 제3의
서비스 개발 회사에서 작성하여 공급하는 것이다.
따라서 일반 사용자나 프로그래머는
이들 서비스의 구현에 대해 자세히 알 필요가 없다.
단,
어떤 기능을 제공하는 것인지는
명확히 이해해야 한다. CORBA 서비스
외에 OMA는
CORBA를
적용하여 시스템을 구축할 때 특정 도메인에 필요한 공통의 기능들을
제공한다. 예를
들면, 은행은
은행 나름대로의, 통신은
통신분야 나름대로의 특성에 맞는 기능들을 필요로 한다.
이러한 도메인별 공통 기능들을
CORBA 지원
기능들(CORBA Facility)이라
한다. 다음
[그림3-37]은
OMA상에서
CORBA 지원
기능들을 보여준다. CORBA 지원
기능들은 OMG의
DTC(Domain Technology Committee)에서
작성했으며 현재도 계속해서 추가하고 있다.
이번 장에는 CORBA
지원 기능들을 자세히 살펴보도록
한다. 만약
여러분이 CORBA를
실제 적용하는 데 관심이 있다면 주의깊게 살펴봐야 할 것이다.

[
그림3-37
] CORBA 지원 기능들
4.1 CORBA 지원
기능(facility)이란?
CORBA 지원
기능은 CORBA 서비스와
달리 아주 상위 차원의 서비스들이다.
다시 말해,
CORBA 시스템에서 제공하는 시스템
기능이라기 보다 사용자측면에서 제공되는 서비스들이다.
예를 들면,
사용자 인터페이스 기능을 강조하는
컴포넌트 표현 기능(Compound Presentation
Facility , RFP1)이나 시스템
관리 기능(System Management Facility,
RFC1)들이 이에 해당된다.
또한 CORBA
지원 기능은 시스템 차원이 아니라
응용 프로그램 차원의 상호 연동 서비스이다.
예를 들면,
데이타 교환 기능(Data
Interchange Facility , RFP3)이나
복합 문서 교환 기능(Compound
Interchange Facility, RFP1)은
CORBA를
기반으로 하여 개발된 응용 프로그램들 간의 상호 연동을 가능하게
해준다.
아울러 CORBA
지원 기능은 비지니스 분야나
은행, 보험
등 다양한 현실 세계의 도메인에서 사용될 수 있는 인터페이스들을
지원한다. 예를
들면, 비지니스
객체 프레임웍 (Business Object
Framework Facility,RFP4)과 금융
서비스( Financial Service) 등은
비지니스 분야와 금융 분야에서 필요한 다양한 기능들을 제공한다.
현재 CORBA
지원 기능은OMG에서
진행중인 표준안으로서 크게 수평 지원 기능(Horizontal
Facility)과 수직 지원 기능(Vertical
Facility)으로 나뉜다.
수평 지원 기능은
거의 모든 도메인에서 공통적으로 필요한 기능들을 제공한다 -
복합 문서(compound
document), 도움 기능(Help
Facility), 시스템 관리 기능
등이 이에 해당한다. 이에
반해 수직 지원 기능은 보험,
통신,
금융 분야처럼 특정 분야의 응용
시스템을 구성하는 데 필요한 기능들을 제공한다.
이러한 기능들은 OMG의
DTC에서
제정된다.
4.2 CORBA 지원
기능과 서비스와의 차이점은 ?
실제 OMA에는
CORBA 서비스들과
지원 기능들을 분명하게 구분하지는 않는다.
그러나 :
4.3 CORBA 수평
지원 기능들
CORBA 수평
지원 기능들은 크게 4개의
분야로 나뉘어져 있다. 각각의
분야는 다음과 같다.
사용자 인터페이스는 사용자에게 해당 정보 시스템에 접근하게 해주며 사용자의
요구에 대한 결과를 제공한다.
지원 기능들 :
| 렌더링 관리 | 프린팅이나 화면 출력같이 객체들을 표현하는 데 필요한 일반적인 기능들을 지원한다. |
| 복합 표현 관리 | 한 문서내에 다른 형태의 객체를 삽입하는 것처럼 복합 문서내에서 객체들의 표현을 지원한다. |
| 사용자 지원 | 도움말 기능이나 철자 검사처럼 사용자들이 일반적으로 필요로 하는 기능을 지원한다. |
| 데스크 탑 관리 | 최종 사용자가 사용하는 데스크탑에서 필요로 하는 기능 등을 지원한다. |
| 스크립팅 | 자동화 스크립트를 손쉽게 작성하게 해준다 |
정보 관리는 정보의 모델링에서 부터 정의, 저장, 추출, 관리, 교환에 이르기까지
정보를 처리하는 데 필요한 모든 기능을
제공한다.
지원 기능들 :
| 정보 모델링 | 정보 모델링과 스키마 작성을 지원한다. |
| 정보 저장과 추출 | 정보의 지속적 저장과 추출을 지원한다. |
| 복합 문서 교환 | 복합 문서내의 데이타 교환을 지원한다. |
| 데이타 교환 | 데이타간의 일반적인 교환을 지원한다. |
| 정보 교환 | 정보간의 교환을 지원한다. |
| 데이타 인코딩과 표현 | 데이타 형태간의 교환과 인코딩을 지원한다. |
| 시간 연산 | 달력 데이타와 시간 데이타의 조작을 지원한다. |
서비스 제공자들의 복잡한 정보 시스템들을
관리하는 데 필요한 기능을 제공한다.
지원 기능들 :
| 관리 도구들 | 관리 도구들과 컬렉션 관리 기능사이의 상호 호환을 지원한다. |
| 컬렉션 관리 | 컬렉션 관리 기능과 관리되는 객체들 사이의 통합을 지원한다. |
| 조정(control) | 시스템 자원들과 관리되는 객체들 사이의 조정을 지원한다. |
웍플로우 시스템처럼 작업의 자동화를
제공한다. 이
지원 기능에는 시스템에 참여하고 있는 사용자 프로세스와 시스템
프로세스 모두의 자동화를 지원한다.
| 에이젼트 | 지정한 명령을 자동으로 수행하는 에이전트를 동적과 정적 형태 모두 지원한다. |
| 룰 관리 | 지능형 에이젼트 처럼 규칙에 기반한 객체들의 실행 및 관리 기능을 지원한다. 여기서 룰이란 특정 이벤트시 발생하는 행동을 말한다. |
| 자동화 | 특정 객체의 주요 기능들에 다른 객체들이 접근할 수 있게 해준다. |
| 웍 플로우 | 작업 과정의 일부인 객체들의 관리와 조정 기능을 지원한다. |
4.4 CORBA 수직
지원 기능들
CORBA 수직
지원 기능들은 특정 분야에서 공통적으로 필요한 기능들을 정의한다.
다음은 해당 지원 기능들이다.
| 이미지 | 이미지 객체들이나 이미지와 연관된 정보, 이미지 응용 서비스들 사이의 상호 연동을 지원한다. |
| 정보 초고속도로 | 인터넷이나 WAN 환경하에서 복수 사용자에 대한
응용 서비스를 지원한다. |
| 제조 | 제조 객체들 사이의 상호 연동을 지원한다. |
| 분산 시뮬레이션 | 가상의 환경하에서 여러 객체들간의 시뮬레이션을 지원한다. |
| 정유 및 가스 생산 및 개발 | 석유 산업에 관련된 시스템에서 필요한 기능을 지원한다. |
| 계정 | 은행 같은 곳의 상용 트렌젝션을 지원한다. |
| 응용 프로그램 개발 | 응용 객체들간의 상호 호환을 지원한다. |
| 매핑 | 서로 매핑(연결)되는 객체들 사이의 상호 연동을 지원
한다. |
:
4.5 CORBA 지원
기능의 발전 과정
현재 CORBA
지원 기능은 OMG의
DTC에
의해서 계속 확장 중에 있다. 다음은
DTC에
의해서 제출된 기능들을 정리한 것이다.
참고로 RFP란
Request for Proposal 의
약자로 해당 기능을 표준으로 검토해 달라는 의미에서 제출된 문건을
의미한다.
RFP1
데스크탑에
표현된 복합 문서를 관리하기 위해 필요한 기능을 지원한다.
클립보드나 끌어다놓기, 문서간 연결 기능처럼 복합 문서의 각 부분간의 상호 호환을
위한
기능을 지원한다.
노벨, IBM, Apple, CI labs 에서 참여하여 CORBA기반의 복합 문서를 구현하였다. 이 복합
문서는 다양한 플랫폼상에서 수행되며
마이크로소프트의 OLE/COM과
완전히 호환된다.
RFP2
각 나라의 언어에 맞는 로컬화( localization )와 다국어 지원 및 변환을 위해 필요한 기능
을 지원한다.
시간
객체, time 데이타
타입 , time 메소드들,
그리고 시간 변환을 지원한다.
RFP3
객체들 사이의 데이타 전송과 응용 프로그램 수준의 상호 호환을 위한 토대를 제공한다.
객체의
동적인 이동 기능(mobility)과
유용성을 지원하기 위한 토대를 제공한다.
RFP4
객체들 사이의 데이타 전송과 응용 프로그램 수준의 상호 호환을 지원하기 위한 토대를
제공한다.
특정 분야의 응용 프로그램에서 필요로 하는 공통적인 비지니스 객체들을 이용하기 위한
토대를 제공한다.
이상의 기능들 외에도 객체들 자체에
대한 정보를 관리하기 위한 메타 객체 지원 기능(
RFP5 , Meta Object Facility)과
프린트 지원 기능(RFP6) , 그리고
우리나라나 중국처럼 2바이트
문자를 사용하는 아시아 나라들의 언어 문제를 처리하기 위한 아시안
입력 지원 기능(RFP7)이
계속 발표되고 있다.
3막을 마치며
지금까지 시스템 통합을 위한 객체 프레임웍으로서
OMA에
대해 자세히 살펴보았다. 3막에서
살펴본 내용은 다음과 같다.
CORBA는
OMG에서
제정한 객체를 기반으로 한 시스템 통합 기술이다.
OMG는 현존하는 객체기술에 기반한
프레임웍으로서 OMA를
제정하였다. OMA는
분산된 환경하에서 객체간의 통신을 담당하는 CORBA와
CORBA를
기반으로 한 객체 응용 시스템에서 필요로 하는 기능들인 CORBA
서비스,
그리고 CORBA를
특정 분야에 적용하는 데 있어 공통적으로 필요한 기능들을 지원하기
위한 CORBA 지원
기능들로 구성된다.
특히,
이러한 기능들을 이용하기 위해
사용하는 IDL이라는
언어는 특정 구현언어에 종속되지 않고 원하는 인터페이스만을 정의함으로서
손쉽게 분산 환경하에서 시스템을 작성하게 해준다.
[ 다음 | 이전 ]