세번째 마당. 객체
프레임 프로그래밍
4막 CORBA 프로그래밍
1장 CORBA IDL
1.1 CORBA 인터페이스란?
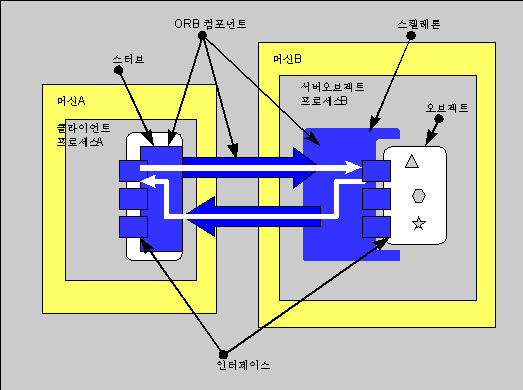
CORBA 인터페이스는
말 그대로 CORBA 클라이언트와
서버 구현 객체 사이의 창구이다. 인터페이스는
[그림4-1]처럼
CORBA 객체
모델에서 외부에 자신의 모습을 보여주는 얼굴 역할을 하며,
서버 구현 객체와 클라이언트를
구분 짖는 경계선이다. 또한
인터페이스는 클라이언트에게 구현 객체가 어떤 모습을 하고 있는지(어떤
메소드를 제공하는 지), 그리고
어떻게 상호작용을 하는 지에 대한 내용을 정의하고 있다.
다시 말하면,
인터페이스는 클라이언트와 구현
객체 쌍방간에 맺어진 통신 규칙이라 할 수 있다.
앞에서 살펴본 것처럼 CORBA
표준에서 제공하는 모든 서비스와
지원 기능들은 모두 IDL로
표현된다. IDL(Interface Definition Language)은
해당 객체의 인터페이스와 관련된 기능, 표현
형태, 관련
성격 등의 내용을 기술하고 있다. 아울러
CORBA 인터페이스는
오퍼레이션(메소드),
속성, 그리고
데이타 타입으로 정의된 집합체이며, 다른
인터페이스들로 부터 모든 기능을 상속받을 수 있다.
이런 인터페이스를 통해서 CORBA는
구현언어에 중립적이고 플러그-앤-플레이가
가능한 컴포넌트 소프트웨어 환경을 제공하고 있다.
1.2 CORBA IDL
OMG IDL은
구현 객체가 제공하는 인터페이스를 기술하기 위한 언어이다.
이 인터페이스를 이용하여 클라이언트는
구현 객체의 서비스를 호출한다. 따라서
OMG는 CORBA
객체의 인터페이스를 정의할 때
반드시 CORBA IDL언어를
사용하도록 요구하고 있으며, CORBA 표준에
IDL로 작성된
인터페이스를 C++과
같은 구현 언어로 변환하기 위한 규칙을 기술하고 있다.
OMG IDL로 정의된
인터페이스는 오퍼레이션, 오퍼레이션의
매개변수, 그리고
예외 처리 요소로 구성된다. IDL의
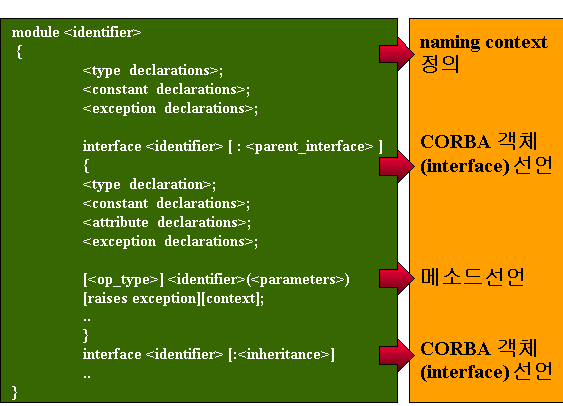
문법 구조는 [그림4-2]와
같다. IDL 문법을
이 책의 앞부분에서 살펴본C++언어의
문법과 아주 유사하다. 먼저
가장 큰 범위로 이름 컨텍스트(naming context)가
있다. 이름
컨텍스트는 내부에 정의되는 것들을 하나의 이름 공간에 정리해 두는
역할을 한다. 이름
컨텍스트 내부에는 다양한 변수와 상수를 선언할 수 있다.
아울러C++에서
클래스를 선언하는 것처럼 CORBA객체를
인터페이스 정의를 통해 선언한다. 아울러
인터페이스는 내부에 복 수 개의 메소드를 선언할 수 있다.
기억할 것은 IDL은
구현언어가 아니라 클라이언트와 구현 객체사이의 인터페이스를 정의하는
언어라는 사실이다. 이
때문에 IDL은
인터페이스 정의어라고 명명되었다.
자! 정리하는
차원에서 앞서 살펴본 IDL 구조를
바탕으로 예제 IDL 파일을
작성해 보자. 다음은
vehicle 과
owner라는
인터페이스를 상속받아 automobile이라는
인터페이스를 선언한 예이다. 전체
이름 컨텍스트는 MyCars이다.
MyCars내부에는 typedef를
통해 새로운 데이타 형을 선언했으며 과속시 예외상황을 발생시키는
overspeed 예외상황을
정의하였다. 또한
vehicle과
owner라는
인터페이스도 선언하였다. 관심을
끄는 부분은 automobile 인터페이스의
선언이다. automobile 인터페이스는
vehicle과
owner 인터페이스를
다중상속 받는다. 다시
말해, vehicle과
owner 인터페이스에
정의된 모든 것들을 선언없이 이용할 수 있다.
다음 절에서 IDL
문법에 대해 살펴보면 보다 정확히
다음 예제를 이해할 수 있을 것이다.
module MyCars{
typedef string Indentifier;
exception overspeed(short currentspeed);
interface vehicle { }
interface owner {
attribute integer age;
attribute string name;
...
}
interface automobile : vehicle , owner {
attribute string car;
void go (in int speed) raises(overspeed);
void turn_right() raises(overspeed);
void turn_right(in int speed) raises(overspeed);
...
}
}
[ 예제
4-1 ] IDL 작성
예
IDL은 C,
C++, 스몰톡,
자바 같은 구현 언어에 중립적이다.
그러나 IDL
문법은 ANSI
C++ 및 자바 언어의 문법과 아주
유사하다. 실제
자바 문법이C++보다
IDL에 더
유사하다. 이
책에서는 자바 언어에 대해 자세히 다루지 않지만 여러분은 이 책의
다음 판에서 자바 언어를 사용하여 CORBA를
다루는 방법에 대해 얻을 수 있을 것이다.
일단 작성된 IDL은
IDL 컴파일러에
의해 실제 프로그래머가 사용하는 프로그램 언어로 변환된다.
이때 변환 가능한 언어로는 현재까지
C, C++, 스몰톡이
있으며, 현재
Ada와 COBOL
, 자바 변환 규칙을 제정하는
작업을 진행하고 있으며 거의 마무리 되었다.
그러나 실제 자바 언어의 광범위한
확산과 아울러 많은 제품들이 이미 자바 변환 기능을 제공하고 있다.
1.3 CORBA IDL 문법
앞서 언급한 것처럼 CORBA
IDL 문법은 C++과
아주 유사하다. 만약
미리 C++을
알고 있거나 1막에서의
내용을 익혔다면 손쉽게 배울 수 있을 것이다.
C++과 동일하게
"//"와
"/* .. */"
모두 사용이 가능하다. //는
한 줄 주석이고 /* .. */ 은
복수 줄에 대한 주석이다.
IDL은 [표4.1]과
같은 예약어를 가지고 있다. 대부분
C++에서
사용하는 것과 동일하며 실제 사용방법과 의미도 동일하다.
몇가지 특이한 것들로는 다음과
같은 것들이 있다.
해당 메소드 호출 후 바로 그 결과를 처리하지 않고 나중에 처리할 수
있다.
| any default inout out switch attribute double | interface raises TRUE boolean enum long readonly | typedef case exception module sequence unsigned char | FALSE Object string short union const float | octet void context in oneway struct |
[표 4-1 ] IDL 예약어
인터페이스에서 오퍼레이션(메소드)를
선언할 경우 반드시 오퍼레이션의 매개변수,
반환 값의 데이타 형을 지정하여야
한다(참고로
오퍼레이션과 메소드는 같은 의미이다. 그러나
CORBA의
표준에서는 오퍼레이션이란 용어를 사용하므로 여기서는 가급적 메소드보다는
오퍼레이션이런 용어를 사용하기로 한다). IDL은
기본적인 데이타 형 (char, short, long, float),
구조체 유형(struct,
union, enumeration), 그리고
템플릿 유형(sequence, array, string)을
지원한다. IDL은
any 데이타
형도 제공하는데 이 유형은 어떠한 IDL 데이타
형이라도 표현할 수 있다. 예를
들면, 어떤
오퍼레이션의 매개변수가 받을 수 있는 데이타 형이 다양한 경우 any
데이타 형을 사용한다.
이들 데이타 형은 typedef를
사용하여 다른 이름(alias name)으로
바꿀 수 있다.
IDL은 세가지 유형의
구조체를 지원한다- 구조체,
유니온,
나열.
- 구조체(Structure)
연관 관계가 깊은 데이타들에 대표되는
이름을 부여 함으로써 해당 데이타들을 그룹으로 묶을 수 있다
| struct date {
unsigned short month; unsigned short day; short year; }; |
- 유니온(Union)
서로 다른 데이타 형과 크기를 가지고
있는 데이타들이 있을 경우 공통의 이름으로 필요한 데이타 형 및
변수를 선택하기 위해 사용한다. C나
C++와 달리
각 데이타 멤버는 case 라벨과
함께 선언된다.
|
union token switch (long) { case 1: char cval; case 2: float fval; case 3: double dval; default: long lval; }; |
- 나열(enumeration)
데이타 멤버들을 특정 순서로 나열할
때 사용하며, 첫번째
멤버에 특정 숫자를 지정하지 않으면 0 값이
할당되고 나열된 순서대로 1씩
증가 된다. 다음
예에서 Monday에는
0이 할당된다
| enum workday { Monday, Tuesday, Wednesday, Thursday, Friday }; |
IDL은 두 종류의
템플릿 유형을 제공한다 - sequence와
string.
- 시퀀스(Sequence)
선택적으로 최대 크기를 선언할 수 있는 1차원 배열이다 시퀀스가 최대 크기를 가지고 있다면 바운드 시퀀스(bounded sequence)라 하고, 최대 크기가 없으면 언바운드 시퀀스(unbounded sequence)라 한다. 시퀀스의 길이는 할당되는 값에 따라 동적으로 변경되며, 최대값을 가지고 있는 시퀀스는 최대 크기를 넘을 수 없으며, 시퀀스가 취할 수 있는 유형은 어떤 IDL 유형이라도 가능하다.
typedef를 사용하여
데이타 형에 새로운 명칭을 부여한다.
| 바운드 시퀀스
typedef sequence<long, 64> vec64; 언바운드 시퀀스 typedef sequence<long> vec; |
- 문자열(String)
시퀀스와 동일한 방법으로 사용하나,
시퀀스와 다른점은 단지 문자형만으로
이루어진 1차원
배열이라는 점이다. 이것
역시 바운드 문자열과 언바운드 문자열 두 종류를 사용한다.
|
바운드 문자열
typedef string<16> name16; 언바운드 문자열 typedef string name; |
IDL은 C나
C++와 달리
배열의 크기가 고정되어 있는 다차원 배열이다.
그러므로 프로그래머는 반드시
배열의 크기를 정해 주어야 하며 typedef로서
배열 이름을 부여한다.
|
바운드 문자열 typedef short table[64][64]; |
한번 초기화된 값을 변경할 수 없는 데이타
형이다. 상수형은
다음과 같은 데이타 형과 함께 선언 될 수 있다.
| boolean | short | char |
| string | double | unsigned long |
| float | unsigned short | long |
[표4-2]
상수 선언 가능 데이타 형
앞서 소개 했듯이 인터페이스는 구현
객체가 제공하는 속성과 오퍼레이션들에 대해 정의한 명세이다.
인터페이스 구성 요소들과 인터페이스
정의를 위한 메커니즘은 다음과 같다.
- 오퍼레이션(Operation,
메소드)
오퍼레이션은 인터페이스 내부에 선언되어야
한다. 인터페이스를
구성하는 오퍼레이션은 오퍼레이션 매개변수,
예외처리(exception),
반환 값의 유형,
매개변수의 전달 방향으로 구성된다,
다음 예는 getOuote와
getLowHigh 오퍼레이션을
보여주고 있다. 데이타
형 앞에 있는 in과
out은 매개변수의
전달 방향이다.
| typedef float quote;
typedef float price; interface QuoteService { quote getQuote( in string stock); void getLowHigh(in string stock, out price low, out price high); }; |
| 속성 | 의 미 |
| in | 매개변수가 클라이언트에서 구현 객체로 전달 |
| out | 매개변수가 구현 객체에서 클라이언트로 전달 |
| inout | 양방향 모두 가능 |
[표4-3] 매개변수 전달 방향 속성
- 예외 처리(Exception)
예외 처리는 클라이언트가 구현 객체의
오퍼레이션을 호출한 후 서비스 요청에 대한 결과로서 특별한 예외
상황이 발생했을 때 클라이언트에게 되돌려 주는 데이타 구조 이다.
예외 처리에는 사용자가 직접
정의한 예외와 시스템에서 미리 정의된 예외,
두 종류가 있다.
주의할 점은 예외는 오퍼레이션의
매개변수나 다른 데이타 멤버 또는 다른 데이타 형으로 사용해서는
안 된다.
예외 처리를 선언하기 위해서는 어떤 오퍼레이션에 raises라는 키워드와 함께 예외 처리 이름을 선택적으로 부여할 수 있다. 다음 예는 사용자가 정의한 예외이다.
| typedef float quote;
typedef float price; interface QuoteService { exception no_quote { string reason }; quote getQuote( in string stock) raises (no_quote); void getLowHigh(in string stock, out price low, out price high); }; |
시스템에서 정의 한 예외는 어떤 서비스
요청에 대한 처리 결과로서 ORB가
내보내는 표준 실행 에러이다. 다음은
시스템 정의 예외 처리의 예이다.
|
Enum complete_status { COMPLETED_YES, COMPLETED_NO, COMPLETED_MAYBE }; ..... exception <시스템 정의 예외 명> { unsigned long minor; completion_status completed; } |
- 컨텍스트
구현 객체의 특정 오퍼레이션에 영향을
줄 수 있는 클라이언트 환경 요소와 관련된 리스트를 컨텍스트라 한다.
다른 말로는 클라이언트의 특성을
표현해주는 별칭으로 이해할 수 있다. 컨텍스트를
사용하기 위해서는 raises 문장
바로 뒤에 context(context1, context2, ...)
형태로 선언하여 주기만 하면
된다. 가능한
사용하지 않는 것이 좋다. 예를
들면, 다음
예는 Query라는
오퍼레이션의 결과를 BULK_TRANSFER_DEVICE
컨텍스트 객체를 통해 다른 장치로
옮기는 것이다. 참고로
유닉스의 그림 운영 체제인 X윈도우
시스템에 익숙한 사람이라면 디스플레이를 다른 곳으로 돌리는 것을
이해할 것이다. 이처럼
컨텍스트는 클라이언트의 내용을 다른 객체나 서버 구현 객체로 변경하는
기능들을 제공한다.
Status_t Query( in Query_t query, out DataObj_t reponse)
raises( BAD_PARAM , WRONG_SYNTAX, UNKNOWN_INPUT )
context(BULK_TRANSFER_DEVICE , WINDOWS_SYSTEM,
REP_PREFERENCE) ;
- 일방통행 오퍼레이션(Oneway
Operation)
일방통행이란 클라이언트가 구현 객체의
오퍼레이션을 호출하고 그 결과에 대해 당장 관심이 없음을 선언하는
것이다. 즉,
일단 클라이언트는 호출만하고
그 결과에 대해서는 클라이언트 및 구현 객체 모두 그 결과 값에 대해서는
책임을 지지 않음을 나타내는 것이다. 일방통행
오퍼레이션은 다른 일반적인 오퍼레이션 문장보다 먼저 선언돼야 한다.
|
interface alarms { oneway void notify(in string event); }; |
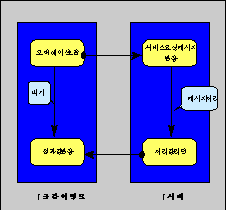
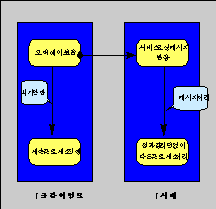
일반적으로 [그림4-3]처럼
클라이언트가 자신이 보낸 서비스 요청에 대한 응답을 기다리는 호출
방식을 블럭킹(blocking) 호출이라
하며, 일방통행
오퍼레이션같은 형태의 호출을 비블럭킹(non-blocking)
호출이라 한다.
애트리뷰트는 CORBA에서
정의한 독특한 오퍼레이션으로서 아래 예에서 보이는 것처럼 이것은
언뜻 보기에 특정 데이타 형의 변수를 선언한 것처럼 보이나 실제
오퍼레이션이라 생각하면 틀림이 없다. 이
오퍼레이션은 클라이언트가 특정 변수에 특정 값을 설정하거나 검색할
때에 손쉽게 IDL로
표현하기 위해 고안된 것이다 이것은 실제 C,
C++, 스몰톡같은 특정 프로그램
언어로 변환되어 _get과
_set 두개의
오퍼레이션을 생성한다. 애트리뷰트는
옵션으로 attribute 키워드
앞에 readonly를
사용할 수 있으며, 이
옵션이 선언된 변수는 할당된 값을 얻어오는 _get
오퍼레이션만을 생성한다.
| Interface MyInterface {
attribute float radius; }; |
기존에 작성된 인터페이스가 존재하는
경우 해당 인터페이스내에 선언된 모든 요소들을 그대로 물려받아
새로운 인터페이스를 정의 하는 것을 상속이라 한다.
다음 예에서는 QuoteService인터페이스를
상속받고 여기에 createGroup과
getGroupQuote 오퍼레이션을
추가한 파생 GroupQuoteService 인터페이스를
선언한 것이다.
|
#inlcude "QuoteService.idl" interface GroupQuoteService : QuoteService { void createGroup( in string groupName, in string symbol1, in string symbol2, in string symbol3); void getGroupQuote ( in string groupName, out quote quote1, out quote quote2, out quote quote3); }; |
QuoteService는 GroupQuoteService의
기반 인터페이스(base interface)라
하며 GroupQuoteService는
QuoteService의
파생 인터페이스라 한다. 그리고,
파생 인터페이스는 복수의 기반
인터페이스로부터 파생 될 수 있다. 기반
인터페이스는 간접(indirect) 기반
인터페이스와 직접 (direct) 기반
인터페이스 두 가지 종류로 구분 된다.
- 간접 기반 인터페이스
어떤 파생 인터페이스의 기반 인터페이스가
다른 기반 인터페이스로부터 파생된 인터페이스 일 때.
- 직접 기반 인터페이스
어떤 파생 인터페이스의 기반 인터페이스가 다른 기반 인터페이스로부터 파생되
지 않은 인터페이스
일 때.
파생 인터페이스를 정의할 때 파생 인터페이스는
동일한 오퍼레이션이나 애트리뷰트 이름을 가지고 있는 기반 클래스로부터
상속 받을 수 없으며, 또한
상속 받은 오퍼레이션과 애트리뷰트 이름을 재 정의 할 수 없다.
모듈은 정의하고자 하는 인터페이스들을
하나의 세트로 묶기 위한 이름공간(namespace)을
제공하며, 변수
이름과 같은 식별자(Identifier)들의
사용 범위를 제어하기 위해 사용한다. 모듈
내에서 적절하게 IDL 선언들에
대한 범위를 설정함으로서 다른 모듈에서 사용된 식별자들과 충돌이
발생하는 것을 피할 수 있게 해준다. 즉,
어떤 모듈에서 선언된 식별자는
그 모듈 밖에 정의되어 있는 식별자와 동일한 이름을 갖을 수 있다는
것을 의미한다.
어떤 모듈에서 사용된 식별자들을 외부에서
사용하고자 할 때에는 '::'(이름
해결 연산자, name resolution operator)앞에
모듈 이름을 붙여 사용한다. 아래
예제에서 첫 번째 경우(1)는
모듈 business 내에서
정의된 MaxVal과
모듈 외부에서 정의된 MaxVal은
별개의 식별자이다. business모듈내의
MaxVal을
사용할 때는 business::MaxVal 처럼
이름 해결 연산자를 사용하여 접근한다. 두
번째 경우(2)는
서로 다른 모듈에서 동일한 인터페이스를 선언한 예이다.
| (1) const long MaxVal = 100;
module business { const long MaxVal = 50; .... }; (2) module NYSE { interface QuoteService { ..... } }; module AMEX { interface QuoteService { ..... } }; |
any 형은 어떠한
IDL 값도
저장할 수 있는 데이타 형으로서 다양한 데이타 형을 전달해야만 하는
매개변수에서 사용된다. 또한
any는 다른
any 유형도
가능하다. any는
어플리케이션이 any에
저장되어 있는 데이타 형을 해석할 수 있게 해주는 Typecode
구조체를 포함하고 있다.
any는 C나
C++의 void*
와 유사하다고 생각할 수 있다.
Typedef는 특정
데이타 형에 이름을 부여하는 메커니즘이다.
프로그래머는 기본적인 데이타
형뿐 아니라 구조체형 데이타, 템플릿
유형에 이름을 부여한다. C,C++에서의
typedef와
동일하다.
2장 CORBA 프로그래밍
지금까지 우리는 CORBA
구조, 클라이언트와
구현 객체간의 통신 방법, 그리고
IDL 문법
구조에 대해서 살펴 보았다. 이제
실제로 CORBA 프로그램을
작성하는 방법을 살펴보면서 보다 구체적으로 분산 객체에 대해 살펴보자.
본 장에서는 아니오나사의 Orbix과
엑스퍼소프트사의PowerBroker를
사용한다.
2.1 Orbix 를
이용한 CORBA 프로그래밍
CORBA 응용프로그램
개발과정은 RPC(Remote Procedure Call)의
개발과정과 유사하다. 다시
말해, RPC에서
원하는 프로시져를 서버에 정의해두고 클라이언트에서 이를 호출하는
것처럼 CORBA 에서도
원하는 클래스와 메소드(오퍼레이션)를
서버 구현 객체에 정의해두고 이 메소드를 클라이언트에서 호출한다.
RPC상에서 서버와 클라이언트
응용 프로그램을 작성하는 과정에서 프로그래머에게 발생하는 어려운
부분들을 가려주기 위해 RPCGEN(RPC Generator)
이라는 컴파일러가 있듯이 CORBA에서는
IDL컴파일러가
존재한다. 가장
먼저 CORBA 응용
프로그램을 작성하는 데 있어 생각해야 할 일은 모든 객체지향 프로그램
개발과 마찬가지로 해당 문제에 적합한 클래스를 디자인하는 것이다.
이 책에서는 이러한 디자인 방법에
대해 다루지는 않는다. 이
책에서는 CORBA 프로그램을
작성하는 절차를 이해하고 CORBA의
작동원리를 이해하는 데 그 목적을 두고 있다.
이를 위해 여기서는 CORBA
표준을 구현한 제품 중 아이오나사에서
개발한 Orbix을
이용하여 응용 시스템을 작성하도록 한다. Orbix에
대한 보다 자세한 내용은 박스 기사를 참조하기 바란다.
먼저 편의상 예제 프로그램에서 사용할
시나리오를 구상해보자. 아주
간단하면서도 분산 프로그램을 이해하는 데 아주 적절한 예제인 격자(grid)를
사용하도록 한다. 격자는
2차원의
배열 형태를 갖는다. 따라서
격자(grid)는
폭(width)과
높이(height)라는
속성을 갖고 있으며 폭과 높이로 구분되는 지점에 특정한 값을 입력하는
set 메소드와
값을 얻어오는 get 메소드를
갖는다. 기타
다른 메소드를 지원할 수도 있지만 해당 메소드만으로 클래스를 구성하기로
한다. 정리하면
본 예제에서 사용되는 클래스는 다음과 같다.
프로그램 이름 gridSrv , gridCnt
클래스 이름 grid
애트리뷰트 short height
short width
메소드 set(width , height, value)
get(width,
height)
일단 grid클래스에
대한 이해가 끝났다면 본격적으로 grid 클래스를
이용한 클라이언트 프로그램과 서버 프로그램이 어떤 과정을 통해
상호작용 하는 지 알아보자.
grid 클라이언트 grid 구현 객체
set(1,1,10) 호출 클라이언트 서버 set(1,1,10) 수행
스터브 스켈로턴
get(1,1) 호출 get(1,1) 수행후
10을 반환
네트웍
[ 그림4-4
] grid 클라이언트와 서버 구현
객체사이의 작동 시나리오
네트웍을 경유한 분산환경에서 grid
클라이언트는 [그림4-4]에서
처럼 구현 객체에게 원하는 값을 입력하기 위해 set()
메소드를 호출한다.
이 메소드는 클라이언트의 스터브를
통해 다시 구현 객체의 스켈로턴을 거쳐 실제 코드가 존재하는 서버
객체상의 set() 메소드를
호출한다. 마찬가지로
원하는 위치의 값을 얻기 위해 클라이언트는 get()메소드를
호출한다. 구현
객체쪽에서 호출된 get()메소드는
해당 메소드를 수행한 후 결과 값을 다시 스켈로턴을 통해 클라이언트의
스터브를 통해 반환한다.
이 과정에서 프로그래머는 전혀 네트웍
기능을 제공하는 스터브와 스켈로턴에 대해 고민할 필요가 없다.
왜냐하면 CORBA가
자동적으로 필요한 코드를 생성해 주기 때문이다.
=================== Orbix에
대한 짧은 고찰 =======================
1. Orbix의 실행구조
Orbix은 응용 프로그램을
개발, 구동시키기
위해 3가지
개발 및 실행환경을 제공한다. 하나는
클라이언트 응용프로그램을 위한 라이브러리 ITclt이고
또 하나는 서버 응용 프로그램을 위한 라이브러리 ITsrc이다.
마지막으로는 Orbix
실행 데몬인 Orbixd가
있다. 실제
ITclt 는
ITsrc 의
서브셋이다. 서버
라이브러리는 객체조작을 위해 원격지의 요구사항을 요청하거나 전달
받을 수 있다. 그러나
클라이언트 라이브러리는 요구 사항들을 초기화하고 전달하는 기능만을
제공한다. Orbix 실행
데몬인 Orbixd 는
서버쪽에서만 필요하다. 서버쪽에
위치한 Orbixd는
클라이언트 요청에 대해 실시간에 자동적으로 서버쪽의 구현부분을
메모리상에 로드시키는 역할을 한다. 구현
객체의 구현부분을 로드시킬 때 Orbixd는
CORBA표준에서
제안한 다양한 방법으로 구현 객체의 구현부분을 구동시킬 수 있다.
다음 [그림4-5]는
실제 2개의
머쉰상에서 설치가능한 시나리오중 하나이다.
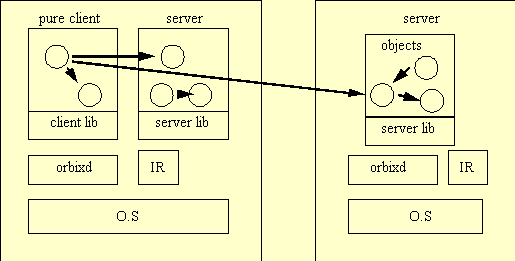
[ 그림4-5
] Orbix의 실행시간 환경의 예
2. Orbix의 시스템 구조
Orbix의 시스템은
[그림4-6]과
같은 구조로 구성되어 있다. CORBA표준안
자체가 구현쪽 보다는 기능 묘사에 중점을 두었기 때문에 실제 그
구현에 관한 부분은 개발자에게 모든 것이 맡겨져 있다고 할 수 있다.
Orbix의 시스템 구조를 간단히
살펴보면 다음과 같다.
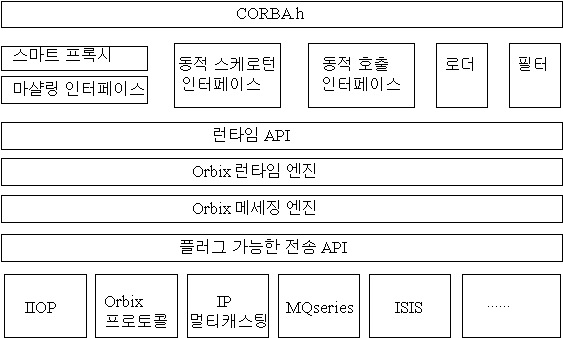
[ 그림4-6
] Orbix의 구조
Orbix는 크게 통신
부분을 담당하는 메세징 엔진 부분과 CORBA 런타임
서비스를 제공하는 런타임 엔진, 그리고
기타 부가 서비스를 제공하는 부분으로 나뉜다.
각 부분의 내용은 다음과 같다.
메세징 엔진 부분은 하부에 플러그-인
가능한 다양한 프로토콜을 기반으로 하여 Orbix의
필수적인 전송기능을 제공한다. 특히,
이 부분은 기존의 1.X
버전과 비교할 때 가장 많이 변화된
부분이다.
실제 이 부분은 4개의
추상화 클래스로 구현되어 있다.
Channel , Protocol , Corder , EventHandler
여기서 Channel
추상화 클래스는 클라이언트와
서버 구현 객체사이의 연결을 담당한다. 특히,
Orbix는 단일 채널상에 객체들간의
다중 연결을 지원하며 채널로 TCP/IP를
비롯하여 IIOP, OLTP 시스템에서
제공하는 MQSeries 채널,
폴트톨런트 기능을 제공하는 ISIS
채널 등을 선택적으로 이용할
수 있다.
Protocol 추상화
클래스는 채널상에서 사용되는 통신 프로토콜을 제공한다.
이 클래스는 기본적으로 모든
프로토콜이 request , reply, exception reply
라는 방식을 사용한다고 가정한다.
이 클래스를 구체화한 클래스로는
OMG IIOP를
구현한 IIOP 클래스와
기존의 Orbix에서
사용하던 OrbixProtocol 이
있다.
Loader 추상화 클래스는
클라이언트와 서버 객체사이의 데이타 교환시 이 들 데이타를의 마샬링
, 언마샬링
기능을 제공한다. Loader 클래스의
하위 클래스로 IIOP 프로토콜의
CDR(Common Data Representation)을
구현한 IIOP Encoder와
이전의 OrbixProtocol에서
사용하던 XDR 표현을
구현한 OrbixProtocol Encoder, 같은
데이타 표현 구조를 갖는 시스템간의 최적화 통신을 위한 Null
Encoder가 있다.
EventHandler는
클라이언트의 동기 또는 비동기 통신 방법에 대한 이벤트 처리를 담당한다.
Orbix 런타임 엔진 부분은 클라이언트와 구현 객체의 API, IDL 컴파일시 필요한 기능들을 제공한다. 기본적으로 실행시스템은 Request 클래스와 Object 클래스로 구성되어 있는데 Request 클래스는 원격지의 객체와 통신하는데 필요한 기본 정보를 갖고 있으며 Object클래스는 모든 IDL클래스들의 토대 클래스이다. Request와 Object이외에도 C 나 C++에서 void* 같은 역할을 하는 any 클래스와 실행시간에 각종 타입에 대한 정보를 결정하기위해 필요한 TypeCode등 이 있으며 프로그램을 실행 중 원격지의 객체를 로컬에서 사용할 수 있도록 해주는Proxy 객체를 생성하는 역할도 한다.
메세징 엔진 부분과 런타임 엔진 부분외에
제공되는 시스템 구성 요소들은 응용 프로그램 작성자에게 주어지는
객체 조작 기능들이다. CORBA에서
정의한 대부분의 기본 기능들을 제공한다. 그러나
CORBA 서비스에
정의된 모든 기능을 제공하는 것은 아니다.
Orbix에서 제공하는 기능을 이어서
계속 설명하도록 한다.
단계1) 프로그램의 설치
해당 인스톨 CD-ROM을
넣고 윈도우 운영체제하에서 setup.exe 프로그램을
실행하거나 유닉스상에서 다음의 명령을 실행하여 프로그램을 설치한다.
% pkgadd -d devicename
참고로 Orbix2.2.버전을 설치하면 다음과 같은 프로그램 그룹을 얻을 수 있다. 이 그룹에는 Orbix 데몬을 비롯하여 다양한 유틸리티 등이 포함되어 있다.
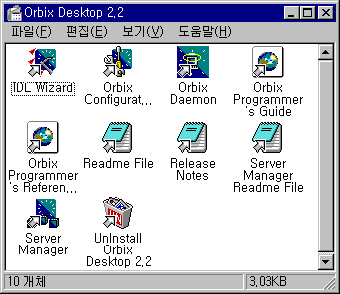
[ 그림
4-7 ] Orbix 프로그램
그룹
단계2) 환경
조절
Orbix의 환경 조절은
다음의 2개의
파일을 통해 구성된다.
ORBIX.CFG ORBVARS.BAT
ORBIX.CFG 파일은
Orbix환경
전반에 관한 정보가 담겨져 있다. 다음은
ORBIX.CFG에
선언된 환경 변수들이다. Orbixd 데몬
프로그램이 사용하게 될 통신 포트들에 대한 정보와 도메인 이름이
선언되며 에러파일의 위치, 구현
저장소와 인터페이스 저장소, Orbix의
홈디렉토리 등에 대한 정보를 담고 있다. 다음
예는 필자가 윈도우NT에서
사용하고 있는 Orbix 환경
정보이다.
// Orbix.cfg
IT_DAEMON_PORT 1570
IT_DAEMON_SERVER_BASE 1590
IT_LOCAL_DOMAIN hit.co.kr
IT_ERRORS D:\ORBIX22\errmsgs
IT_IMP_REP_PATH D:\ORBIX22\imprep
IT_INT_REP_PATH D:\ORBIX22\intrep
IT_LOCATOR_PATH D:\ORBIX22\
IT_TEMPLATE_CODE D:\ORBIX22\CORBA2\template
ORBVARS.BAT은 Orbix
응용 프로그램 작성시 필요한
환경 변수를 시스템에 설정하는 데 필요한 정보가 담겨져 있다.
다음은 필자가 사용하고 있는
ORBVARS.BAT 파일의
예이다.
SET ORBIX_ROOT=E:\ORBIX22
SET IT_CONFIG_PATH=%ORBIX_ROOT%
SET PATH=%PATH%;%ORBIX_ROOT%\BIN
SET INCLUDE=%INCLUDE%;%ORBIX_ROOT%\INCLUDE
SET LIB=%LIB%;%ORBIX_ROOT%\LIB
SET IT_IDL_TEMPLATE_CODE=%ORBIX_ROOT%%MAPPING%\TEMPLATE
이 파일에서는 Orbix의
홈디렉토리와 idl등
각종 Orbix 실행
명령어가 들어있는 위치와 라이브러리 및 인크루드 파일들에 대한
정보가 선언되어 있다. 유닉스의
경우에도 같은 파일이 존재한다. 단
확장자만이 .VAR에서
.sh 나 .csh로
바뀔 뿐이다.
참고로 윈도우 버전에서 "Orbix
configuration"이란 프로그램은
[그림4-8]
처럼 윈도우상에서 손쉽게 Orbix
설정을 관리할 수 있게 해 준다.
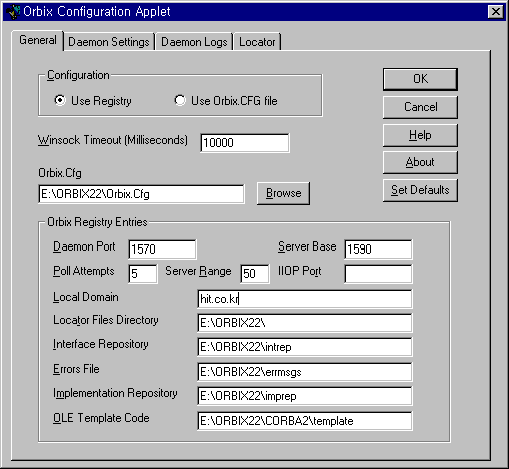
[ 그림4-8
] Orbix 설정 프로그램
4. Orbix의 기본기능
IDL은 CORBA에서
객체 아답타와 더불어 가장 중요한 기능 중 하나이다.
IDL은 구현 언어에 독립적인
인터페이스를 정의하게 해준다. 다시
말해, 구현언어
중립적인 응용 프로그램을 작성할 수 있게 해 준다.
특히 IDL은
C++에 내재된
복잡성을 제거하여 단순화시키고 여기에 새로운 기능을 추가하였다.
추가한 기능은 다음과 같다.
각 기능에 대한 자세한 설명은
앞선 절을 참조하라.
attributes , sequence , string , exception , parameter
modes , context clause
- Interface
IDL의 기본단위는
Interface이다.
다시 말해 객체의 타입이 Interface로
결정된다는 말이다. 실제
Interface는
C++의 Class와
동일하다. 따라서
Interface사이에는
상속(is-a)과
내포(is-part-of) 관계가
내재되어 있다. 다음의
예를 살펴보자.
// account.idl
interface account {
// attributes
readonly attributes string dateLastmodified;
readonly attributes float balance;
attributes string owner;
// operations
void makeDeposit( in float amount);
boolean makeWithdrawal( in float amount , out float balance );
};
interface는 attribute들과 operation으로 구성된다.
attribute는 클래스의 멤버변수로 매핑될 수 있다. 그러나 실제 interface의 attribute는 2개의 멤버함수로 변환된다.
attribute ->
set the value , get the value
그러나 만약 attribute가
readonly로
선언되면 get 함수로만
변환된다.
readonly attribute
-> get the value
실제 이 attribute들은
각기 타입을 갖고 있는데 타입에는 시스템에서 지원하는 타입과 사용자가
정의한 타입 모두를 사용할 수 있다.
Orbix 시스템에서
지원하는 타입은 다음과 같다.
short , long , unsigned short, unsigned long , float
, double , char , boolean , octet , any , string
여기서 중요한 점은 int와 unsigned char 의 경우 시스템마다 각기 그 지원범위가 다르기 때문에 기본타입으로 지원하지 않는다는 점이다. 또한 string의 경우 IDL에서 포인터가 아니기때문에 꼭 char* 와 동일한 것만은 아니다. 따라서 다음과 같이 사용할 수 있다.
string , string[10]
operation들은
C++의 멤버함수와
대부분 동일한다. 단지
다른 점은 매개변수의 전달 모드를 갖는다는 점이다.
다음은 operation에서
사용가능한 전달 모드들이다.
in 호출하는 객체에서 호출당하는 객체로 전달
out 호출당하는 객체에서 호출하는 객체로 전달
inout 양방향으로
전달 가능
실제 매개변수의 전달방향이 필요한 것은
클라이언트의 스터브와 구현 객체의 스켈로턴사이에서 값을 패킹(pack
, marshal)할 때 필요하다.
Is-a
실세계를 디자인할 때 가장 자주 발생하는
interface사이의
관계가 Is-a 이다.
실제 이 관계를 interface는
상속 개념으로 표현할 수 있다. 다음은
실제 is-a 관계의
표현이다.
interface currentAccount : account {
attribute float overDraftLimit;
};
결국 "currentAccount is a account"가 된다. 다시 말해 currentAccount는 account의 모든 attribute와 operation을 갖게 된다. 그러나 여기서 사용상의 제약이 발생한다.
먼저 currentAccount같이
account에서
유추된 interface들은
types과
constants, exceptions들을
재정의 할 수 있다. 그러나
operation과
attribute들은
재정의 할 수 없다. 다시
말해 IDL operation은
overload될
수 없다라는 말이다. 또한
Interafce는
복수 개의 interface들로부터
상속받을 수 있다.
module
interface들은 module에
의해서 일정하게 재분류된다. 이에
따라 전역변수 공간에 쓸데없는 낭비를 막아주는 역할도 한다.
다음은 앞선 예제들을 finance라는
것으로 모듈화한 것이다.
module finance {
interfcae account {
.....
};
interface currentAccount : account {
...
};
interface bank {
...
};
};
사용자는 finance::account
같은 방식으로 모듈내 interface에
접근할 수 있다.
struct
struct는 interface내에서
선언할 수 있다.
interface account {
struct personInfo{
string name;
short age;
};
personInfo getPersonInfo();
};
다음은 앞서 설명한 기능들 외에 사용가능한
기능들이다.
enum , union , typedef , sequence , 1D 또는
2D arrays , exception , context
DII는 실행시간에
원하는 구현 객체의 메소드를 호출할 수 있게 해준다.
따라서 사용자는 실행도중 객체의
상태가 변한다거나 새로운 값들을 갱신할 경우 이 기능을 이용할 수
있다. 대표적인
사용 상황으로는 객체들의 부라우징이나 실시간 관리 등을 들 수 있다.
결국 DII기능을
이용하기 위해서 Orbix은
시스템 차원에서 실행시간에 객체에 대한 정보를 제공해야 한다.
객체의 타입,
매개변수,
반환 값 등 다양한 타입과 스키마
정보가 필요하다. 이러한
정보를 제공하기 위해 생성한 데이타베이스가 인터페이스 저장소(Interface
Repository , IR)이다.
실제 IR에는
메타데이타가 저장되는 데 여기서 메타데이타란 Orbix
시스템이 실행시간에 객체를 조작하는
데 필요한 모든 정보를 의미한다.
Orbix의 DII를
이용하는 것은 다소 번거롭지만 그다지 어렵지는 않다.
실제 Orbix은
request라는
DII객체를
생성하고 이를 통해 원하는 메소드를 호출함으로서 모든 것이 끝난다.
다음은 Orbix에서
DII를 사용하는
예이다.
- request 객체 생성
- 매개변수 등록
- 원하는 메소드를 등록
- Invoke 메소드
구동
// gridclient
CORBA::Object_ptr gridptr;
CORBA::Request r(gridptr , "get"); // gridptr객체에 대한request 객체를 생성하고
// 호출할 메소드를 등록한다.
r << 2 << 4 ; // get() 메소드에
매개변수 등록
r.invoke(IT_X); // Invoke메소드
구동
long result;
r >> result;
....
DII는 원하는 객체의
메소드만 구동시키는 것이 아니라 애트리뷰트들도 조작할 수 있다.
실제 애트리뷰트에 각종 값을
입력하거나 반환받 을 수 있으며 구조체 , sequence
, union등의 입력도 가능하다.
결론적으로 DII는
Orbix에서
자동적으로 제공해주는 코드인 정적 호출보다는 사용하기 어렵지만
앞서 언급한대로 동적인 객체조작을 요하는 분야에서는 반드시 필요하다.
IR은 시스템에서
정의한 각종 타입과 인터페이스 정의에 관한 정보를 유지한다.
따라서 IR은
DII와 함께
사용되며 각종 시스템 관리나 동적인 타입 검사등에 이용된다.
실제 Orbix의
IR구조는
상위의 container와
contained를
중심으로 하여 각 타입항목마다 IDL인터페이스로
정의되어 있다.
Container
Repository
ModuleDef 실제 각 항목들이 순환적으로
InterfaceDef 구성된다.
Contained
ModuleDef
InterfaceDef
ConstantDef
TypeDef
ExceptionDef
AttributeDef
OperationDef
ParameterDef
[그림4-9]
Orbix의 IR
구성
사용자는 프로그램내에서 작성된 IR의
정보를 발견하고 확인하는 등 각종 조작을 할 수 있다.
클라이언트의 요청에 따라 Orbixd
실행 데몬은 해당 구현 객체를
구동시켜야 한다. 이때
필요한 정보가 해당 구현 객체의 위치 및 통신방법,
구동 옵션 등이 필요하다.
이 정보가 저장된 곳이 구현 저장소이다.
실제 이곳에 정보를 저장하려면
putit이란
명령어를 사용한다. 다음은
실제 Orbix에서
grid라는
구현 객체를 구현 저장소에 저장하는 명령이다.
putit gridserver d:\orbix22\demo\grid\server.exe
실제 이 명령을 실행한 후,
구현 저장소에는 grid.imp란
파일이 생성되는데 그 내용은 다음과 같다.
Name : gridserver
Comms : xdr/tcp
Activation : shared
Owner : Administrator
Launch : ;
Invoke : ;
Marker Launch Command
* D:\ORBIX22\DEMO\GRID\SERVER.EXE
여기서 중요한 기능중의 하나가 구현
객체의 구동모드에 대한 정보인 Activation 모드이다.
이 예에서는 shared로
사용되었는데 Orbix에서
제공하는 모드는 다음의 4개가
있다.
- shared
각 호스트에 한 서버 프로세스만이 존재한다. 모든 클라이언트는 한 개의
구현 객체와 통신한다.
- unshared
구현 저장소에 등록된 개별적인 구현 객체들에 대해 프로세스들이 구동된다.
- per-method call
구현 저장소에는 개별적인 메소드들이 등록될 수 있다. 이 개별적인 메소드들에
대해 프로세스가 생성된다.
- persistent
사용자가 직접(manually) shared모드로 구동할 수 있는 서버를 persistent 서버라고
말한다.
ANY 데이타
형은 한마디로 void* 같은
기능을 한다. 다시
말해 어떤 형이든 상관없이 사용할 수 있는 데이타 형을 의미한다.
이 타입은 ODMG에서
결정된 표준 데이타 형 중 하나이다. 따라서
ANY타입의
매개변수는 다른 모든 기본 데이타 형이나 구조체 ,
객체참조로 사용될 수 있다.
다음은 Orbix에서
제공하는 ANY 데이타
형의 구조이다.
struct any {
typeCode *_type; // 실제 타입을 의미한다.
void *_value; // 실제 값에 대한 포인터를 의미한다.
any();
any(const &any);
any(const char *type, const void *val);
~any();
any& operator=(const any&);
...
void operator<<(unsigned char o);
...
void insertObjectRef(const TypeCode tc, const ObjectRef
, Environment&);
...
}
사용자는
다음과 같이 ANY 자료형을
자유롭게 사용할 수 있다.
any a1;
char * name = new char[strlen("hyundai")+1];
al << name;
5. Orbix의 부가기능
필터는 특정 객체호출이 발생하였을 때
응용프로그램에서 객체에 대한 조작권한을 얻을 수 있게 해주는 기능을
말한다. 다시
말해 특정 주소 공간내에서 객체호출이 발생하거나,
도착 또는 호출에 대한 반응이
보내지거나 받았을 때 이 객체를 조작하는 권한을 Orbix에게서
넘겨받는 것을 말한다. 실제로
객체를 모니터링하거나 디버깅, 추가적인
보안 장치 등이 필요한 경우 유용하게 사용된다.
실제 이러한 필터는 프로세스
단위 또는 객체 단위로 적용할 수 있다.
다음은 Orbix에서
객체나 프로세스에 필터를 사용할 수 있는 위치를 나타낸 것이다.
event request event
event reply
event
A. 프로세스
단위의 필터위치
marshal request unmarshal
unmarshal reply marshal
B. 객체단위의
필터위치
[그림4-10]
Orbix의 필터사용위치
Orbix에서 실제
필터는 CORBA::Filter라는
클래스에 의해서 구현된다. 다음은
실제 이 클래스의 선언 내용이다.
class Filter {
protected :
Filter();
virtual Filter();
public:
virtual unsigned char outRequestPreMarshal(...);
virtual unsigned char outRequestPostMarshal(...);
virtual int inRequestPreMarshal(...);
virtual unsigned char inRequestPostMarshal(...);
virtual unsigned char outReplytPreMarshal(...);
virtual unsigned char outReplyPostMarshal(...);
virtual unsigned char inReplyPreMarshal(...);
virtual unsigned char inReplyPosMarshal(...);
};
실제 이 추상화된 필터 클래스를 상속받고
원하는 프로세스 필터를 작성한 후 호출함으로서 모든 필터기능을
이용할 수 있다. 이때
클라이언트와 구현 객체쪽 모두 필터가 필요한 것은 아니다.
Orbix에서는 2개의 특별한 프로세스 필터를 제공한다.
Authentication
필터 ,
Thread 필터
Authentication필터는
프로세스사이에 권한과 관련된 정보를 전달하며 Thread필터는
객체요청시 새로운 thread를
생성해주는 역할을 한다.
이밖에 객체단위의 필터를 사용하려면 TIE방식을 통해야만 한다. 따라서 컴파일시 IDL -F옵션을 사용한 후 필터를 사용하고자 하는 객체에 작성한 필터를 붙이면 된다.
Orbix는 사용자가
객체의 상태정보를 캐슁(caching)할
수 있도록 프록시 팩토리(Proxy Factory) 클래스를
제공한다. 프록시
팩토리는 일반 프록시와 스마트 프록시를 구성할 수 있다.
여기서 일반 프록시는 Orbix에서
제공하는 라이브러리를 통해 자동으로 생성된다.
실제 뒤에서 우리는 IDL컴파일
후 gridProxyFactoryClass란
프록시 팩토리 클래스가 생성되는 것을 보게 될 것이다.
실제 grid객체의
프록시를 생성할 때마다 이 클래스를 사용하게 된다.
이 일반 프록시는 in
, out 매개변수를 마쉘링(marshal)하거나
언마쉘링(unmarshal)하고
각종 객체요청을 전달하는 역할을 한다. 이에
반해 스마트 프록시는 객체의 실제 값이나 상태정보를 캐슁하거나
클라이언트의 로컬 머쉰에 있는 리소스를 이용할 경우 사용할 수 있다.
그러나 이러한 스마트 프록시를 사용할 때 유의해야 할 사항이 있다. 다름아니라 실제 객체에 대해 복수 개의 프록시가 존재하기 때문에 오직 한 순간에 한 클라이언트 프록시에 의해서만 변경될 수 있다는 점이다.
Orbix는 클라이언트의
요청이 도착하는 순간, 호출하기
위한 구현 객체를 찾는다. 이때
해당 구현 객체를 발견하지 못한다면 INV_OBJREF라는
예외상황을 클라이언트에게 발생시킨다. 이런
상황에서 Orbix는
클라이언트에게 객체 폴트(Object fault)상황을
알릴 수 있는 객체를 작성할 수 있는 기능을 제공한다.
이 객체가 Loader클래스이다.
기본적으로 Orbix의
모든 객체는 기본Loader를
갖고 있다.
Loader클래스는
복수 개를 작성할 수 있다. 이
클래스를 이용하면 파일시스템이나 데이타베이스 시스템같은 지속성
저장도구로부터 Orbix객체를
저장하고 추출할 수 있다. 동시에
이종의 지속성 저장구조를 이용함으로서 다중 저장구조로 시스템 구성을
가능하게 한다. 현재
Orbix은
Loader클래스를
확장하여 객체지향 DBMS와
연동함으로서 객체의 지속성을 구현하였다.
사용자가 정의한 Loader클래스는
모두 최상위의 CORBA::LoaderClass를
상속해야 한다. 최상위의
CORBA::LoaderClass는
다음의 멤버함수를 제공한다.
virtual ObjectRef load ( const char* interface, const char* marker,
unsigned char isBind, CORBA::Environment&);
virtual void save(Object* ,saveReason reason, CORBA::Environment& );
virtual void record(Object* ,char* marker, CORBA::Environment& );
virtual unsigned char rename(Object* ,char* marker, CORBA::Environment& );
위의 멤버함수의 인자중 marker는
실제 파일이름이나 데이타베이스 이름 등으로 매핑될 수 있다.
따라서 자신이 저장하고자 하는
지속성 매체에 대해 이 함수를 오버로딩 함으로서 원하는 Loader클래스를
작성할 수 있다. 일단
자신의 Loader클래스를
작성한 후 이 클래스를 저장하길 원하는 클래스에 등록시킴으로서
사용할 수 있다.
Orbix는 분산된
시스템상에서 _bind()에
의해서 요청된 객체를 locator에
의해서 찾는다. 기본
locator로는
Orbix.hosts와
Orbix.hostgroups 파일이
있다.
Orbix.hosts파일에는
다음과 같은 구조로 정보가 저장된다.
<server_name>:<list_hosts>:<list_host_groups>
먼저 <server_name>은
서버 프로그램의 이름을 의미하고 <list_hosts>에는
서버 프로그램이 수행되는 컴퓨터들의 이름을 명시한다.
마지막으로 <list_host_groups>에는
Orbix.hostgroups에
명시된 그룹명이 명시된다. 다음
그 실제 예이다.
bank:host1,host2,host3:financial
Orbix.hostgroups파일에는
다음과 같은 구조로 정보가 저장된다.
<group_name>:<list_hosts>
<group_name>은
원하는 호스트들의 그룹이름이 명시되며 <list_hosts>에는
해당 그룹에 속하는 호스트 이름이 명시된다.
다음은 그 사용 예이다.
financial:host1,host2
사용자는 기본locator를
변경할 수 있다. 사용자는
Orbix에서
제공하는 CORBA::locatorClass를
상속받아 자신의 locator클래스를
작성할 수 있다. CORBA::locatorClass는
다음의 멤버함수를 갖는다.
virtual _IDL_SEQUENCE_string lookup ( const char *ServiceName ,
insigned long MaxHops,
const Context& context ,
Environment& env) ;
lookup메소드는
서버이름을 인자로 받고 이 서버가 존재하는 호스트들의 이름을 sequence구조로
반환한다. maxHops은
Orbix에
의해서 자동적으로 결정되기도 하지만 사용자가 직접 지정할 수 있다.
Orbix가 운영되기
위해서 필요한 가장 기본적인 조정파일은 Orbix.cfg
이다. 이
파일은 유닉스에서 /etc에
위치하거나 IT_CONFIG_PATH라는
환경변수에 의해서 설정된다. 다음은
이 파일에 존재하는 조정 변수들이다.
- IT_DAEMON_PORT
Orbix 데몬이 사용하는 포트가 명시된다. 기본값은 1221 이다.
- IT_DAEMON_SERVER_BASE
각 서버와 통신하기 위한 포트가 명시된다. 기본은 1241이다.
-IT_LOCAL_DOMAIN
Orbix이 구동되는 도메인 환경정보가 명시된다.
- IT_ERRORS
에러 로그파일의 위치와 이름이 명시된다.
- IT_IMP_REP_PATH
구현 저장소의 위치와 이름이 명시된다.
- IT_INT_REP_PATH
인터페이스 저장소의 위치와 이름이 명시된다.
- IT_LOCATOR_PATH
Orbix의 설치
디렉토리가 명시된다.
앞선 환경 변수이외에도 Locator의
위치를 지정하기 위한 IT_LOCATOR_PATH와
호스트 접속시 접속시도 회수를 지정하는 IT_CONNECT_ATTEMPTS,
IIOP포트를 지정하는 IT_IIOP_PORT가
있다.
- serverhosts
serverhosts servername [ -h hostname ] [ -v ] [ -r hostlist ] [ -a hostlist ] [ -l ]
이 명령어는 Orbix.hosts파일에 접근하여 명시된 서버가 위치하는 호스트의 이름을 알려준다. 또한 -r옵션과 함께 사용하면 명시된 리스트를 제거할 수 있으며 -a옵션은 해당 리스트에 명시된 호스트를 명시된 서버에 추가한다. 마지막으로 -l은 명시된 서버에 대한 모든 호스트를 알려준다.
- servergroups
servergroups servername [ -h hostname ] [ -v ] [ -r hostlist ] [ -a hostlist ] [ -l ]
이 명령어는 Orbix.hosts파일에 접근하여 호스트 그룹에 대한 정보를 알려주거나 삭제( -r ) 또는 추가(-a)할 수 있다.
- grouphosts
grouphosts servername [ -h hostname ] [ -v ] [ -r hostlist ] [ -a hostlist ] [ -l ]
이 명령어는 Orbix.hostgroups파일에
접근하여 명시된 그룹에 속한 호스트 정보를 제공하거나 삭제(-r),
추가(-a)할
수 있다.
- catit
catit [ -v ] [ -h hostname ] server_name
주어진 서버에 대한 정보를 해당 IR에서 추출하여 보여 준다.
- lsit
lsit [-R] [ -v ] [ -h hostname ] server_name or dir_name
IR에서 해당 서버를
조회하거나 인자없이 사용할 경우 모든 구현 객체의 이름을 보여준다.
- rmit
rmit [ -v ] [ -h hostname ] [ -marker marker | -method method ] server_name
IR에서 해당 서버를
삭제한다.
- mkdirit
mkdirit [-v] [-h hostname] dir_name
서버 구현 객체의 이름은 계층적으로
구성할 수 있다. 가령,
bank서버 아래에 pohang
, seoul등의 계층적 서버를 만들
수 있다. 이때
mkdirit을
사용한다.
- rmdirit
rmdirit [-v] [-h hostname] dir_name
mkdirit등에 의해
작성된 디렉토리를 삭제한다.
- putit
putit [-v] [-h <host>] [-per-client | -per-client-process]
[ -shared [ -persistent ] | -unshared ]
[ -marker <marker>] |
[ -per-method ] [ -method <method> ]
<serverName> <commandLine>
이 명령어는 앞서 사용한 것처럼 IR에
구현된 서버 구현 객체의 위치정보와 이름을 명시할 수 있데 해 준다.
- psit
psit [ -v ] [ -h hostname ]
이 명령어는 Orbixd에
알려진 서버 구현 객체의 목록을 알려 준다.
- killit
killit [ -v ] [ -h hostname ] [-m marker] server_name
서버 구현 객체를 삭제해 준다.
- pingit
pingit [ -v ] [ -h hostname ]
Orbixd 데몬의 생사
여부를 확인해 준다.
- chmodit
chmodit [ -v ] [ -h hostname ] server_name
[ i{+,-}{user_name,group_name} | l{+,-}{user_name,group_name} ]
IR의 소유권한을
변경할 때 사용한다.
- chownit
chownit [ -v ][-R] [ -h hostname ] server_or_dir_name new_owner
IR에 대한 접근권한을
조정할 때 사용한다.
- 각 옵션설명
-v 프로그램의 버전정보를 알려 준다.
-R 모든 디렉토리나 IR에 대해 반복적으로 명령어를 적용한다.
-h 적용하고자
하는 호스트 이름이나 IR을
명시한다.
=========================================================================
위의 내용을 충분히 이해했으리라 믿고
이제는 본격적으로 CORBA 응용
프로그램을 작성해보자. CORBA 응용
프로그램을 작성하는 데에는 기본적으로 다음의 3
단계를 거친다.
단계1) IDL 파일 작성 및 컴파일
단계2) 클라이언트와 서버 구현 코드 작성
단계3) 단계1의 산출물과 단계2의 산출물을 통합하여 클라이언트와 서버 바이너리 코드
생성
이들 각 단계는 다음의 7단계로 세별할 수 있다.
단계1) IDL작성
단계2 ) IDL 컴파일
단계3) 서버 구현 객체 구현
단계4) 클라이언트와 서버 메인 부분 작성
단계5) 서버 구현 객체와 클라이언트 실행파일 작성
단계6) 구현 객체의 구현 저장소에 실행 정보 저장
단계7) 클라이언트
프로그램 실행
다음 [그림4-11]은 CORBA에서 응용 프로그램의 개발과정을 도식화한 것이다. 먼저 제1단계로 해당 클래스를 IDL 문법에 맞게 작성한다. 일단 작성된 IDL파일은 IDL컴파일러에 의해서 클라이언트용 스터브 코드와 구현 객체의 스켈로턴을 생성해 낸다. 일단 CORBA 에 의해서 자동적으로 생성된 코드는 네트웍 부분을 위한 코드만 제공되기 때문에 필요한 로직을 구현해야 한다. 따라서 제2단계로 클라이언트와 서버 프로그램의 로직을 구현한다. 그리고 마지막으로 제3단계에서 이 모든 것을 컴파일하고 링크한 후 원하는 바이너리를 생성한다.
이 과정을 정확히 이해하는 것이 CORBA프로그램의
첫걸음이자 가장 중요한 부분이다.
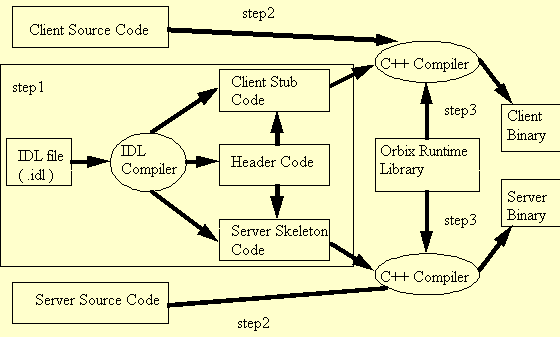
[ 그림4-11]
CORBA 응용프로그램 개발절차
다음은 각 단계별로 grid 프로그램을 작성하는 예이다.
단계1) IDL작성
및 컴파일
[그림4-11]에서
처럼 먼저 CORBA 프로그래머는
개발하고자 하는 응용시스템을 디자인 한 후 CORBA에서
제공하는 IDL(Interface Definition Language)을
이용하여 해당 클래스의 명세를 작성한다. 따라서
CORBA 프로그래머는
IDL 명세를
이해해야 한다.
interface grid
{
readonly attribute short height;
readonly attribute short width;
void set(in short n, in short m, in long value);
long get(in short n , in short m);
}
[ 예제4-2
] grid클래스의 IDL구현
(grid.idl)
일단 작성된 IDL파일(
grid.idl )은 IDL컴파일러에
의해서 컴파일된다. IDL컴파일러는
클라이언트용 스터브 프로그램과 서버용 스켈로턴 프로그램,
그리고 이 두 프로그램에 공통적으로
사용하는 헤더파일을 생성해 낸다. 이
과정을 통해 사용자는 분산 프로그램시 필요한 네트웍 코드를 IDL을
통해 자동적으로 얻을 수 있다. 예를
들어 , 실제
idl로 작성된
grid.idl 파일은
idl 컴파일러를
통해 C++ 형태로
변환된다. 이때
interface는
class로
attribute는
멤버 데이타로 변환된다. 다시
말해 해당 idl 파일은
C++로의
변환규칙에 따라 C++파일로
변환된다.
단계 2) grid.idl의
컴파일
일단 원하는 클래스를 idl을
통해 작성한 후 사용자는 해당 idl파일을
C++형태의
소스코드로 변환하기 위한 작업을 진행해야 한다.
Orbix에서는 이를 위해 idl
컴파일러를 지원한다.
다음은 실제 grid.idl을
컴파일하는 상황이다.
% idl -B grid.idl
실제 idl컴파일러는
다음의 헤더 파일과 소스 코드들을 생성해 낸다.
여기서 -B옵션은
BOA(Basic Object Adapter)의
이용을 의미한다. 따라서
BOA를 이용하는
데 필요한 기능만을 생성해 낸다.
grid.hh , grids.cpp , gridc.cpp
이 파일에는 grid클래스를
네트웍상의 서로 다른 곳이나 서로 다른 메모리 공간내에 위치시키는
각종 통신 기능들이 포함되어 있다. 실제
이 파일들은 사용자들이 변경할 필요없이 최종 프로그램 컴파일시
이용된다. 각
파일의 주요 내용은 다음과 같다.
// grid.hh
grid.hh 파일에는
Orbix의
최상위 루트 클래스인 CORBA.h를
인클루드한다. CORBA.h에는
Orbix을
운용하는 데 필요한 각종 flag와
exception 클래스
등 각종 시스템 클래스가 정의되어 있다.
또한 grid.hh에는
크게 다음의 5가지
클래스 선언을 갖고 있다.
해당 객체를 디스패치하는데 필요한 메소드가
선언되어 있다.
grid.idl로 작성된
grid 인터페이스는
idl 컴파일러를
통해 다음과 같이 변환된다. interface란
키워드는 class로
각각의 attribute는
메소드로 변환된다. 이러한
과정은 idl을
C++로 변환시키는
규칙에 의존한다. 다음은
grid인터페이스가
C++ 클래스로
변환된 결과이다.
class grid : public virtual CORBA_Object {
public :
static grid* _bind(...); //overloaded
virtual short height(CORBA:Environment &IT_ENV =
CORBA:default_environment);
virtual short weight(.....);
virtual short set(.....);
virtual short get(.....);
};
[ 예제4-3
] C++로 변환된 grid.idl
Orbix는 객체에
접근할 때 프록시 객체를 생성하고 이 객체를 통해 해당 객체에 접근한다.
이를 위해 모든 객체는 프록시
객체를 생성하고 조작하기 위해 상위 프록시 클래스를 상속받는다.
Orbix에서 분산객체를
처리하는 모델은 BOA를
이용한 방법과 TIE라는
방법이 있다. BOA는
추가적인 기능없이 Orbix에서
제공하는 일반적인 분산기능을 이용하는 것을 의미한다.
이 경우 CORBA_object라는
클래스를 상속받는다.
grid client process
server process
grid object proxy target object
[ 그림4-12
] BOA를 이용한 일반적인 객체접근
이 방법 외에 TIE를
이용한 객체접근은 BOA에서
제공하는 기능을 상속받지 않는다. TIE방법은
일단 grid 객체를
작성한 후 TIE 객체에
등록시킴으로서 가능하다. 이를
위해 grid.hh에는
다음의 클래스를 정의한다.
TIE를 통한 객체접근은
원하는 객체에 접근할 때 TIE객체라는
중간객체를 일단생성하고 이를 통해 원하는 객체에 접근하는 것을
의미한다. 다음은
TIE객체의
생성과 접근 예이다.
grid_i *q = new grid_i(...)
grid *p = new TIE_account(account_i)(q);
q
p
TIE 객체
실제 객체
[ 그림4-13
] TIE객체를 이용한 일반적인
객체접근
// gridC.cpp
gridC.cpp에는 grid.hh에
정의한 클래스의 멤버 함수들이 구현되어 있다.
다시 말해 클라이언트가 구현
객체의 구현부분에 요구사항을 전달하기 위한 함수들이 구현되어 있다.
// gridS.cpp
이 파일에는 grid의
서버 구현 객체에서 필요한 메소드인 grid_dispatch::dispatch()가
선언되어 있다.
#include "gridC.cpp"
grid_dispatch:dispatch();
단계3) 서버 구현 객체 구현
앞서도 설명했지만 분산객체에서 클라이언트는
서버 구현 객체에 정의된 클래스의 메소드를 원격지에서 호출하고
이 결과를 전달받는 과정을 통해 작업한다. 즉,
클라이언트에서는 정의된 메소드만을
호출하고 구현 객체에서는 이 메소드를 구현해야만 한다.
따라서 앞서 grid.idl에서
정의한 grid클래스를
서버 구현 객체쪽에 구현해야 한다.
따라서 먼저 사용자는 다음의 사항을
미리 결정해야 만 한다: 먼저
사용자가 직접 원하는 클래스를 작성할 것인지 아니면 Orbix의
idl이 제공하는
간단한 프로토타입 파일을 이용할 것인지 결정해야만 한다.
가령, 전혀
Orbix의
도움이 없이 구현 객체를 구현하려면 앞서 만들어 둔 gridBOAImpl
클래스를 상속받거나 TIE방식에
따라 직접 코드를 작성해야 한다. 그러나
Orbix의
idl을 이용하면
간단하고 일관적으로 구현 객체를 작성할 수 있다.
다음은 Orbix의
idl을 이용하여
구현 객체의 코드를 작성하는 예이다.
e:\Orbix22\bin\idl -S grid.idl
여기서 -S 옵션은
서버쪽의 구현부분에 대한 원형을 제공한다.
다시 말해 사용자가 서버쪽에서
구현해야 할 부분을 명시해 주는 것이다. 앞선
명령어를 수행하면 다음의 파일들을 생성해낸다.
grid.hh , grids.cpp , gridc.cpp , grid.ih
, grid.ic
앞서 3개의 파일(grid.hh , grids.cpp , gridc.cpp )은 앞서 -B 옵션시 생성된 것과 동일하다. 그러나 -C에서는 grid.ih와 grid.ic이란 파일을 추가적으로 생성해 준다.
실제 grid.ih
와 grid.ic
파일의 내용은 다음과 같다.
// grid.ih
#ifndef grid_ih
#define grid_ih
#include "grid.hh"
class grid== {
public:
virtual short height (CORBA_Environment &IT_env=CORBA_default_environment);
virtual short width (CORBA_Environment &IT_env=CORBA_default_environment);
virtual void set (short n, short m, long value, CORBA_Environment
&IT_env=CORBA_default_environment);
virtual long get (short n, short m, CORBA_Environment &IT_env=CORBA_default_environment);
};
#endif
// grid.ic
#include "grid.ih"
short grid==:: height (CORBA_Environment &IT_env) {}
short grid==:: width (CORBA_Environment &IT_env) {}
void grid==:: set (short n, short m, long value, CORBA_Environment &IT_env) {}
long grid==:: get (short n, short m, CORBA_Environment
&IT_env) {}
실제 아무런 코드 내용없이 grid에
대한 클래스 선언과 메소드 선언만이 묘사되어 있다.
사용자는 단지 이 파일에 자신의
로직만을 추가함으로서 모든 응용 프로그램 완성할 수 있다.
실제 아이오나사에 따르면 다음의
프로그램 규칙에 의해서 응용프로그램을 작성하길 권장하고 있다.
idl에 의해서 작성된 모든 파일을
다음과 같이 변경한 후 사용하라는 것이다.
grid.ih ->
grid_i.h , grid.ic -> grid_i.cc
번거롭지만 일단 이 규칙을 따르면 적어도
어느 파일이 구현 객체쪽의 파일인지 구분하기 쉽다.
grid.idl
idl
-s
grid.ih grid.hh grids.cpp gridc.cpp
grid.ic
[ 그림
4-14 ] idl -S 에
의해서 생성된 파일들
따라서 앞서 파일에 각기 원하는 로직을
추가한다. 예를
들면, 본
예제에서 로직을 추가한 grid_i.h , grid_i.cc
파일은 다음과 같다.
// 새로 작성된 grid_i.h
// 서버 grid클래스는
BOA기능을
이용하였음
#include "grid.hh"
class grid_i : public gridBOAImpl {
short m_height; // store the height
short m_width; // store the width
long **m_a; // a 2-D array to store the grid data itself
public:
grid_i(short h, short w);
virtual ~grid_i();
virtual short width(CORBA_(Environment) &env);
virtual short height(CORBA_(Environment) &env);
virtual void set(short n, short m, long value,
CORBA_(Environment) &env);
virtual long get(short n, short m,
CORBA_(Environment) &env);
};
// 새로 작성된 grid_i.cc
#include "grid_i.h"
grid_i::grid_i(short h, short w) {
m_height=h; // set up height
m_width=w; // set up width
m_a = new long* [h];
for (int i = 0; i < h; i++ )
m_a[i] = new long[w];
}
grid_i::~grid_i() {
// free the individual 1-D arrays:
for (int i = 0; i < m_height; i++)
delete[] m_a[i];
// then free the overall array:
delete[] m_a;
}
short grid_i::height(CORBA(Environment) &) {
return m_height;
}
short grid_i::width(CORBA(Environment) &) {
return m_width;
}
void grid_i::set(short n, short m, long value, CORBA(Environment) &) {
m_a[n][m] = value;
}
long grid_i::get(short n, short m, CORBA(Environment) &) {
return m_a[n][m];
}
단계4) 클라이언드와 구현 객체의 메인 프로그램 작성
클라이언트 부분과 구현 객체 부분에
필요한 모든 클래스의 작성이 끝난 후 마지막으로 해야 할 일은 각
부분에 필요한 메인 프로그램을 작성하는 것이다.
즉, 2개의
메인 프로그램을 작성하는 것이 된다. 이
때 작성요령은 다음과 같다.
1) 해당 클래스 선언(grid *p;)
2) 구현 객체의 구현부분과 해당 클래스를 바인딩( p = grid::_bind(); )
3) 해당 클래스의
메소드 호출( p->height(); )
다음은 실제 구현 객체쪽의 grid_i클래스를
이용하는 클라이언트 프로그램이다.
// grid 클라이언트 프로그램
#include "grid.hh"
#include <iostream.h>
#include <stdlib.h>
main (int argc, char **argv) {
grid* p; // pointer the grid object that will be used.
short h, w;
long v , v1;
if (argc < 2) {
cout << "usage: " << argv[0] << " <hostname>" << endl;
exit (-1);
}
TRY {
// First bind to the grid object.
// argv[1] has the hostname (if any) of the target grid object;
// The default is the local host:
p = grid::_bind("", argv[1], IT_X);
} CATCHANY {
// an error occurred while trying to bind to the grid object.
cerr << "Bind to object failed" << endl;
cerr << "Unexpected exception " << IT_X << endl;
exit(1);
} ENDTRY
TRY {
// try to read the height and width of the grid:
h = p->height(IT_X);
w = p->width(IT_X);
} CATCHANY {
// an error occurred while trying to read the height and width:
cerr << "call to height or width failed" << endl;
cerr << "Unexpected exception " << IT_X << endl;
exit(1);
} ENDTRY
// no problem reading the height and width:
cout << "height is " << h << endl;
cout << "width is " << w
<< endl;
TRY {
// try to set element [2,4] of the grid - to value 123
p->set(2, 4, 123, IT_X);
p->set(2, 5, 1235, IT_X);
// then read back what we have just set:
v = p->get(2, 4, IT_X);
v1 = p->get(2, 5, IT_X);
} CATCHANY {
// an error occurred while calling set or get:
cerr << "Call to set or get failed" << endl;
cerr << "Unexpected exception " << IT_X << endl;
exit(1);
} ENDTRY
// no problem setting and getting the elememt:
cout << "grid[2,4] is " << v << endl;
cout << "grid[2,5] is " <<
v1 << endl;
// sanity check: make sure we got the value 123 back:
if ( v != 123 ) {
// oops - we didn't:
cerr << "something went seriously wrong" << endl;
exit(1);
}
delete p;
}
구현 객체의 메인 프로그램은 서버쪽
클래스인 grid_i 를
선언하고 이를 클라이언트에서 사용가능하도록 해주면 된다.
다음은 실제 grid클래스의
서버 프로그램이다.
// gridServer.C
#include <iostream.h>
#include "grid_i.h"
int main() {
// create a grid object - using the implementation class grid_i
grid_i myGrid(100,100);
TRY {
// tell Orbix that we have completed the server's initialisation:
CORBA(Orbix).impl_is_ready("grid",IT_X);
}
CATCHANY {
// an error occured calling impl_is_ready() - output the error.
cout << IT_X;
}
ENDTRY
// impl_is_ready() returns only when Orbix times-out an idle server
// (or an error occurs).
cout << "server exiting" << endl;
return 0;
}
단계5) 클라이언트와 서버 바이너리 완성
일단 모든 프로그램의 작성이 끝났으면
스터브와 스켈로턴 코드 그리고 작성한 프로그램들을 통합 하여 컴파일을
한 후 바이너리를 생성한다: client.exe , server.exe
단계6) 구현 객체의 구현 저장소에 실행정보 저장
Orbix는 실제 수행시
실행 데몬(orbixd)의
의해서 원하는 서버쪽의 구현부분을 구동시킨다.
따라서 구현 객체의 실행 데몬인
Orbixd가
해당 구현부분을 구현 저장소에서 찾을 수 있도록 해주어야 한다.
이 과정은 Orbix의
putit이라는
명령어를 통해서 이루어진다.
putit gridserver d:\orbix22\demo\grid\server.exe
이 예는 gridserver라는
서버 이름의 구현부분이 해당 위치( d:\orbix22\demo\grid\server.exe
)에 있다는 정보를 구현 저장소에
저장된다. 실제
저장되는 내용은 다음과 같다.
//grid.imp
Name : gridserver
Comms : xdr/tcp
Activation : shared
Owner : Administrator
Launch : ;
Invoke : ;
Marker Launch Command
* D:\ORBIX22\DEMO\GRID\SERVER.EXE
실제 구현 객체의 이름과 통신 방법,
구현 객체의 구동 모드(shared),
소유자,
실제 위치 등의 정보가 포함된다.
단계7) 클라이언트 바이너리 실행
실제 구현 저장소에 모든 등록이 끝나고
Orbixd 실행
데몬을 수행시켰다면 모든 준비가 끝난 셈이다.
최종적으로 서버와 클라이언트
프로그램만 수행시키면 원격지의 서버를 이용하여 원하는 작업을 수행할
수 있다.
[ 그림4-15
] 작동중인 Orbixd
데몬 프로그램
참고로, 해당
프로그램을 수행할 때 미리 TCP/IP 연결이
수행되고 있어야 한다. 따라서
네트웍 환경이 구축되어 있지 않다면 해당 프로그램들을 실행할 수
없다.
2.2 PowerBroker를
이용한 CORBA 프로그래밍
앞서 Orbix를
이용하여 grid라는
간단한 프로그램을 작성하면서 이를 분석해 보았다.
이제 CORBA의
작동 메커니즘을 완벽히 이해했을 것이다. 이번에는
엑스퍼소프트의 PowerBroker라는
제품을 이용하여 좀 더 복잡한 프로그램을 작성해보자.
2.2.1 프로그램
진행 순서
2.2.2 프로그래밍
환경
2.2.3 시나리오
이 프로그램은 DB(예제에서는
단순 텍스트 파일을 사용)에
저장되어 있는 회사의 주식 시세를 알아보는 프로그램으로 한 회사의
주식 시세를 알아보는 방법과 여러 회사들을 그룹화 하여 해당 그룹에
속해 있는 회사들의 주식 시세를 알아보는 내용으로 작성되어 있다.
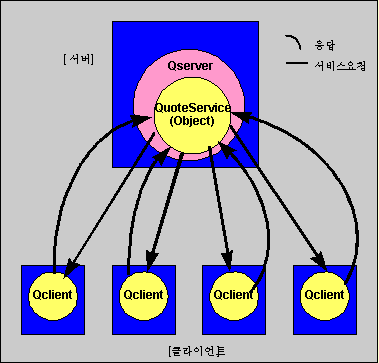
구현 객체는 서비스가 하나인
구현 객체를 관리하며, 다수의
클라이언트에서 동시에 하나의 구현 객체로부터 서비스를 받는 프로그램이다.
[그림 4-16
] 참조
2.2.4 IDL 작성
getQuote() - 회사명(symbol)을 받아 그 회사의 주식값(quote)을 리턴
createGroup()-세개의 회사명(sym1,sym2,sym3)으로 구성된 그룹명 (groupName)을 생성하고 성공하면 TRUE 반환
getGroupQuote() - 그룹명 groupName을 받아 가장 최근의 주식시세를 반환하면 TRUE, 실패하면 FALSE 반환
typedef float quote;typedef string symbol;interface QuoteService{ quote getQuote(inout symbol stock); boolean createGroup(inout, string groupName, in symbol sym1, in symbol sym2, in symbol sym3); boolean getGroupQuote(inout string groupName, out quote quo1,
out quote quo2, out quote quo3);
boolean getGroupSymbols(inout string groupName, out symbol sym1,
out symbol sym2, out symbol sym3 );
};
2.2.5 IDL 컴파일
IDL 컴파일러는
다음과 같은 네 개의 파일을 만들어 낸다.
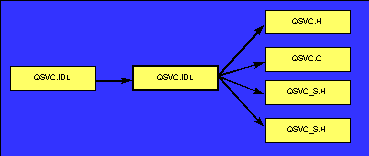
[ 그림 4-17
] IDL 컴파일 후 생성된 파일들
2.2.6 서버 프로그램
작성
이제 IDL 컴파일이
완료되고 앞서 언급했던 4개
파일이 만들어 지면, 이제
구현 객체를 작성해야 한다. 다시
말해 QuoteService 구현
객체와 구현 객체를 관리(서버)하는
main 프로그램을
작성해야 한다.
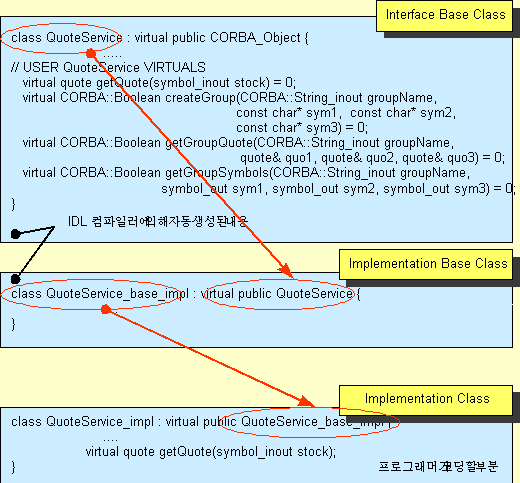
QSVC.H와 QSVC_S.H 파일에서 관심을 끄는 클래스는 Interface base class인 Class QuoteService와 Implementation base class인 Class QuoteService_base_impl이다. QuoteService는 CORBA::object 클래스로부터 상속을 받으며, QuoteService_base_impl은 QuoteService로 부터 상속을 받는다[그림4-18] 참조. 이제 프로그래머는 QuoteService_impl을 정의한 프로그램을 작성하기만 하면 된다.
.
구현 객체 프로그램을 작성할 때 프로그래머는
QuoteService 클래스가
선언되어 있는 QSVC_S.H를
반드시 포함하여야 하며, getQuote(), createGroup(),
getGroupQuote() 오퍼레이션을
QuoteService_impl 클래스에
다시 선언해 주어야 한다. 이제
전체 클래스 선언 부분이 마무리 되고 프로그래머는 이들 클래스에
대한 코드만 작성함으로 써 구현 객체의 프로그램은 완료가 된다.
이제 남은 일은 서버 main
프로그램을 작성하는 것이다.
서버 프로그램은 [그림4-19]와
같은 작업을 하여야 한다.
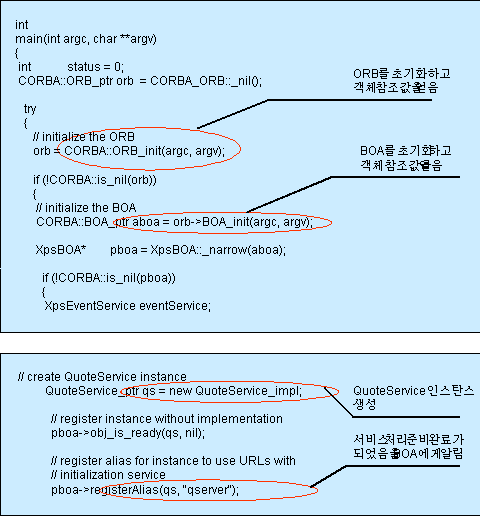
[ 그림4-19
] 서버 프로그램
2.2.7 클라이언트
프로그램 작성
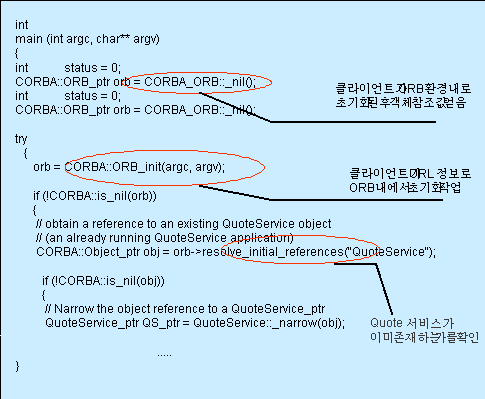
SII를 사용하는
클라이언트 프로그램은 다음과 같은 작업을 하여야 한다 [
그림 4-18
] 참조.
============================ 요 약 : PowerBroker ===========================
PowerBroker는 1991년에
1.0 버젼을
발표한 이후로 현재까지 버젼 2.0을
발표하였으며, CORBA 2.0에서
표준화한 ORB의
모든 컴포넌트들을 준수한 ORB를
제공하고 있다. 또한
복잡한 분산 객체 시스템을 손쉽게 관리하기 위하여 다양한 GUI툴을
제공하며, 이
GUI툴에는
보안 시스템 설치, 특정
머쉰의 컴포넌트 등록, 그리고
컴포넌트의 시작 등의 기능이 포함되어 있다.
PowerBroker는 C++와
스몰톡을 지원하는 두 종류의 제품이 있다. 또한,
프로그래머가 어플리케이션 프로그래밍에만
전념할 수 있도록 C++ 기반의
대규모 분산 시스템 개발 및 관리를 위한 Extended
C++ 제공하고 있다.
여기서는 Extended
C++제품을 중심으로 설명하도록
한다.
주요 특징
원격지상의 구현 객체가 서비스를 진행하고 있는 동안 프로그램이 프로세싱을 계속 진행 시킬 수 있다.
단일 쓰레드 및 다중 쓰레드 플랫폼 환경을 지원한다.
인터페이스 저장소의 컴포넌트를 편집,
검색, 부라우징
할 수 있게 해 준다. 이
기능을 통해 새로운 IR 정의
및 매개변수 유형을 추가 또는 변경 할 수 있으며 IDL을
생성할 수 도 있다. 아울러
네트웍 상에서 다른 사용자가 IR 내용을
변경하는 경우 다른 사용자에게 이를 통지하는 기능을 제공한다.
지원 서비스
PowerBroker은 명명
서비스, 생명주기
서비스,이벤트
서비스를 제공한다. 명명
서비스는 구현 객체들의 위치를 찾기 위해 사용자에게 친숙한 이름을
가진 수직적 디렉토리를 제공한다. 그리고
빠른 처리를 위해 다중 쓰레드 기법을 사용하며 분산된 명명 서비스의
통합을 지원한다
원격 메소드들의 호출 작업시 블럭킹없이 비동기적으로 어느 위치에 있든 상관없이 호출되도록 한다.
여러 종류의 플랫폼상에서 반환 값 및 매개변수로서 복잡한 임의의 구현 객체의 전달을 지원한다.
동적으로 구현 객체 이동을 지원하기 위해 객체 값 매개변수를 사용한다. 어플리케이션들은 투명하게 호스트에서 호스트로 실행 중인 구현 객체들을 직접 이동할 수 있다. PowerBroker는 자동적으로 구현 객체의 상태 정보를 전달하고 클라이언트의 구현 객체에 대한 연결을 재설정한다.
명명 서비스와 같은 구현 객체 서비스
내의 오퍼레이션 종료, 구현
객체 및 프로세스의 생성과 종료같은 상태 변화를 보고하고 검색할
수 있는 기능을 통해서 객체들의 상태를 모니터링할 수 있다.
어플리케이션은 전체 도메인 또는
특정 호스트에서 사용하고자 하는 이벤트를 이벤트 클래스 내에 등록할
수 있으며 Extended C++는
이벤트 관리 클래스를 통하여 효과적으로 어플리케이션에게 비동기
통지를 전달할 수 있다.
먼저 PowerBroker은
프로그램 개발 측면에서 [ 그림
4-19 ]와
같은 구조를 갖는다. 각
구조의 구성요소는 다음과 같다.
- IDL 컴파일러
IDL 소스를 읽어
들여 클라이언트, 구현
객체 측 프로그램을 만들어 낸다. C++ 헤더
파일은 클라이언트 , 구현
객체에 포함되고 응용 프로그램에 링크 되는 C++
실행 코드가 포함된다.
또한 인터페이스 저장소 파일을
생성한다.
- 인터페이스 저장소 파서와 로더( Interface Repository Parser and Loader , IRPAL)
IDL 컴파일러가
만든 인터페이스 저장소 파일을 인터페이스 저장소 엔진에 등록하고
인터페이스에 대한 객체 지향적 설명(description)을
만들어 낸다.
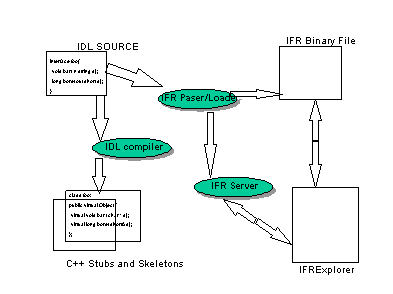
[ 그림4-19
] PowerBroker의 개발 구조도
- 인터페이스 저장 서버(Interface Repository Server)
인터페이스 저장소 엔진에서 수행 가능한
바이너리 파일을 저장한다.
- IFR 탐색기
인터페이스 저장 서버와 파일들을 검색하거나
수정하는 그래픽 툴이다. 이것은
CORBA 표준에서
정의한 것이 아니라 PowerBroker에서
독자적으로 제공하는 유틸리티이다.
앞서 살펴본
구조가 PowerBroker의
개발 구조를 살펴본 것이라면 다음 [그림
4-20 ]은
PowerBroker의
수행 구조를 나타낸 것이다.
각 수행 구조는 다음과 같다.
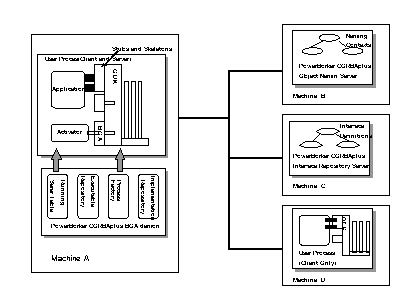
[ 그림
4-20 ] PowerBroker 수행
구조도
- 객체 분산 커널( Object Distribution Kernel, ODK)
ODK는 [그림4-21]
구조를 갖으며 객체의 분산 투명성을
관리하는 틀(framework)이자
디자인 패턴이다. 이런
패턴은 CORBA 표준에서는
정의 되지 않았다. ODK는
PowerBroker의
핵심이며 실행 시간 때 수행되는 프로세스이다.
ODK는 다음과 같은 기능을 수행한다.
* 메시지 형성(Message structure and formatting)
* 매개변수 전달
* 쓰레드 관리
* 입/출력 관리
* 비동기 관리
* 클라이언트측 Request/Reply 관리
* 구현 객체 위치와 Request 관리
* 구현 객체의 실행과 중단
* 객체 참조자의
생성과 관리
이런 기능들이 추상화 되어 다른 프로그램
언어, 다른
운영체제 , 다른
객체 모델, 다른
네트웍 환경 등 에서도 재사용을 용이하게 한다.
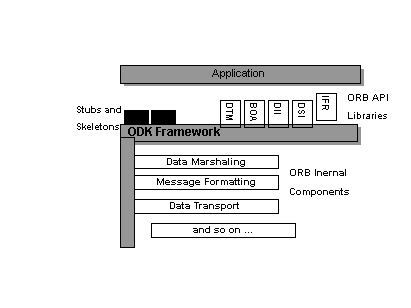
[ 그림4-21
] ODK 블럭 구성도
- CORBA 라이브러리
인터페이스 저장소,
DII, DSI, ORB 와 BOA
pseudo-object등과 같은 CORBA
인터페이스는 응용 프로그램에
정적, 동적으로
링크가 될 수 있도록 라이브러리로 구현되었다.
- 인터페이스 저장소
IDL로 작성한 인터페이스의
정보를 저장한다. 동적
호출시 이용된다.
- BOA 데몬
주요 기능은 구현 객체의 실행과 관리이며
그 외의 기능은 다음과 같다.
* 클라이언트의 요청에 의한 구현 객체의 실행
* 구현 객체의 관리와 위치 지정
* 정의된 실행 규칙의 집행
* 서버 구현 객체에
대한 설명 저장
- 구현과 실행 저장소(Implementation and Executable Repositories)
BOA 데몬은 클라이언트에서
보낸 request를
받아 실행시킬 구현 객체를 찾는다. 이때
적당한 서버 구현 객체를 지정할 수 없을 때 구현 저장소와 실행
저장소를 찾는다. 다른
ORB 제품과는
달리 PowerBroker에서는
구현과 실행을 구별한다. 구현은
CORBA 인터페이스
타입을 구현한 코트로서 여러 다른 실행 파일에 링크 되어 사용된다.
- 실행자(Activators)
ORB가 현재 실행되지
않는 구현 객체에 대한 요청을 받았을 때 해당 구현 객체의 식별자에
대한 매핑을 실행자가 담당한다. 즉,
ORB가 구현 객체에 대한 요청을
받았을 때 해당 타입에 대한 실행자를 수행 시킨다.
실행자는 실행할 구현 객체에
대한 식별자를 넘겨 주게 된다. 이러한
식별자 정보는 데이타베이스 질의 키로 사용되고 질의의 결과로서
새로운 인스턴스를 만들고 이를 ORB에
넘기게 된다. 그러면
ORB는 서버
구현 객체를 등록하고 클라이언트의 요청을 실행한다.
- 명명 서비스
CORBA 서비스에서
정의한 명명 서비스를 제공하며 이런 서비스를 제공하는 서버는 하나이고
여러 호스트에서 실행 된다.
PowerBroker의 명명
서비스를 관리하기 위한 GUI 툴이다.
실행 시에 사용자는 PowerBroker의
이름 보관 장소내에 등록된 정보를 다시 구성하거나,
수정 및 부라우징 할 수 있다.
PowerBroker을 사용하여
다양한 이벤트에 대한 로그 내용을 만들 수 있다.
로드 툴을 사용하여 동적으로
로그 내용을 볼 수 있다.
등록 툴은 동적인 구현 객체의 등록을
위해 제공되는 프로그램이다.
활성화된 클라이언트, 구현 객체간의 연결 상태, 관리되는 구현 객체 및 어플리케이션의 프로세스 상태를 동적으로 보여주는 관리 프로그램이다. 이 툴은 원격지의 구현 객체에서 제공하는 서비스와 로컬 인터페이스 사이의 통신상태를 추적할 수 있는 기능을 제공한다.
========================================================================
4막을 마치며
CORBA의 기본 철학은 이종의 환경하에서 특정 구현언어에 종속되지 않는 프로그램을 작성하여 시스템을 통합하는 것이다. 이를 위해 가장 중요한 기능이 IDL언어이다. IDL은 C, C++같은 구현 언어가 아니라 사용자가 생각하고 있는 문제의 인터페이스를 정의해주는 언어이다.
IDL은 객체지향
개념을 지원하며 C++이나
자바같은 구현언어로 변환된다. 사용자는
원하는 IDL 파일을
작성하고 IDL 컴파일러를
통해 원하는 언어로 변환한 후 필요한 로직을 추가하면 된다.
우리는 여기서 Orbix와
PowerBroker라는
제품을 사용하여 응용 프로그램을 작성해 보았다.
[ 다음 | 이전 ]