5막
CORBA에
연동할 수 있는 것들
1장.
마이크로소프트의 희망,
DCOM/OLE
CORBA와
직접적으로 경쟁하는 표준은 마이크로소프트의 COM(Component
Object Model)이다
.
COM은 윈도우 운영
체제가 차지하고 있는 비중만큼 가장 널리 사용되고 있는 윈도우 버스이다
.
따라서 CORBA는
계속적으로 마이크로소프트의 객체 표준인 COM/OLE와
CORBA와의
연동 문제를 고민해 오고 있다.
이 문제에 대해
CORBA는
2개의
부분으로 나뉘어 현재의 COM/OLE에
CORBA를
결합하는 문제와 앞으로 대두될 분산 COM/OLE와
의
통합에 대한 문제를 준비 중에 있다.
기존의 COM/OLE와의
통합 문제는 정리가 되어 상당수의 CORBA제품
들이
OLE와
연동 가능한 제품을 공급하고 있으며 분산COM/OLE와
의
통합 문제는 마이크로소프트의 정식 버전이 발표되기만을 기다리고
있는 상태이다.
CORBA의 기술적
성장 과정하에서 우리는 CORBA와
마이크로소프트의 객체 표준인 COM/OLE를
비교해 보고 이의 통합 방법에 대해 정리해 보도록 한다.
이를 위해 먼저
마이크로소프트의 COM과
OLE에
대해서 살펴보고 이를 CORBA와
종합적으로 비교해 본다.
1.1 마이크로소프트의
배경 기술
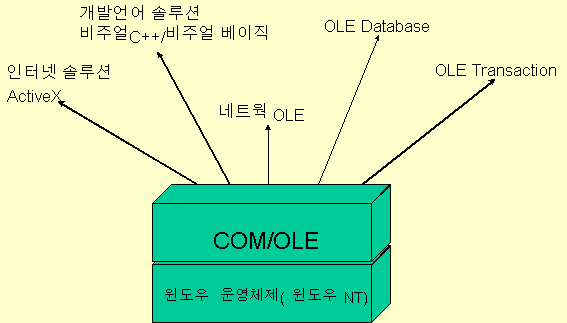
마이크로소프트 기술의 근간을 한마디로 표현하자면 OLE(Object Linking and Embedding)과 COM(Component Object Model)이다. 따라서 마이크로소프트의 기술을 이해하려면 COM/OLE의 이해가 필수적이다. 이러한 근간 기술을 기반으로 마이크로소프트는 윈도우3.1과 윈도우95 그리고 윈도우 운영 체제의 종착역으로 표현되는 NT에 이르기까지 다양한 그림 운영 체제를 지원하고 있다. 이들 그림 운영 체제 역시 종국에는 분산 환경을 지원하는 COM/OLE를 내장할 예정이다. 뿐만 아니라 개발 언어에 있어서도 마이크로소프트의 비주얼 C++과 볼랜드의 C++을 중심으로 한 시스템 프로그램 개발 환경과 비주얼 베이직을 통한 응용 프로그램 개발 환경을 제공하고 있다. 이들 역시 COM/OLE를 이용하고 작성하는 데 중심이 맞추어져 있다. 마지막으로 최근 들어 가장 많은 화제와 관심거리를 제공하는 인터넷에 있어서도 ActiveX라는 이름으로 COM/OLE기 술을 인터넷에 접목시키기 위한 노력을 경주하고 있다. 한마디로 마이크로소프트의 모든 기술은 COM/OLE라 고 말할 수 있다.
종국적으로 마이크로소프트는
OLE/데이타베이스
, OLE/트렌젝션
, 네트웍
OLE처럼
COM/OLE를
중심으로 기존의 다른 기술을 포함할 것을 목표로 하고 있다.
[그림5-1]
마이크로소프트의
기술배경
1.2 OLE란?
대부분 마이크로소프트에
관심이 있는 사람이라면 정확하게 정의하긴 힘들어도 OLE에
대해서 막연히 워드 내에 엑셀 쉬트를 삽입하거나 파워포인트 그림을
삽입하는 등 서로 다른 데이타를 통합하여 하나의 문서를 만드는 방법으로
이해하고 있을 것이다.
비슷하게 일맥상통하기는
하지만 좀 더 정확히 정의하자면 초기 OLE(Object
Linking and Embedding)는
사용자에게는 마치 하나의 데이타처럼 보이지만 실제로는 두개 이상의
다른 응용 프로그램을 사용하여 생성된 정보인 복합 문서를 작성하기
위한 기술이다.
그러나 지금에
와서 OLE는
단순한 복합 문서를 작성하기 위한 기술이 아니라 COM(Component
Object Model)이라는
기술을 바탕으로 다양한 응용 시스템을 작성하는 기술로 인식되고
있다. 이때,
COM은 복합 문서
작성을 위한 응용 프로그램간의 통합뿐 만 아니라 모든 윈도우 응용
프로그램들간의 통합이 가능한 마이크로소프트의 윈도우 객체 버스를
말한다.
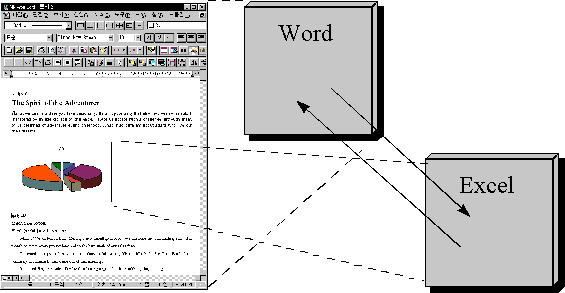
[
그림5-2
] 복합 문서의
구조
1.2.1 OLE의
개발역사
초기 마이크로소프트사의 (파워
포인트)소프트웨어
개발팀은 윈도우에서 지원하는 응용 프로그램간의 데이타 교환 방법인
DDE(Dynamic Data
Exchange)를
확장한 새로운 데이타 교환 방법을 제안하였는데 이것이 OLE였고,
이후 마이크로소프트사의 모든
윈도우용 응용 프로그램에 적용되었다.
이후 OLE는
각각의 주요한 기능에 따라 버전이 향상되어 현재에 이르고 있는데
각각의 특징은 다음과 같다.
OLE 1.0은
[그
림5-2]에서
처럼 멀티미디어, 텍스트,
이미지 ,음성과
같은 다양한 정보를 한 문서에 저장할 수 있는 복합 문서(Compound
Document) 기능을 프로세스간의
통신을 담당하는 IPC(Inter-Process
Communication)로 구현하였다
.
이런 배경에는 이후 윈도우 운영
체제를 복합 문서 중심의 운영 체제로 전환하기 위한 마이크로소프트의
전략이 숨어있었다.
OLE 2.0에서
마이크로소프트는 복합 문서상에서 시각적 편집이 가능하도록 원하는
정보의 조작시 해당 응용 프로그램이 수행되는 In-Place
Activation 기능과 객체간의 통합에서
LRPC(Light Remote Procedure
Call)기능을
제공하였다.
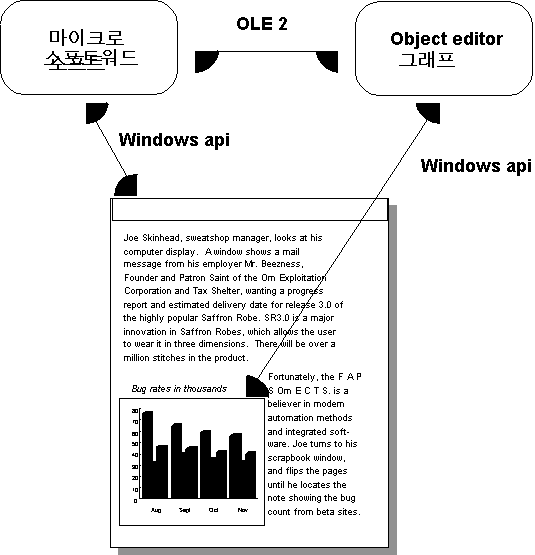
[ 그림5-3 ] OLE 2.0에서의 윈도우 객체
OLE 3.0은
객체간의 통신을 완전한 RPC(DCE
RPC를 이용)로
대체하여 분산 윈도우 객체환경을 지원할 예정이다.
특히 1997년경에
발표될 차세대 윈도우 NT 버전에서는
파일 시스템이 OLE를
이용하여 구현되고 있어 윈도우 NT는
객체 중심의 운영 시스템이 될 것이다.
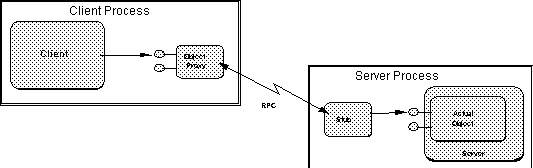
[
그림5-4
] OLE 3.0에서의 윈도우 객체
1.2.2 OLE의
기본 토대
일반적인 응용 프로그램을 작성한다고
생각해보자. 이때
응용 프로그램은 해당 작업을 위해 운영 체제 ,
각종 라이브러리 또는 다른 프로세스와
정보를 교환해야 한다. 일반적으로
이 경우 응용 프로그램 작성자는 운영 체제와 정보를 교환하기 위해
시스템 호출 방법을 사용해야 하고 라이브러리와는 API호출
,
다른
프로세스와는 IPC호출
방법을 사용해야 한다. 이러한
상황은 OLE에서도
마찬가지이다. 앞서
OLE가
다양한 응용 프로그램과의 상호작용을 통해 각종 서비스를 창출함을
알아보았다. 당연히
이를 위해 OLE 프로그램
작성자는 앞선 3가지
방법을 알아야 만 한다.
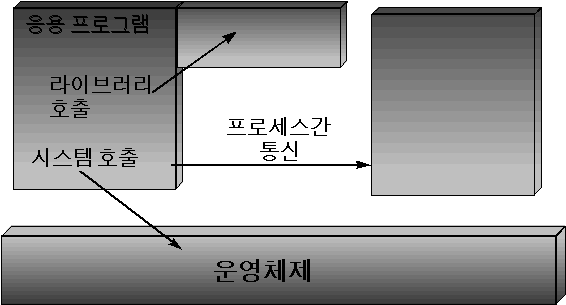
[
그림5-5
] 서비스 요청을 위한 3가지
방법
만약 3가지
방법을 모두 알아야만 한다면 응용 프로그램 작성자는 정보를 교환하고자
하는 모든 응용 프로그램과 운영 체제 ,
라이브러리 마다 각기 다른 방법을
사용해야만 한다. 도저히
무모한 작업임이 뻔하다. 이러한
문제점의 해결책이 단일한 인터페이스를 제공해주는 COM이다.
따라서 OLE의
기본 토대는 COM이다.
COM은 COM을 이용하는 모든 응용 프로그램에 단일한 접근이 가능하게 해준다. 좀더 자세히 살펴보면 COM은 [ 그림5-6 ]과 같은 구조를 갖는다.
이 구조를 보면 COM 객체는 해당 객체에 대한 접근을 위해 복수 개의 인터페이스를 제공한다. 인터페이스는 복수 개의 메소드로 이루어져 있다. 참고로 뒤에서도 다시 언급하겠지만 이점이 CORBA에서 제공하는 객체와 다른 점이다. CORBA에서 객체는 단일한 인터페이스만을 제공하는 데 반해 COM 객체는 복수 개의 인터페이스를 제공한다. 그러나 CORBA3.0 표준에서는 복수 인터페이스 기능을 제공할 예정이다. 참고로 COM 객체를 언급하는 모든 문서에서 원은 인터페이스를 나머지 사각형은 객체를 의미한다.
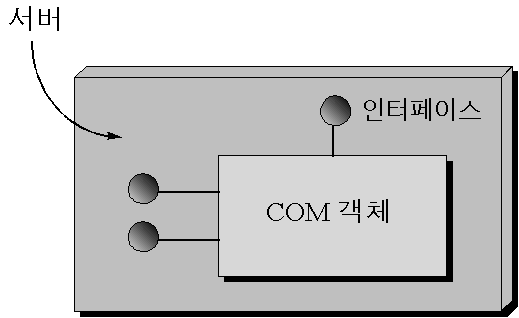
[ 그림5-6 ] COM의 객체 구조
만일 이러한 COM
객체를 이용하여 각종의 라이브러리나
응용 프로그램을 작성하거나 운영 체제에서 COM
인터페이스를 제공한다면 단일한
COM 인터페이스를
통해 모든 서비스를 이용할 수 있게 된다.
일단 COM
객체를 이용하려면 먼저 인터페이스에
대한 포인터를 얻어 후 이 포인터를 통해 원하는 메소드를 수행하면
된다.
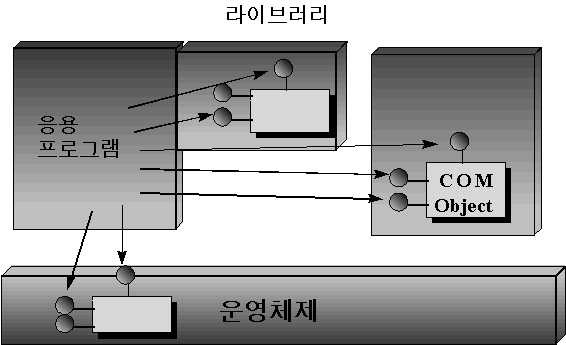
[ 그림5-7 ] COM 객체를 이용한 서비스 요청
1.2.3 OLE의
기본 서비스
가장 하위에 윈도우 객체 버스인 COM을
기반으로 하여 OLE기능을
이용하는 데 유용한 기본 서비스들이 제공된다.
이 기본 서비스들은 수많은 OLE
응용 기술에 의해서 사용되어지는
기술이다.
COM을
기반으로 한 파일 시스템으로서 여러 파일들을 COM을
기반으로 하여 논리적으로 구성해준다.
특정 객체의 인스턴스를 초기화하고 생성해주며
객체 이름 등의 정보를 제공한다.
바로 이 기능을 이용하여 COM
객체를 생성할 수 있다.
응용 프로그램 사이의 자료 교환을 위한
일반적인 방법이다.
다른 응용 프로그램으로 하여금 해당
프로그램의 메소드를 사용할 수 있게 해주는 서비스를 말한다.
이외에도 각종 컴포넌트 기술을 OLE에서
사용할 수 있게 해주는 OCX(OLE
Control Extension)로 알려는
OLE 조정
기능이 있으며 OLE/데이타베이스
, OLE/트렌젝션
,
네트웍
OLE 등이
추후 제공될 예정이다.
1.3 OLE의
윈도우 객체 버스 COM(COMPONENT
OBJECT MODEL)
COM은
CORBA와
마찬가지로 윈도우 세상에서 버스 역할을 담당하는 윈도우 객체 버스이다.
다시 말해 COM은
클라이언트 프로그램과 객체서버 프로그램간의 상호 통신 방식을 정의한
모델로서 객체간의 통합을 지원한다.
COM은
[그
림5-8]에서
처럼 여러 개의 응용 프로그램안에서 복합 객체 사이의 인터페이스를
정의하도록 해주며 이 인터페이스를 통해 응용 프로그램들이 복합
문서 등 다양한 기능을 이용한다.
이러한 COM을
기반으로 하여 복합 문서를 구성하는 데 필요한 다양한 서비스를 지원하기
위해 구성된 기능이 복합 문서관리 ,
복합 파일 ,
일관된 자료 교환 ,
OLE 자동화 등이다.
이러한 기능들을 일반적으로
OLE2.0이라
한다.( 실제
이 기능 외에도 OCX , 모니커
,
타입
라이브러리 등 다양한 기능이 있다.)
결국 OLE란
COM을
기반으로 하여 생성된 객체를 의미한다.
실제 이러한 COM구조를
CORBA와
비교하여 생각해보면 단일 머쉰상에서 수행되는 CORBA의
기능과 같다. 다시
말해 COM의
인터페이스만 이용하면 해당 머쉰상에서 다른 윈도우 객체의 서비스를
이용할 수 있다. 이러한
제약을 극복하고 네트웍상의 복수 머쉰사이의 서비스를 위해 개발중인
것이 분산COM(DCOM, Distributed
COM)이다.
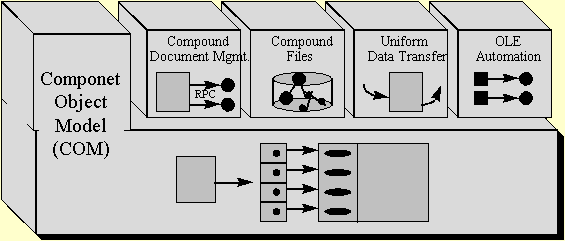
[ 그림5-8
] COM 구성도
1.3.1 COM의
객체 모델
사실 COM의 객체 모델에 대해서는 논란이 많지만 마이크로소프트의 말을 전적으로 빌리자면 COM 객체는 데이타와 메소드로 구성되어 있다. COM 객체는 개발되는 언어에 독립적으로 개발되어 질 수 있다. 왜냐하면 단지 인터페이스만을 알고 이를 통하면 원하는 메소드를 호출할 수 있기 때문이다. 실제 이 인터페이스에 대한 자세한 언급을 하기 전에 과연 COM 객체가 왜 컴포넌트 객체를 구성하는데 유리한지 생각해보자. 일반적으로 C나 C++은 일반 응용 프로그램을 작성하는 데 편리하다. 그러나 개발되어 있는 컴포넌트를 재사용하는 것은 힘들다. 왜냐하면 바이너리에 대한 표준 인터페이스가 없기 때문이다. 이런 점에 대한 대응책으로 COM은 인터페이스를 통한 바이너리 표준을 제공한다. 이 표준을 이용하면 C++객체든 다른 바이너리 객체든 상관할 것 없이 응용 프로그램을 작성할 수 있다. 예를 들어, 비주얼 베이직같은 툴을 이용하여 다양한 바이너리와 객체를 조작하는 프로그램을 자주 볼 수 있다.
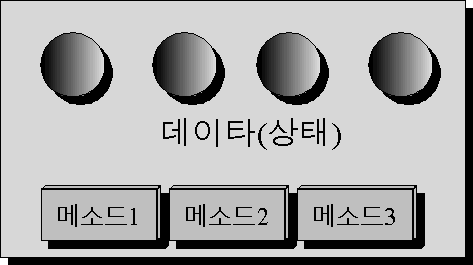
[ 그림5-9
] COM 객체
1.3.2 COM 인터페이스
실제 COM
객체를 자세히 살펴보면 [그림
5-10]에서
처럼 객체의 메소드들의 집합인 인터페이스가 다수 존재하고 있음을
알 수 있다.( 메소드들을
둘러싸고 있는 4각형)
이 인터페이스는 복수 개 존재할
수 있으며 각기 다른 메소드를 포함할 수 있다.
이러한 방법의 장점은 다양한
인터페이스를 제공하여 접근을 제어할 수 있다는 점을 들 수 있지만
프로그램을 작성하기가 번거로우며 객체의 추상화와 갭슐화의 강도를
약화시킨다는 점을 들 수 있다.
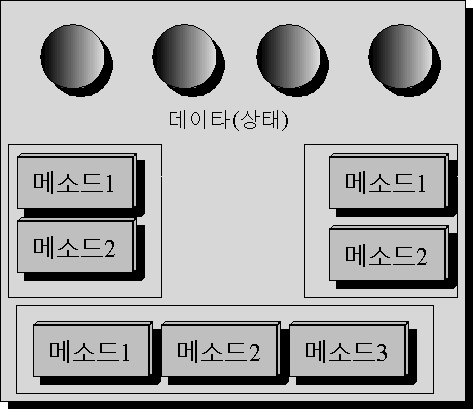
[ 그림5-10
] 인터페이스를 포함한 COM
객체
또한 COM은 이러한 인터페이스를 작성하기 위한 기반 도구로서 IDL을 제공한다. COM IDL은 CORBA IDL과 마찬가지의 역할을 한다. 그러나 COM IDL은 DCE IDL을 채용하여 사용하기 때문에 다양한 언어로의 매핑이 불가능하다. 왜냐하면 DCE IDL은 C언어로의 매핑을 전제로 하기 때문이다.
그렇다면 클라이언트가 인터페이스를 통해 COM 객체의 메소드를 이용하는 과정을 알아보자. 먼저 [그림5-11]에서 처럼 클라이언트는 해당 인터페이스에 대한 포인터를 얻어야 한다. ( 실제 이 포인터는 COM에서 제공된다. ) 이 포인터를 따라가면 각 메소드를 가리키고 있는 함수 테이블이 있다. 따라서 이 함수 테이블에서 원하는 메소드를 호출하면 된다.
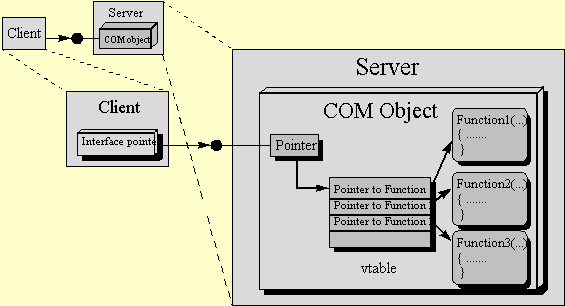
[ 그림5-11
] 인터페이스의 구현
1.3.3 COM IDL
앞서 잠시 살펴본 것처럼 COM은
CORBA의
IDL과
마찬가지로 인터페이스를 정의하기 위한 IDL을
제공한다. 다음은
COM IDL의
예이다.
[ object ,
uuid(a01d0280-2d88-11c0-9fd4-08002cled9e2)
]
interface Iaccount : IUnknown {
typedef [string] char name[25];
HRESULT GetBalance( [out] float *balance);
HRESULT GetOwner( [out] name owner);
HRESULT SetOwner( [in] name owner);
HRESUTL Credit( [in] float amount);
HRESULT Debit( [in] float amount);
}
[ 예5-1
] COM IDL 작성 예
이 예를 보면 COM IDL은 object라는 키워드로 시작한다. 이것은 DCE IDL의 확장을 사용한다는 것을 의미한다. object키워드에 이어서 나오는 것은 해당 인터페이스를 식별하기 위한 16 바이트 크기의 UUID(Universal Unique Identifier)이다. UUID는 GUID(Global Unique Identifier)라고도 불리는 데 인터페이스를 고유하게 식별해준다. 해당 인터페이스의 UUID는 마이크로소프트가 제공하는 유틸리티를 이용하거나 직접 마이크로소프트에 요청해서 얻을 수 있다. 참고로 COM의 모든 인터페이스는 UUID를, 클래스는 CLSID(Class ID)를 가지고 있다.
다음에 따라오는 것은 인터페이스의 정의부분으로서 원하는 인터페이스를 선언할 수 있다. HRESULT는 특별한 에러 핸들링을 위해 사용되는 21비트 long integer 형의 변수이다.
인터페이스는 다른 인터페이스를 상속
받을 수 있게 해준다. 그러나
주의할 점은 다중 상속은 지원하지 않는다는 점이다.
또한 구현 부분이 상속되는 것이
아니라 인터페이스 정의 부분만이 상속된다는 것이다.
1.3.4 COM의
기본 인터페이스들
COM은
모든 인터페이스들이 공통적으로 가져야 할 인터페이스로서 IUnknown이라는
인터페이스를 제공한다. IUnknown
인터페이스의 메소드는 인터페이스에
대한 포인터를 반환해주고 객체의 참조 카운터를 고려하여 생명주기를
관장한다. 이러한
기능을 위해 IUnknown은
다음의 메소드를 제공한다. 참고로
참조 카운터란 객체를 참조하고 있는 수를 기록해두는 방법이다.
따라서 참조 카운터가 0
이란 말은 해당 객체를 사용하는
다른 객체가 없다는 말이기 때문에 삭제할 수 있다.
해당 객체를 제공하는 인터페이스에 대한
포인트를 얻을 수 있는 방법을 제공해준다.
실제로 [그림5-12]에서
처럼 해당 클라이언트가 COM
객체의
메소드를 이용하기 위해서는 먼저 인터페이스 포인터를 가져야 한다.
이를 위해서는 먼저 해당 인터페이스의
ID
와
함께 IUnknown인터페이스의
QueryInterface를
호출해야 한다. 일단
해당 메소드가 호출되면 해당 인터페이스의 존재여부를 검사한 후
해당 인터페이스가 존재하면 인터페이스 포인터(X)를
반환한다.
클라이언트는 해당 인터페이스 포인터(X)를
이용하여 해당 객체(A)의
메소드를 호출하면 된다. 이
방법의 장점은 사용하고자 하는 컴포넌트의 버전이 변하더라도 클라이언트는
무관하게 사용할 수 있다는 장점이 있다.
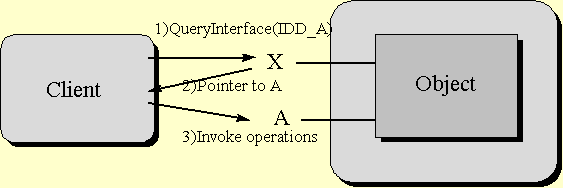
[ 그림5-12
] 질의 인터페이스의 사용
객체의 참조 카운터를 증가시킨다.
객체의 참조 카운트를 감소시킨다.
모든 객체는 자동적으로 생성되기도 하며
소멸되기도 한다. 이때
복수 개의 클라이언트들이 하나의 객체를 참조할 수 도 있다.
이 때 해당 객체는 자신이 참조되고
있는 정보를 유지해야 한다. 왜냐하면
만약 클라이언트 참조가 계속되는 순간 해당 객체가 소멸된다면 문제가
발생한다. 따라서
참조 시 발생하는 일관성을 유지하기 위해 참조 카운터를 사용한다.
일단 참조를 원할 경우 Addref를
사용하여 참조 카운트를 하나 증가시키며 참조를 원하지 않을 경우(사용을
다한 경우) Release를
사용하여 참조 카운트를 감소시키다.
결국 참조 카운트가 0일
경우 해당 객체에 대한 참조가 없는 것이기 때문에 해당 객체가 소멸해도
문제가 발생하지 않는다.
1.3.5 COM 객체의
구현 방법
모든 COM
객체는 COM
서버 내에 구현되어 클라이언트에게
인터페이스를 제공한다. 이
서버는 다음의 3가지
방법 중 하나에 의해서 구현될 수 있다.
모든 객체는 DLL내에
구현된다.
객체는 같은 머쉰 상의 분리된 프로세스내에서
구현된다.
객체는 다른 머쉰 상에 구현된다.
위의 방법 중 Remote 방법은 현재 지원되지 않는다 . 따라서 COM서버는 단일 머쉰 상에서만
이용할 수 있다.
그러나 현재 마이크로소프트는
OSF DCE의
RPC를
이용하여 이를 구현 중에 있다.
1.3.6 COM 커널
COM 객체의 클라이언트와 서버는 모두 COM커널을 이용한다. 따라서 COM커널은 윈도우 DLL로 구성되어 있으며(COMOBJ.DLL) 함수호출을 통해 이용할 수 있다. 그렇다면 COM 객체의 클라이언트와 서버가 COM 커널과 유기적으로 작동하는 과정을 살펴보자.
[그림
5-13]에서
처럼 먼저 클라이언트는 CoCreateInstance
메소드를 호출하여 COM커널에
서비스를 요청한다. 이때
해당 객체의 클래스 ID와
인터페이스 ID를
함께 전달한다. 해당
서비스 요청을 받은 COM커널은
윈도우 운영 체제의 시스템 데이타베이스인 레지스트리에 등록된 정보를
이용하여 해당 서버의 위치를 찾고 구동시킨 후 해당 서버의 인터페이스
포인터(A)를
클라이언트에게 반환한다. 해당
클라이언트는 전달받은 인터페이스 포인터를 이용하여 원하는 메소드를
수행한다.
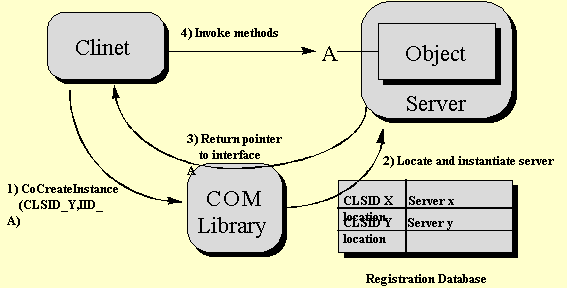
[ 그림5-13
] 객체의 초기화
1.3.7 COM에서의
재사용 기법
COM에서는
기존의 존재하는 컴포넌트의 코드를 재사용하기 위해 다음의 2가지
방법을 사용한다.
먼저 컨테인먼트는 두개의 객체중 다른
객체를 포함하는 외부 객체의 클라이언트에게 포함된 내부 객체를
직접 사용하지 못하게 하는 것인데 반해 에그리게이션은 포함된 내부
객체의 인터페이스를 외부 객체의 클라이언트에게 제공하는 것이다.
구현상으로 보면 컨테인먼트는
단순하며 가장 일반적인 방법인데 반해 에그리게이션은 복잡하고 구현하기
어렵다.
1.4 기타
OLE의
서비스들
1.4.1 리
모트
오토메이션(Remote Automation)
리모트 오토메이션은 네트웍 OLE에
대한 대체 개념이다. 이
개념은 OLE 오토메이션의
인터페이스를 통해 클라이언트 /
서버 응용 프로그램들을 개발할
수 있는 기능을 제공할 뿐만 아니라 다단계 클라이언트 /
서버 시스템을 구현하는 데 필요한
컴포넌트들의 배치 기능을 제공한다.
또한 클라이언트 응용 프로그램들이
윈도우 95 나
윈도우 NT상에서
운용되어지는 OLE 서버
응용 프로그램들과 대화할 수 있는 기능을 제공한다.
오토메이션 프록시(Automation Proxy)
클라이언트 머쉰상에 위치하며 한 오토메이션
클라이언트가 단일 머쉰상에서 사용하는 일반적인 OLE
프록시 기능을 담당한다.
오토메이션 관리자(Automation Manager)
서버 머쉰상에 위치하며 클라이언트
머쉰의 오토메이션 프록시로 부터의 요구들을 서버 머쉰의 적절한
오토메이션 스터브와 오토메이션 서버로 전달하는 역할을 한다.
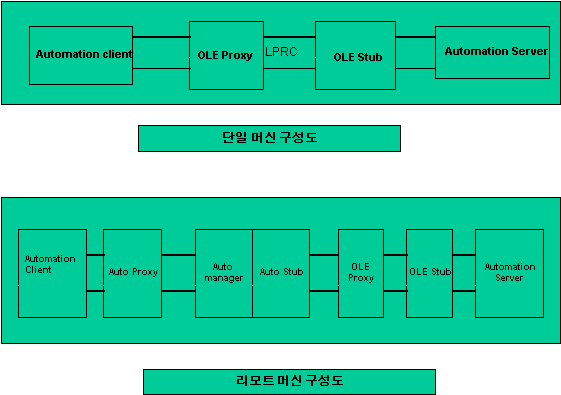
[
그림5-14
] 리모트 오토메이션 구성도
리모트 오토메이션이 제공하는 장점은 다음과 같다.
먼저 각각의 클라이언트 응용 프로그램의
코드를 하나의 중앙 서버(centralized
server)로 옮김으로써,
응용 프로그램의 유지 및 보수가
단순화 되어 관리 비용을 줄일 수 있으며 리모트 OLE
오토메이션 서버를 클라이언트와
서버 사이에 위치시킴으로써, 개발자들은
비주얼 베이직을 사용하여 응용 프로그램을 개발할 수 있다.
또한 크고,
시간 집약적인 작업들을 원격지의
서버 머쉰에 위탁할 수 있다. 마지막으로
원격 오토메이션 기술을 사용하여 배치된 서버들은 OLE
클라이언트 어플리케이션들에
의해 쉽게 사용되어 질 수 있으며 각종 네트웍을 경유하여 쉽게 접근할
수 있다.
1.4.2 OCX
OCX(OLE Control Extension)는
OLE 인터페이스를
제공하는 오토메이션 서버 프로그램으로서 폼을 작성하는 클라이언트
툴 프로그램내에서 사용되는 사용자 정의 컨트롤이다.
OCX는 OLE인터페이스를
제공하는 모든 클라이언트 툴에서 사용할 수 있는데 현재 사용할 수
있는 제품으로는 액세스 2.0, 비주얼
베이직 4.0, 델파이
등이 있다. OCX 컨트롤은
PC 소프트웨어
환경에서 마이크로소프트사가 제안한 COM(Component
Object Model) 모델을 따르고
있다.
1.4.2.1 커
스텀
컨트롤의 정의
마이크로소프트 윈도우에서의 컨트롤이란
윈도우에 삽입되어 자신이 가지고 있는 특정한 기능을 삽입되는 부모
윈도우에 제공하는 하나의 자식 윈도우를 말한다.
한 예로 한 윈도우가 사용자로
부터 문자열을 입력받고 싶으면 문자열 입력의 기능을 가지고 있는
에디터 컨트롤을 삽입한 후 그 컨트롤로 부터 문자열을 입력받을 수
있다. 또한
버튼 컨트롤을 삽입하여 사용자부터 어떠한 명령을 받을 수도 있다.
이처럼 윈도우와 사용자간의 인터페이스
역할을 담당하는 것이 컨트롤의 가장 큰 목적이다.
사용자는 이 컨트롤을 통해 윈도우에게
어떠한 일을 지시하고, 윈도우는
이 컨트롤을 통해 처리한 결과를 보여줄 수 있다.
거의 모든 윈도우가 이 컨트롤을
이용하여 작성된 것이라 해도 과언이 아니다.
마이크로소프트 윈도우는 기본적으로
위에서 예를 든 에디터, 버튼
외에도 리스트 박스, 트리
뷰, 프로그램
바, 툴
바 등 20개
이상의 컨트롤을 내장하고 있다.
이를 윈도우 컨트롤이라 부른다
.
사실 윈도우가 기본적으로 제공하는 컨트롤만을
사용해서 윈도우를 작성한다면 사용자 인터페이스는 극히 제한적이
될 것이다. 따라서
윈도우가 제공하는 기본 컨트롤 외에 사용자가 직접 사용자 컨트롤을
만들고, 작성한
컨트롤을 윈도우에 삽입하여 사용할 수 있는 방법이 필요하게 되었다.
이에 대한 마이크로소프트의 첫번째
해결책이 VBX(Visual Basic
Extension)이었다.
그러나 VBX를
삽입해서 사용할 수 있는 윈도우의 종류가 비주얼 베이직 등 몇 개
밖에 되지 않았고 그 수행 속도도 그리 빠르지 못하다는 단점이 있었다.
그럼에도 불구하고 전세계에 걸쳐
수백 개의 컨트롤이 개발되고 판매되어 하나의 소프트웨어 시장을
형성하게 되었다.
VBX시장이
무르익을 무렵 마이크로소프트사에서 새로 가지고 나온 사용자 컨트롤
명세가 OCX이다.
이것은 OLE2.0에서
윈도우에 개체를 삽입하는 방법을 그대로 이용하여 사용자 컨트롤을
만들자는 것이다. 사용자
컨트롤도 OLE객체로
만들자는 것은 마이크로소프트가 지향하는 분산 객체지향 운영 체제의
일환일 것으로 생각된다. 즉
OCX는
OLE객체로서의
사용자 컨트롤이라고 말할 수 있다.
OCX는 그 아키텍쳐에 있어서는
VBX와
전혀 다르지만 일반 사용자가 사용하는 방법은 거의 동일하다.
1.4.2.2 VBX컨트롤과
OCX컨트롤과의
가장 큰 차이점
VBX 컨
트롤
마이크로소프트사에서 컴포넌트웨어라는
새로운 소프트웨어 개념을 제시한 후 그 개념을 도입한 첫번째 제품이
비주얼 베이직이였다. 비주얼
베이직이 컴포넌트웨어의 개념을 지닐 수 있었던 것은 VBX(Visual
Basic Extension) 컨트롤 때문이였다
.
윈도우 시스템은 몇 가지 기본적인
컨트롤을 제공하고 있었으나 종류는 다양하지 않았고,
필요한 경우 사용자가 필요한
컨트롤을 만들 수 있는 방법을 제공하고 있었다.
VBX 컨트롤
은
일종의 사용자 정의 컨트롤이라 할 수 있는데 이는 비주얼 베이직과
가장 잘 어울리도록 설계되고 구현되었다.
VBX 컨트롤과 비주얼 베이직 사이의
상호 통신은 윈도우의 메세지 큐를 사용하여 구현되었다.
메세지 큐의 메세지는 윈도우에
의하여 차례로 수행되었기에 때로는 대기 시간이 길어질 수 있었고
사용자에게는 다소 느린 느낌을 주었다.
통신을 위하여 새로운 많은 메세지가
비주얼 베이직과 VBX 컨트롤
사이에서 정의되었기 때문에 결과적으로 VBX
컨트롤은 비주얼 베이직에서 가장
잘 운용될 수 있었다. 즉
비주얼 베이직외의 VBX 컨트롤을
이용할 수 있는 새로운 클라이언트 툴을 개발하는데 여러가지 문제점이
많았고 VBX 컨트롤을
개발하는데도 많은 어려움이 있었다.
VBX 컨트롤은 다중 플랫폼에서
사용되기에는 명세상 문제가 많았고 이를 마이크로소프트사에서도
인정했기에 OCX 컨트롤로
변경하게 되었다.
OCX컨트
롤
OCX 컨트롤
은
표준 인터페이스로서 OLE 인터페이스를
제공하여 다중 운영 체제와 다중 플랫폼에서 사용할 수 있도록 한
컨트롤이다. OLE 인터페이스는
마이크로소프트사에서 분산 객체 모델로 제시한 COM
모델을 일부 구현한 것이고 이를
윈도우 NT와
윈도우 95 운영
체제에서 지원하고 있기 때문이다.
윈도우 NT의
향후 버전에서는 완전한 네트웍 OLE가
구현될 것으로 예상된다. OCX
컨트롤은
클라이언트 툴과의 상호 통신을 OCX컨트롤의
메소드를 직접 호출하는 방법으로 처리한다.
즉 통신 기능에 객체개념을 추가하였다
.
- OCX의
구성 요소
각 클라이언트 툴은 OLE
인터페이스를 사용해 OCX
객체에 접근할 수 있다.
즉,
OLE인터페이스를 제공하는 모든
클라이언트 툴은 모든 OCX컨트롤들을
사용할 수 있다.
클라이언트 툴은 OCX의
각 메소드들을 호출함으로써 OCX
컨트롤로 하여금 특정 작업을
수행하도록 지시할 수 있다.
OCX 컨트롤
은
설정된 환경을 변경할 수 있는 프로퍼티를 제공한다.
OCX 컨트롤
에
특정 이벤트가 발생할 때마다 해당 컨트롤의 클라이언트에게 제어권을
넘겨줌으로써 클라이언트 툴로 하여금 특정 작업을 수행할 수 있게
한다.
1.5 CORBA 대
COM
앞서 미흡하나마 CORBA와 CORBA서비스 그리고 COM과 COM을 기반으로 하는 OLE에 대해서 살펴보았다. 이제 마지막으로 이 두 객체기술을 비교해 보도록 하겠다. 사족이지만 마이크로소프트 옹호론자들은 마이크로소프트가 가지고 있는 절대적인 지배력을 배경으로 하여 COM/OLE가 마지막 승리자가 될 것이라고 말하고 있다. 그러나 수백 개의 기업이 가입하여 객체표준 기술을 정의하고 이 표준을 준수하는 제품 개발을 권장하고 있는 OMG는 COM/OLE의 실제를 인정하고 공존의 길을 모색하고 있다. 과연 앞으로 이 전쟁이 어떻게 펼쳐질지는 아무도 모르지만 인터넷을 플랫폼으로 한 새로운 환경에서 더 이상 빌게이츠의 마이크로소프트가 모든 주도권을 행사하지는 못하고 있다. 왜냐하면 모든 컴퓨팅 환경이 빌게이츠의 윈도우는 아니기 때문이다. 결국 이 두 세계는 공존하게 될 것이다.
먼저 이 두 객체 기술의 비교를 위해
크게 몇가지 기준을 설정해 보도록 한다.
먼저 두 객체기술의 바탕인 객체의
모델을 기준으로 비교하고 객체 버스로서의 기능 ,
IDL에 의한 언어 매핑 기능
,
제공되는 시스템 서비스를 기준으로
살펴보도록 한다.
1.5.1 객
체
모델을 통한 비교
CORBA에서
지원하는 객체 모델은 객체 지향 기술에서 말하는 전통적인 객체이다.
따라서 이 객체는 내부에 데이타와
메소드로 갭슐화되어 있으며 단일한 인터페이스인 허가된 public메소드에
의해서만 내부에 접근할 수 있다.
또한 객체들의 기본 틀인 클래스들
사이의 상속 기능과 다형성 등 다양한 객체지향 기능을 제공한다.
또한 모든 객체는 유일한 식별자를
갖으며 객체에 접근시 이름을 이용한다.
이에 반해 COM
객체는 전통적인 객체가 아니다
.
먼저 상속을 통해 기존의 클래스를
확장할 수 없다. 따라서
OLE 컴포넌트의
재사용은 가능하나 이의 확장은 불가능하다.
또한 복수 개의 인터페이스를
제공함으로서 캡슐화의 강도가 많이 약화되었다.
다음 [표5-1]은
CORBA와
COM의
객체 모델을 비교 설명한 내용이다.
| 기 능 | CORBA | COM/OLE |
| 상속을 통한 확 장 | 가능 | 불가능 |
| 복수의 인터페이스 | 가능(상속기능) | 가능 |
| 외부와의 인터페이스 | 가능(Event서비스) | 가능(Aggregation기능 ) |
| GUID | 지원 | 지원 |
| 실시간시 유일한 객 체ID | 지원 | 지원 안함 |
| 재사용 | 지원(상속) | 지원(Containment,
Aggregation) |
| 지원 플랫폼 | 윈도우 , 맥킨토시 , OS/2 , 유닉스 , VMS | 윈도우 |
[ 표
5-1
] CORBA와 COM/OLE의
객체 모델 비교
1.5.2 객
체
버스로서의 기능 비교
객체 버스로서 CORBA와
COM/OLE을
비교하는 데 있어 가장 주요한 점은 원격지간의 객체 서비스 지원과
다양한 플랫폼을 지원하는가 하는 점이다.
왜냐하면 이 점에 따라 많은 기능이
좌우되기 때문이다. 예를
들어 , 원격지간의
객체 서비스를 지원한다면 이 서비스를 위해 원격지간의 이름 서비스,
객체ID변환
서비스 등을 수반해야 하기 때문이다.
다음은 이에 대한 기능들을 비교한
것이다. 참고로
COM은
인터페이스 정의시 ODL(Object
Definition Language)라는 메타
데이타를 정의할 수 있는 언어를 제공한다.
이 언어를 인터페이스의 타입
정보 등 다양한 메타 정보를 저장해 준다.
| 기 능 | CORBA | COM/OLE |
| 원격지간 객체 서 비스 | 지원 | 지원 안함 |
| 정적 메소드 호출 | 지원 | 지원 |
| 동적 메소드 호출 | 지원 | 지원 |
| 인터페이스 저장소 | 지원 | 지원 |
| 컴포넌트간 자료변환 | 지원(Stub-Skeleton) | 지원 |
| IDL | 지원(IDL만) | 지원(ODL과 MDL) |
| 구현 저장소 | 지원(구현 저장소) | 지원(레지스트리) |
[ 표
5-2
] CORBA와 COM/OLE의
객체 버스 비교
1.5.3 언
어
매핑 기능 비교
CORBA와
COM/OLE모두
응용 프로그램간의 호환을 기본으로 한다.
그러나 이를 위해 두 모델이 지원하는
방법에는 상당한 차이가 있다.
먼저 COM/OLE의
경우는 한마디로 마이크로소프트의 C++을
통한 윈도우 객체사이의 바이너리 호환을 지원한다라고 말할 수 있다.
왜냐하면 COM/OLE은
내부 인터페이스 접근시 마이크로소프트 C++컴파일러에서
사용하는 vtable의
구조를 사용하기 때문에 이를 통한 언어 매핑은 프로그래머나 다른
컴파일러 개발자의 책임이 된다.
또한 COM/OLE에서
제공하는 MIDL은
DCE IDL을
기반으로 하기 때문에 기본적으로 C만을
지원한다.
이에 반해 CORBA의
경우 개발언어 독립적인 응용 프로그램 개발을 위해 IDL
언어를 통해 다른 언어로의 변환을
지원한다. 현재
C , C++, 스몰톡을
지원중이며 이후 코볼, 에이다(Ada),
자바로의 변환을 추진중이다.
| 기능 | CORBA | COM/OLE |
| 바이너리 호환 | 지원 | 지원 |
| C 바인딩 | 지원 | 지원 |
| C++ 바인딩 | 지원 | 지원 안함 |
| 스몰톡 바인딩 | 지원 | 지원 안함 |
| 기타 Ada , COBOL, Java,.. | 지원예정 | 고려 없음 |
[ 표
5-3
] CORBA와 COM/OLE의
언어 매핑 기능 비교
1.5.4 시
스템
서비스 비교
CORBA와
COM/OLE는
객체 버스로서의 역할을 위해 다양한 서비스를 제공하고 있다.
그러나 이 두 모델은 서비스에서
많은 차이를 보이고 있다. 특히
CORBA의
경우 분산환경을 기본으로 하기 때문에 다양한 네트웍 관련 서비스가
포함되어 있으며 버전이나 객체 특성 등 순수한 객체 지향 개념을
지원하기 위한 여러 서비스들이 제공된다.
이에 반해 COM/OLE은
윈도우 객체 모델을 기반으로 하기 때문에 제공되는 서비스도 이에
의존하고 있다. 다음
[표
5-4]는
이러한 서비스들에 대한 비교표이다.
| 기능 | CORBA | COM/OLE |
| 이벤트 | 지원 | 지원 |
| 생명주기 | 지원 | 지원 |
| 이름 | 지원 | 지원 |
| 지속성 | 지원 | 지원(모니커 이용 ) |
| ODBMS통합 | 지원 | 지원 안함 |
| RDBMS통합 | 지원 | 지원예정(OLE DB) |
| 외형화(Externalization) | 지원 | 지원 |
| 트렌젝션 | 지원 | 지원예정(OLE트렌젝션 ) |
| 동시성 제어 | 지원 | 지원 안함 |
| 객체간 관계 | 지원 | 지원 안함 |
| 질의 | 지원 | 지원예정(OLE DB) |
| 라이센싱 | 지원 | 지원 |
| 객체 특성 | 지원 | 지원 |
| 버전 | 지원(변화관리기능 ) | 지원 안함 |
| 보안 | 지원 | 지원 안함 |
| 객체 자동 제거 | 지원(참조 카 운트) | 지원(참조 카 운트) |
[ 표
5-4
] CORBA와 COM/OLE의
서비스 비교
1.6 CORBA와
COM/OLE의
현 상태
현재 마이크로소프트가 CORBA
표준을 지원할 것이라는 징조는
그 어디에도 보이지 않는있다.
그러나 CORBA
표준에서는 COM
객체와의 표준을 위해 많은 할애를
하고 있다. 상식적으로
마이크로소프트의 윈도우 객체가 차지하고 있는 부분을 무시할 수는
없기 때문일 것이다. 이를
위해 OMG는
크게 2가지
부분으로 나누어 COM과
결합을 준비하고 있다. 첫번째
부분은 현재 COM과의
통합을 위한 기술적 표준을 제정하고 있는 상태이며 두번째 부분은
앞으로 예견되는 분산COM과의
호환을 위한 표준을 준비 중에 있다.
그렇다면 좀 더 구체적으로 OMG에 의해서 진행되고 있는 일들을 살펴보면서 CORBA-COM결합을 위한 구체적 방법들에 대해 살펴보자.
CORBA-COM 호환에
관한 모든 사항에 대한 문서편집 작업은 사이베이스사에서 주관하고
있으며 CORBA2.0과
COM(OLE lib version 2.03)과의
인터네트워킹을 엑스퍼소프트사에서 ,
CORBA-COM매핑을 DEC와
비주얼엣지사에서 ,
CORBA-OLE오토메이션을
아이오나에서 진행하고 있다.
이러한 모든 작업의 공동의 목표는
어떤 객체 모델이나 표준에 인위적인 변화를 가하지 않고 투명한 방법으로
CORBA객체와
호환시키자는 것이다. CORBA-COM
호환은 프로그래머에게 많은 기능과
가능성을 주고 있다. 예를
들면, 현재
상용화된 CORBA-OLE 오토메이션
기능을 이용하고 있는 프로그래머는 분산OLE기능을
실제 구현할 수 있으며 윈도우 데스크탑에서 유닉스를 포함한 이종의
시스템에서 얻은 데이타를 가공하여 표현할 수 있다.
1.7 CORBA-COM 통합
방법
1.7.1 어
떤
통합 방법으로 출발할 것인가?
실제 CORBA는
웍스테이션이나 기타 중형 서버급 환경에서 강세를 보이고 있다.
그러나 윈도우라는 그림 운영
체제로 클라이언트 시장에 군림하고 있는 마이크로소프트로 인해 클라이언트
시장에서는 아직 확실한 자리를 잡지 못하고 있는 실정이다.
다시 말해 COM/OLE는
윈도우 객체들의 대표이고 CORBA는
기타 다른 객체들의 대표인 상황이다.그러나
아직 마이크로소프트의 경우 그들 기술의 핵심인 COM/OLE가
아직 네트웍 환경을 지원하지 못하기 때문에 많은 CORBA제품들이
윈도우를 주요 공략 대상으로 삼고 있다.
이러한 상황으로 판단하건데 분산
객체 기술 측면에서 CORBA가
COM/OLE보다
수 년은 앞서 있는 것이 분명하다.
이러한 배경하에서 통합 시스템을
구축하려는 기업 입장에서 보면 어떤 기술을 주요 기반 기술로 삼을
것인지 결정해야 한다. 만약
앞으로 나올 네트웍 COM/OLE를
이용하려면 모든 환경을 윈도우로 통일하거나 여러 다른 시스템과
네트웍 COM/OLE응용
시스템을 연동시키기 위한 방법을 찾아야 할 것이다.
그러나 현재 CORBA기술을
이용한다면 현재의 COM/OLE기술과의
연동과 앞으로 나올 네트웍 COM/OLE기술과의
연동에 대한 방법을 찾아야 한다.
다행히도 CORBA표준을
주도하고 있는 OMG에서
CORBA를
근간으로 하고 COM/OLE기술을
통합하기 위한 노력들을 경주하고 있으며 그 결과 COM/OLE와
CORBA의
연동 기술이 여러 개발 업체에 의해서 개발되었으며 앞으로 나올 네트웍
COM/OLE와
CORBA와의
연동을 위해 준비 중에 있다. 특히
이러한 접근 방법은 대규모의 컴퓨팅 환경과 다양한 운영 체제 및
응용 프로그램을 사용하고 있는 환경에 가장 적합하다고 말할 수 있다.
또 하나 CORBA와
COM/OLE를
통합함으로서 현재의 COM/OLE에
네트웍 기술을 불어 넣을 수 있으며 COM/OLE를
통해 유닉스 등 다양한 환경하에서 윈도우 객체를 이용할 수 있다는
효과를 얻을 수 있다.
1.7.2 COM/OLE와
연동하기 위한 OMG의
노력들
COM/OLE와
CORBA를
통합하기 위한 노력은 OMG에
의해서 주도되고 있다. 실제
OMG는
비영리 회사로서 분산 객체 표준인 CORBA의
표준을 주도하고 있으며 수 백 개의 유수한 기업들이 여기에 가입하여
활동하고 있다. 이
활동 중 공식적인 COM/OLE와
CORBA를
통합하기 위한 활동 명칭은 COM-CORBA
Interworking 이다.
이 활동은 1995년
4월
시작되었는데 크게 Part A와
Part B로
구분되어 활동하고 있다. 이
활동의 기본적인 목적은 COM/OLE와
CORBA의
객체 모델에 변화를 가하지 않고 상호 연동하게 만드는 것이다.
각 부분에서 하는 일을 살펴보면 먼저
Part A에서는
기존의 COM과
CORBA사이의
상호 연동을 위한 방법을 위해 활동하고 있으며 현재 대부분의 연동
방법이 제안되었고 많은 회사에서 이 방법을 지원하고 있다.
현재 목표는 CORBA2.0
과 OLE
라이브러리 버전 2.03사이의
연동 방안과 양방향 통신을 목표로 하고 있다.
다음은 Part A에 참여하고 있는 회사들과 이들의 역할들이다.
참여회사 : Digital Equipment Corporation -> COM-CORBA 매핑 기술
Expersoft Corporation -> 상호 연동 구조
FUJITSU LIMITED
Hewlett-Packard Company
Genesis Development Corporation -> OLE Automation과 CORBA연동
International Business Machine Corporation
IONA Technologies,Ltd -> OLE Automation과 CORBA연동
Simens Nixdorf Information System AG
SunSoft, Inc
Sybase, Inc -> 전반적 인 문서작업
Visual
Edge Software, Ltd -> COM-CORBA 매핑
기술
Part B에서는
COM의
네트웍 버전과 CORBA사이의
상호 연동을 위한 방법에 대해 연구하고 있다.
현재 Part
B의 활동에 참여하고 있는 기업으로는
아래와 같다.
투표 가능한 참여 기업들:
APM, AT&T, BNR, Bull, CI Labs, Data Access, Defense Information
Systems Agency, Digital, Expersoft, Fujitsu, GPT Ltd., Genesis,
Gensym , Hewlett-Packard, HyperDesk, ICL, IONA, Informix, International
Business Machines, MITRE, Micro Focus, Microsoft , NEC, NIIIP,
NSA, Nokia, Novell, OGIS, OSF, Objective Interface Systems, Objectivity,
Odyssey, Olivetti, Oracle, POSC, Protocol Systems , Raytheon,
Rogue Wave Software, SNI, Santz Cruz Operations, SunSoft, Sybase,
Taligent, Tandem, Tivoli, Unisys, Univ. Michigan, Visual Edge
1.7.3 COM/OLE와의
연동 방법
1.7.3.1 COM/OLE - CORBA연동
시 지원해야 하는 필수 기능들
바로 본론에 들어가기에 앞서 COM/OLE와 CORBA를 통합하는 데 있어 지원해야 하는 기본적인 기능들을 정리해 보자.
COM 객체와 CORBA객체는 고유한 메소드 호출 방식을 가지고 있다. 그러나 COM/OLE-CORBA연동시에는 COM/OLE객체가 CORBA의 메소드를 호출할 수 있어야 하며 반대로 CORBA객체가 COM/OLE의 메소드를 호출할 수 있어야 한다. 이러한 기능을 지원하기 위한 모델로는 각각의 객체에 메소드 호출을 수행하는 대리 객체로서 프록시 객체를 만들 수 있다. 예를 들면, CORBA 프록시 객체의 경우 OLE의 IUnknown 인터페이스를 이용하며 COM/OLE프록시의 경우 CORBA의 동적 호출이나 정적 호출 그리고 구현 저장소 등을 이용할 줄 알면 상대방의 메소드를 호출할 수 있는 정보를 준비한 셈이다.
COM/OLE에
서
사용하는 데이타 타입과 CORBA에서의
데이타 타입은 서로 간에 매핑되야한다.
실제 이 경우 숫자같은 기본적인
타입은 별문제를 일으키지 않지만 CORBA의
any
타입과
OLE의
Variant타입사이의
변환은 많은 기술을 요구한다.
CORBA의
응용 프로그램 작성 언어는 IDL이다.
마찬가지로 COM은
MIDL(Microsoft IDL), OLE의
경우 ODL을
사용하여 인터페이스를 작성한다.
따라서 이들 IDL언어들
사이의 매핑은 필수적이다. 특히
CORBA IDL경우
복수 상속을 지원하기 때문에 복수 상속 개념이 없는 MIDL과
ODL에서
이들 관계를 표현할 수 있는 방법들이 고안되야 한다.
CORBA에서
의
예외 상황 처리와 COM/OLE는
예외 상황 처리시 그 방법이 다르다.
따라서 각자 발생한 예외 상황을
다른 쪽으로 전달하여 적절하게 대처하게 하는 방법이 필요하다.
CORBA의
경우 객체의 생성과 소멸이 사용자나 서버 프로그램에 의해서 자유롭게
이루어진다. 그러나
COM/OLE의
경우 팩토리(Factory)라는
클래스를 통해 객체를 생성하며 객체에 대한 참조 변수에 의해서 객체를
소멸한다. 따라서
서로 간의 객체를 생성시키고 소멸시킬 수 있는 일관적인 방법이 지원돼야
한다.
COM/OLE객 체의 모든 정보는 레지스트리라는 윈도우 정보 저장소에 저장된다. 이에 반해 CORBA객체의 경우 구현 저장소와 인터페이스 저장소에 모든 정보가 저장된다. 따라서 CORBA와 COM/OLE의 상호 연동시 서로 간의 객체를 레지스트리와 구현 저장소, 인터페이스 저장소에 저장하기 위한 방법이 필요하다.
1.7.3.2 COM/OLE-CORBA 상호
연동 원칙과 구조
앞서도 언급했지만 COM/OLE와
CORBA사이의
연동시 다음의 사안을 구조상의 목표로 하고 있다.
이러한 목표를 지원하기 위해 현재 사용되고
있는 방법은 양방향 변환이 가능한 게이트웨이를 작성하는 것이다.(
혹자는 이를 브리지라고도 한다
.)
먼저 게이트웨이를 통해 COM/OLE객체가
CORBA구현
객체를 호출하는 과정을 정리해보자.
이 과정은 연이어 설명되는 많은
통합 기능을 이해하는데 필요한 밑거름이 될 것이다.
최초 OLE객체는
CORBA구현
객체를 호출하기 위해 프록시 객체의 IUnknown과
IDispatch를
통해 CORBA구현
객체를 호출한다. 이때
게이트웨이는 이 호출을 CORBA에서
호출가능하도록 변환해준다. 변환된
호출은 CORBA의
동적 호출 방법을 사용하여 해당 CORBA
서버객체에게 전달된다.
이 과정에서 필요한 프록시 객체와
변환 기능은 게이트웨이에서 제공해야 한다.
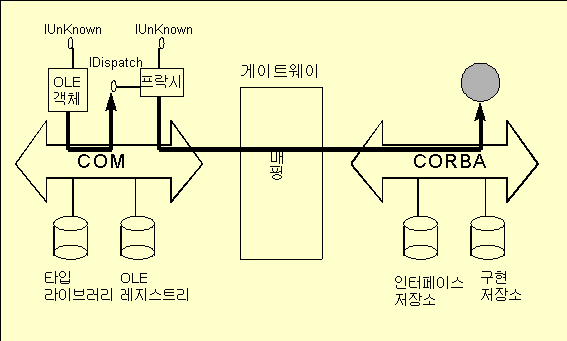
[ 그림
5-15
] OLE클라이언트에서 CORBA
구현 객체로의 호출
앞선 경우와 반대로 CORBA클라이언트
객체에서 OLE서버를
호출하는 과정을 생각해보자.
CORBA클라이언트는 COM/OLE서버의
존재에 무관하게 해당 서버에 대한 호출을 요청한다.
이 요청은 CORBA2.0명세에서
제안된 동적 스켈로턴 인터페이스를 통해 로컬 또는 리모트에 존재하는
COM 구현
객체에게 전달된다. 이
과정에서 COM/OLE서비스를
이용하기 위해 CORBA요청은
COM/OLE요청으로
변환되며 결국 COM을
통해 해당 OLE서버의
IDispatch를
사용하여 원하는 메소드를 호출할 수 있게 되는 것이다.
이 과정에서 필요한 모든 작업은
게이트웨이가 담당하며 모든 복잡한 기능은 사용자에게 가려진다.
따라서 사용자는 해당 서버가
CORBA이든
COM/OLE이든
상관없이 원하는 서비스를 이용할 수 있다.
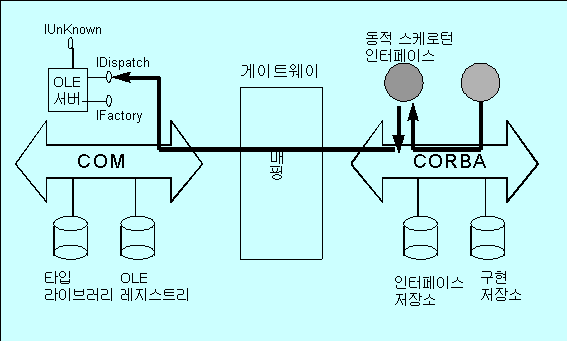
[
그림5-16
] CORBA클라이언트에서 OLE서버로의
호출
1.7.3.3 COM/OLE-CORBA 연동
기술
1.7.3.3.1 COM/OLE-CORBA 상호
호환 객체 모델 이해
CORBA와
COM/OLE는
공통적으로 객체지향 기술을 지원하다는 측면에서 일정 정도 공통점을
갖고 있다. 그러나
CORBA가
순수 객체지향 기술을 지원한다면 COM/OLE는
순수 객체지향 기술 중 일정 부분만을 지원하고 있다.
가령,
CORBA의 경우 단일 상속과 다중
상속 모두를 지원하는 데 반해 COM/OLE의
경우 상속보다는 에그리게이션(Aggregation)이라는
개념만을 지원하고 있다. 다음은
이 두 모델들에서 제공하는 기능들에 대한 비교이다.(
CORBA와 COM의
자세한 비교는 앞 장을 참조하기 바란다.
)
| CORBA | COM | OLE 오토메이션 | |
| 인터페이스 | IDL로 작성되며 그 정보가 인터페이스 저장소에 저장된다 . 다중 상속등 각종 객체지향 기능을 지원한다. | MIDL로 작성되며 에그리게이션을 지원한다. | ODL로 작성되며 TypeLib라는 곳에 정보가 저 장된다. |
| 매개변수 | 기본 데이타 타 입, 객체 참조자, 사용자 정의 타입 | 기본 데이타 타 입, 객체 참조자, 사용자 정의 타입 | 기본 데이타 타 입, 객체 참조자, 배열 |
| 객체 참조자 | 특정 방식으로 선 언됨 | C++의 vtbl이라는 함수 테이블에 대한 포 인터 | C++의 vtbl이라는 함수 테이블에 대한 포 인터 |
| 서버 호출 방법 | 정적,동적 모 두 가능하며 ORB에 의해서 관장된다. | vtbl을 통해 호출되며 프록시와 스터브로 이루어져 있 다. | 실시간 인터프리터를 통 해 호출한다. |
[
표5-5
] COM/OLE/CORBA 객체 모델 비교
앞서 살펴본 것처럼 COM/OLE와
CORBA의
객체 모델이 다르다 하더라도 이들의 상호 연동을 위한 게이트웨이는
이들의 차이점에 무관하게 이용할 수 있어야 한다.
따라서 두 객체 모델은 다음처럼
상호 연동돼야 한다.
먼저 한 객체A가 다른 객체B를 호출하기 위해서는 해당 객체에 대한 객체 참조자를 얻어야 한다. 이를 위해 객체A는 객체B을 일반적인 호출 방법을 사용하여 참조한다. 이때 이 참조는 게이트웨이를 통해 해당 객체B에게 전달되고 게이트웨이는 객체B의 객체 참조자를 객체A에게 제공해준다. 객체A는 객체B의 모델에 상관없이 상호 연동할 수 있다.
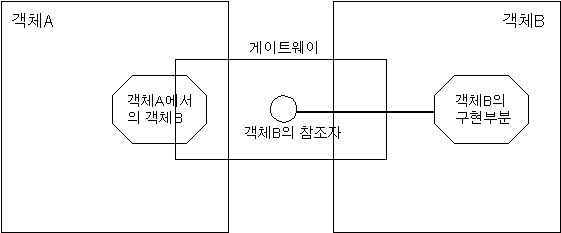
[
그림5-17
] COM/OLE-CORBA 객체간 상호
연동 모델
1.7.3.3.2 COM/OLE-CORBA 상호
연동 구조
앞선 객체 모델에 근거하여 COM/OLE와
CORBA사이에서는
[그
림5-18]와
[그
림5-19]처럼
상호 연동이 가능하다. [그림5-18]의
경우 로컬 컴퓨터상에서 네트웍을 경유하지 않고 상호 연동시 발생하는
과정을 묘사한 것이다. 이에
반해 [그림5-19]의
경우는 TCP/IP네트웍상에서
IIOP를
통한 상호연동 과정을 의미한다.
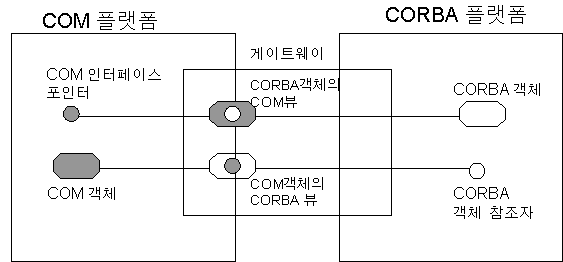
[
그림5-18
] 로컬 컴퓨터에서 COM/OLE
- CORBA 객체 상호연동 구조
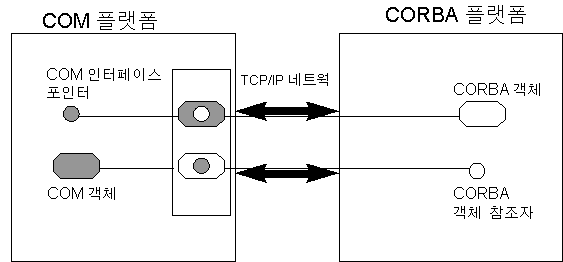
[
그림5-19
] 네트웍상에서 COM/OLE
- CORBA 객체 상호연동 구조
실제 COM과
OLE, CORBA모두
다른 인터페이스를 가지고 있다.
먼저 OLE는
메소들의 집합으로서 이 집합의 대표 포인터를 통해 원하는 메소드를
이용한다. 또한
COM은
상속보다는 에그리게이션을 지원한다.
마지막으로 CORBA의
경우 다중 상속을 바탕으로 인터페이스의 상속 기능을 중시하는 특징을
가지고 있다. 이러한
상황에서 이들 인터페이스 사이의 매핑은 지원돼야 한다.
CORBA IDL
의
상속 기능은 COM MIDL로
1:1 매핑된다.
이 때 메소드 실행시 필요한 순서등은
명시돼야 한다. 이에
반해COM MIDL인터페이스들을
CORBA IDL상의
인터페이스들도 단일하게 변환할 수 없다.
따라서 CORBA
IDL상의 복합객체 개념(다른
인터페이스를 한 인터페이스의 타입으로 사용)을
이용하여 변환한다.
OLE 상에
메소드들은 순서를 가지고 있지 않다.
따라서 CORBA
메소드들은 하나의 OLE
오토메이션 인터페이스로 변환할
수 있다. 이
때 오토메이션 인터페이스는 두가지 측면에서 CORBA
IDL을 매핑한다.
하나는 모든 메소드들을 단일한
vtbl로
매핑시키는 것이고 다른 하나는 메소드들의 순서나 인터페이스들의
순서를 미리 결정해 놓는 것이다.
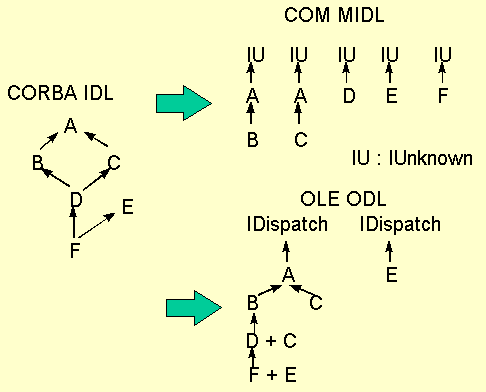
[ 그림
5-20 ] CORBA IDL에서
COM/OLE로의
변환
객체의 생성에서 소멸로 이어지는 과정
역시 COM/OLE와
CORBA는
각기 다르다. COM/OLE의
경우 본래 객체의 생성은 Factories클래스에
의해서 생성되며 일시적으로 사용되어 지는 특징을 가지고 있다.
또한 COM/OLE의
객체 참조 카운팅 방법은 분산 환경의 규모가 커질수록 많은 문제점을
야기시킨다. 이에
반해 CORBA는
C
나
C++등에서
사용하던 전통적인 객체 생성 방법을 사용하며 Factories클래스를
통한 객체 생성은 factory기능을
제공하는 클래스에 원하는 객체를 등록한 후 사용할 수 있다.
이러한 차이를 극복하기 위한 제안된
방법으로는 COM/OLE측에
CosLifeCycle :: LifeCycleObject
라는 인터페이스를 두고 이 인터페이스에
CORBA객체
참조자를 추가하고 삭제하는 기능을 제공하여 CORBA객체의
라이프사이클을 관리하는 방법 등을 들 수 있다.
CORBA의 객체 참조자를 저장하고 COM측면에서 조작할 수 있도록 해주는 IMonikerProvider 인터페이스와 COM클라이언트가 CORBA객체를 생성할 수 있도록 해주는 ICORBAFactory 인터페이스 등 각종 인터페이스들이 COM/OLE와 CORBA사이의 상호 연동을 위해 제안되고 있다.
1.8 COM/OLE-CORBA연동
제품들
1.8.1 이
용
가능한 제품들
현재 CORBA제품을
제공하고 있는 많은 회사들이 COM/OLE-CORBA연동
기능을 제공하고 있으며 제공할 예정에 있다.
현재 양 방향 게이트웨이를 제공하고
있는 제품들로는 디지탈의 ObjectBroker와
IBM의
SOMobjects for Windows, 엑스퍼소프트의
COM/CORBA/OLE , 아이오나의
Orbix-OLE등이
있다. 또한
CORBA제품
외에 비주얼 에지(Visual
Edge)사와
캔들사에서 제공하는 COM/CORBA툴킷을
이용할 수도 있다. 다음은
이들 제품들과 툴킷에 대한 정보를 얻을 수 있는 WWW
URL이다.
이들 제품외에 여러 제품들이
COM/OLE 연동을
지원하고 있다. 보다
자세한 정보는 6막을
참조하기 바란다.
http://www2.service.digital.com/ddi/html/ObjectBroker-V2.5.html
http://www.digital.com/info/objectbroker/obb.htm
http://www.software.ibm.com
http://www.expersoft.com
http://www.iona.com
http://www.visual-edge.com/
http://www.candle.com
1.8.2 Orbix-OLE를
통한 CORBA-OLE
연동
방법 고찰
앞서 소개한 제품중 Orbix-OLE를
통해 CORBA와
OLE의
연동 방법에 대해 살펴본다.Orbix-OLE는
아이오나에서 개발한 CORBA제품인
Orbix의
OLE 연동버전이다.
따라서 Orbix-OLE는
Orbix 클라이언트이자
OLE서버
역할을 하는 응용서버를 개발해준다.
따라서 윈도우 응용 프로그램은
손쉽게 OLE오토메이션
서버를 통해 CORBA서버의
메소드를 이용할 수 있게 해준다.
- Orbix-OLE 프로그램
작성 과정 이해
Orbix-OLE는 다음 [그림5-21]과 같은 과정을 통해 Orbix-OLE 응용 프로그램을 작성하게 해준다. 먼저 사용자는 CORBA IDL을 사용하여 원하는 응용 프로그램을 작성한다.
일단 작성된 프로그램은 Orbix-OLE
IDL컴파일러에 의해서 CORBA서버용
프로그램과 OLE 오토메이션
서버 겸 Orbix 클라이언트
코드를 생성해 준다. 생성된
코드에는 OLE서버를
통해 제출된 메소드 호출을 CORBA서버에게
전달해주고 서버에서 수행된 메소드의 결과를 다시 OLE서버에게
전해주는 등 각종 OLE-CORBA
게이트웨이
역할을 수행한다. 또하나
중요한 점은 Orbix-OLE IDL컴파일
과정에서 OLE를
위한 타입정보가 OLE타입
라이브러리에 저장된다는 점이다.
결국 사용자는 나머지 부분에 대한 로직을
구현하고 이를 OLE서버로
생성한 후 비주얼 베이직들 기타 OLE응용
프로그램 작성 툴을 사용하여 윈도우상에서 손쉽게 원하는 CORBA서버를
이용할 수 있다.
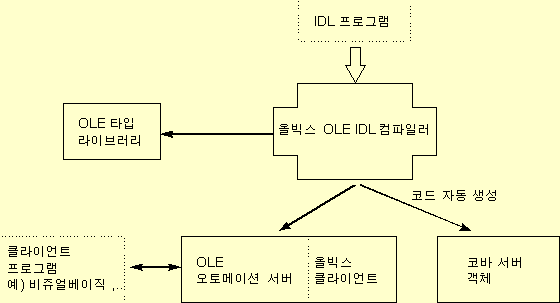
[
그림5-21
] Orbix-OLE 개발환경
- Orbix-OLE 게이트웨이의
경로 이해
앞서 계속 살펴본 것처럼 윈도우 응용
프로그램과 CORBA 서버
사이의 상호 연동을 위해서는 게이트웨이 역할을 하는 부분이 필요하다.
바로 이 부분이 OLE오토메이션
서버이자 Orbix 클라이언트이다.
실제 이 부분은 게이트웨이로서
많은 역할을 하겠지만 사용자의 입장에서 보면 걱정할 필요가 없다.
왜냐하면 Orbix-OLE
IDL컴파일러가 자동적으로 이
부분에 필요한 코드를 제공하기 때문이다.
다음 [그림5-22]는
게이트웨이를 경유하여 OLE클라이언트에서
CORBA구현
객체까지의 경로를 나타난 것이다.
먼저 비주얼 베이직같은 응용
프로그램 작성 도구를 이용하여 작성된 OLE클라이언트
프로그램은 게이트웨이의 일부인 OLE
오토메이션 서버를 이용하여 원하는
메소드들을 호출하여 작업을 수행한다.
이 때 호출된 메소드는 게이트웨이의
또 다른 측면인 Orbix 클라이언트로서
해당CORBA서버에게
전달된다. 전달된
메소드는 CORBA서버상에서
수행되고 이 결과는 다시 역순으로 OLE클라이언트
프로그램에게 전달된다.
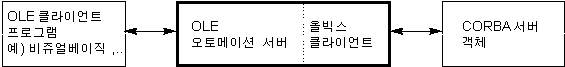
[
그림5-22
] OLE클라이언트에서 CORBA서버까지의
접근 경로
좀 더 자세히 이 과정을 살펴보면 OLE
클라이언트 프로그램에서 호출된
메소드는 게이트웨이 부분에서 OLE
프록시 객체를 통해 CORBA객체에게
전달된다. 바꾸어
말하면 일단 사용자는 원하는 메소드를 호출하기 위해 해당 CORBA
객체에 대한 참조자를 얻어야
한다. 이때
CORBA객체는
로컬 컴퓨터에 있을 수도 있고 네트웍상의 다른 컴퓨터에 위치할 수도
있다. 이
객체에 대한 참조자를 얻기 위해 사용자는 로컬 컴퓨터상에 OLE
프록시 객체를 생성해야 한다
.
이 프록시 서버는 실제 CORBA객체를
대표하는 객체로서 각종 상호 연동 기능을 제공한다.
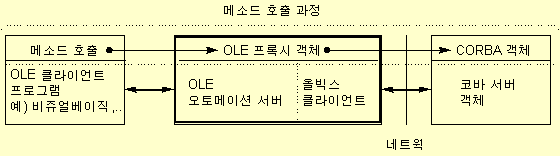
[
그림5-23
] 네트웍상에서 OLE
메소드 호출 과정
- 간단한
Orbix-OLE 프로그램
작성 예
다음은 간단한 Orbix-OLE
응용 프로그램을 작성하는 과정을
통해 지금까지 살펴본 내용을 정리해 보도록 한다.
단계1) IDL파일 작성
먼저 원하는 프로그램을 IDL을
통해 작성한다. 다음은
전형적인 bank 응용
프로그램의 IDL 이다.
// bankSrv.idl
interface bank {
exception reject { string reason; };
account newAccount{ in string owner} raises(reject);
void deleteAccount(in account a);
}
단계2) 컴파일
일단 작성된 bankSrv.idl을 컴파일한다.
C:> idl -wem bankSrv.idl
-wem은
OLE2에
바인딩하기 위한 코드와 각종 메이크 파일(Makefile)과
코드들을 생성해내는 옵션이다.
이 과정에서 중요한 것은 IDL코드가
OLE와
CORBA를
연동시키기 위한 코드를 생성하는 과정에서 필요한 정보를 제공하는
것이다. 가령,
OLE에서 사용하는 UUID등이
그것이다. 다음은
앞선 예에서 사용하기 위한 조정 파일이다.
조정 파일은 .ole라는
확장자로 끝나며 파일 이름은 IDL파일에서
선언된 베이스 인터페이스와 동일해야 한다.
예를 들어,
앞선 예의 조정 파일은 bank.ole이다
.
# OLE configuration
# bank.old
ServerName = BankSrv
BaseUUID =
E5ABFA40-8C94-101C-AD9B-0020AF51E7E2
단계3) 클라이언트 프로그램 작성
단계2)에서
IDL컴파일러는
bankSrv.mak라는
메이크 파일을 비롯하여 각종 코드를 제공해준다.
이때 사용자는 서버 파일에 원하는
코드를 작성해야 한다. 일단
서버 파일에 account newAccount{
in string owner} raises(reject)와
void deleteAccount(in account
a)를 구현했다고 가정하자.
서버측의 작성이 끝난 후 이젠
OLE클라이언트를
작성해야 한다.
일단 OLE클라이언트
프로그램은 비주얼 베이직같이 손쉽게 사용할 수 있는 것을 이용하는
것이 편리하다. 원하는
클라이언트의 화면을 비주얼 베이직으로 다음과 같이 디자인한다고
하자.
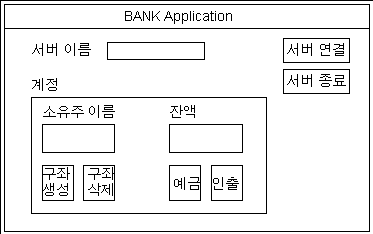
사용자는 디자인한 화면에 맞게 서버에
연결 또는 연결해제, 그리고
계정 생성 및 삭제, 예금,
인출 등의 컨트롤을 작성해야
한다. 모든
비주얼 베이직 컨트롤을 다 작성하는 과정을 소개하기는 어렵지만
좀 더 깊은 이해를 위해 서버에 연결하는 과정에 필요한 코드를 소개한다.
connect_button_Click()은
서버연결 버튼 클릭시 서버로의 연결을 시도한다.
다시 말해 네트웍을 경유하여
윈도우 객체가 CORBA서버로의
접근을 시도하는 것이다. 이
과정에서 사용자는 Orbix 프록시가
제공하는 CreateObjects()함수를
이용하여 원하는 서버로의 접근을 시도한다.
일단 CreateObjects()를
통해 원하는 Orbix 서버에
대한 프록시를 생성하고 이 프록시의 IT_Bind()
또는 IT_BindHost()를
통해 원하는 하는 서버에 연결한다.
Sub connect_button_Click()
Set b = CreateObject("BankSrv.bank")
If host_name.Text = "" Then
b.IT_Bind
Else
b.IT_BindHost(host_name.Text)
End If
disconnect_button.Enables = True
connect_button.Enabled = False
new_acc_button.Enabled = True
End Sub
단계4) 프로그램 실행
모든 프로그램의 작성이 끝나면 해당
서버의 컴퓨터상에서 Orbix 데몬과
서버 프로그램을 수행시켜 놓은 후 작성한 클라이언트를 수행하면
원하는 작업을 수행할 수 있다.
지금까지 COM/OLE와
CORBA를
연동하는 방법에 대해 살펴보았다.
현재 이 기술은 시스템 통합시
가장 필요한 기술중 하나로 손꼽히고 있다.
분명 그 이유는 COM/OLE객체에
CORBA라는
잘 디자인된 소프트웨어 버스를 사용함으로서 그 간 많은 응용 분야에서
필요로 하는 분산OLE가
가능하기 때문이라고 생각한다.
그러나 남은 숙제는 분산COM/네트웍
OLE의
실제 모습이다. 아직까지
정확한 제품이 제공되지 않아 단정하긴 힘들지만 기존의 COM/OLE의
한계를 극복하기 위한 많은 노력이 구체화될 것임이 분명하다.
그러나 재미난 사실하나는 이미
OS/2 , 매킨토시
등에서 컴포넌트 객체표준으로 사용되고 있는 OpenDoc이다
.
사실 OLE의
가장 큰 적수는 CORBA보다는
OpenDoc이다.
왜냐하면 OpenDoc은CORBA기반의
컴포넌트 객체를 위한 윈도우 기술이기 때문이다.
따라서 엄밀한 등식으로는 COM/OLE
대 CORBA/OpenDoc의
기술 전쟁이라고 말해야 옳다.
왜냐하면 OLE가
COM을
그 하부구조로 삼는데 반해 OpenDoc은
CORBA를
하부구조로 사용하기 때문이다.
과연 이 전쟁의 승리자가 누구인지에
대해서는 단언하기 힘들지만 마이크로소프트의 COM/OLE가
예전의 다른 분야에서 처럼 원하는 대로 완승을 거두지는 못하리라
생각한다. 왜냐하면
CORBA의
분산기술이 COM/OLE의
기술보다 상당히 앞서있다고 평가되기 때문이다.
2장
인터넷 매니어의 희망,
WWW
현재 컴퓨터를 사용하는 대다수의 사람들에게
가장 중요하고 앞으로 우리의 생활에 가장 많은 영향을 미칠 컴퓨터의
분야를 찾으라고 묻는다면 십중팔구,
인터넷이라고 말할 것이다.
아마도 그렇게 대답하는 이유는
인터넷이 주는 수많은 정보와 가능성에 있다고 말할 수 있다.
수많은 일반 사용자들은 인터넷이
제공하는 무궁무진한 반쯤 살아 있는 정보를 얻기 위해 동분서주하고
있으며 수많은 프로그래머들은 자신이 가지고 있던 기술과 아이디어를
인터넷상에 펼쳐 보기 위해 노력하고 있다.
그러나 실제 인터넷을 가장 적극적으로
활용하고 개발하고 있는 부문은 일반 사용자들에서 기업이나 단체
사용자들쪽으로 옮겨 가고 있다고 말할 수 있다.
왜냐하면 더 이상 인터넷은 불특정
다수를 지향하는 공공 서비스가 아니라 특정 단체나 기관등에서 자신들의
정보 시스템을 보다 진보적으로 활용하기 위한 마당으로 자리 잡혀가고
있기 때문이다. 이러한
움직임을 흔히들 "인트라넷"이라고 부른다.
이러한 "인트라넷"상황에서
가장 중요한 요소 중 하나가 이종의 환경을 하나의 어항안에 몰아넣는
것이다. 서로
다른 응용 프로그램들과 데이타베이스,
기타 여러 정보 자원을 하나의
어항안에 넣고 서로들 인터넷(
좀 더 정확히 말하자면 인터넷
프로토콜 , TCP/IP )을
통해 원활히 정보를 공유하는 것이다.
이 때 인터넷은 정보의 교환을
위한 프로토콜로서 , CORBA는
서로 다른 형태의 정보 자원을 담아내는 어항으로서 힘을 발한다고
말할 수 있다. 이번
장에는 이 두 기술이 합쳐지는 과정과 그 방법,
그리고 각종 이득에 대해서 알아보도록
한다.
2.I 배경
이해
2.1.1새로
운
시대의 새로운 요구 사항들
현재 기업이나 기타 조직이 당면한 여러
컴퓨팅 상황 중 가장 두드러진 부분은 이종의 시스템을 통합.재조정하기
위한 기술과 인터넷을 필두로 한 네트웍 환경이다.
또 하나 추가할 수 있는 부분은
멀티미디어 컨턴트 정보라고 말할 수 있다.
이러한 환경에서 기존의 정보관리
시스템은 그 목표를 새롭게 수정해야만 한다.
다음은 이러한 환경에서 정보관리
시스템이 가져야 할 목표이다.
"정보관리 시스템은 조직이나 기관의
정보처리 과정과 경영 철학을 지원함에 있어 지리적으로 분산되고
이종인 정보 자원을 보다 쉽고 ,
안정되고,
일관된 방법으로 관리해야 한다
."
위의 목표는 현재,
그리고 앞으로 구축해야 할 시스템들이
지향해야 할 필수 목표라 말할 수 있다.
실제 이러한 목표를 지향하는
시스템들이 갖추어야 할 요구 사항들은 다음과 같다.
2.1.2
현재의
상황은 ?
자!
우리가 구축해야 할 시스템의
목표와 요구 사항들을 살펴보았다면 이제 할 일은 현재 우리의 시스템을
냉정히 살펴보는 것이다. 다음은
현재 우리가 당면한 현실 상황들이다.
2.1.3.
해결책은?
현재 우리의 시스템이 당면한 상황과
앞으로 우리가 지향해야 할 시스템의 목표를 살펴보았다.
그렇다면 과연 어떤 방법을 사용하여
다면한 상황을 돌파하고 우리가 원하는 목표 시스템을 구축할 수 있을
지 살펴보자.
초기 대부분의 시스템 구축가들은 중앙에
원하는 작업을 수행하는 서버를 중심으로 하고 이에 각종 더미 터미날을
추가하여 시스템을 구축하였다.
이러한 방법은 서버에 집중되는
일의 부하와 가격 경쟁력, 타
시스템과의 연동 등 많은 문제점들을 내포하고 있다.
현재 구축되는 대부분의 시스템에서 사용하는
방법으로 시스템간의 개별적인 인터페이스를 통해 원하는 시스템들을
묶어내는 기술을 말한다. 또한
개별적인 인터페이스를 만드는 데서 발생하는 문제점들을 피하고자
나온 기술이 바로 미들웨어라는 소프트웨어 연동 기술이다.
인터넷 검색엔진이나 비서 프로그램처럼
특정 도메인 분야에서 사용자에게 자동으로 원하는 정보와 서비스를
제공하는 모델로 지능 에이젼트 시스템이 있다.
향후 개발되는 시스템은 지역이나
정보의 종류에 무관하게 원하는 서비스 에이젼트를 수행함으로서
에이젼트가 활동할 수 있는 영역내의 모든 정보를 가공해 얻을 수
있다.
위에 제시한 구현 방법중 현재 사용가능한
방법을 좀 더 자세히 살펴보자.
다음은 연방 모델을 통해 시스템을
구축할 때 필요로 한 기술들이다.
이러한 개별적인 기술들은 각기 나름대로의
고유한 영역을 가지고 있는 것들이다.
가령,
정보 관리 기술은 주로 데이타를
가공하고 데이타의 무결성과 안전성을 보장하는 기능을 제공한다.
또한 인터넷 기술은 TCP/IP란
통신 프로토콜을 사용하여 인터넷상의 정보를 클라이언트에게 제공하는
서비스를 제공한다. 이들
두 서비스들은 현실적인 요구 사항들에 의해 접목되고 있다.
이러한 요구 사항에는 증권회사의
증권 시세라든지 신문사의 데이타베이스 검색 등을 예로 들 수 있다.
그러나 이 두 서비스를 접목하는
과정에는 많은 문제점이 있다.
먼저 현재 사용되는 방법으로는 CGI(Common
Gateway Interface)가 있다.
이 방법은 WWW가
시스템의 환경 변수를 통해 외부의 프로그램과 연동하는 방법이다.
이 때 발생하는 문제로는 프로그래머의
경우 일일이 모든 CGI인터페이스를
작성하기 위해 WWW기술과
데이타베이스 기술을 잘 알아야 하고 여러 개의 데이타베이스 시스템을
사용할 경우 일일이 모든 인터페이스를 작성해야만 한다.
또한 두 시스템이 상호연동되어
작동할 때 많은 시스템 자원을 사용하므로 기대했던 성능을 보장받기
힘들다. 이
방법 외에도 자바 언어에서 제공하는 JDBC(Java
DataBase Connectivity)라는 데이타베이스
연동 기술이나 OLE를
통해 데이타베이스에 접근한 후 이 기술을 WWW에
통합할 수 있는 마이크로소프트의 ActiveX
등의 기술이 있다.
그러나 한 가지 중요한 점은 앞으로
요구되는 정보 시스템의 경우 단순히 데이타베이스 시스템뿐 만 아니라
기타 수많은 정보 시스템과의 연동이 불가피 하다는 것이다.
이런한 상황에서 프로그래머는
보다 많은 인터페이스를 작성해야만 한다.
앞선 문제점들을 극복하고 연방 시스템을
구축하기 위한 방법으로는 CORBA
시스템 연동기술과 인터넷 기술의
결합을 들 수 있다. 참고로
현재 COM의
경우 윈도우 응용 프로그램간의 연동만을 제공하므로 목표로 하는
시스템 구성에는 적합하지 않다.
이러한 기술적 결합을 통해 얻을
수 있는 장점은 다음과 같다.
지금까지 새로운 환경에 적합한 시스템을
구성하기 위해 필요한 여러 사항들을 종합해보았다.
결론적으로 향후 인터넷을 기반으로
한 정보 시스템을 구축하기 위해 가장 필요한 기술들로는 WWW로
대별되는 인터넷 기술과 CORBA로
대별되는 시스템 통합 기술의 접목이라 말할 수 있다.
특히 이 두 기술 모두 각각의
분야에서 표준으로 자리잡고 있는 것을 감안해 보면 당연한 결과라고
말할 수 있으며 이 두 기술의 결합을 통해 가장 안정적이고 유연한
시스템을 구축할 수 있을 것이다.
다음 절에서 이러한 두 기술의
결합을 위한 배경 기술과 결합 방법에 대해 살펴보도록 한다.
2.2 인터
넷
기술 동향
2.2.1 인
터넷
환경 이해
인터넷은 자연발생적으로 건설된 가상의
사회라 말할 수 있다. 수많은
컴퓨터 시스템들과 사람들이 전자 신호에 원하는 정보와 메세지를
실어 교환하고 있다. 이
때 가장 중요한 전송 매개체로 TCP/IP
프로토콜이 있다.
TCP/IP 프로토콜은 인터넷 환경에
속해 있는 모든 시스템들이 다른 시스템과 정보를 교환하고 새로운
시스템과 네트웍을 인터넷의 일부로 확장하는 표준 방법을 제공하고
있다. 이런
환경에서 인터넷은 6천만
명이 넘는 사람들이 이용하는 그야말로 전 세계를 무대로 한 명실상부한
세계최대의 네트웍으로 자리잡게 되었다.
그렇다면 어떤 연유에서 인터넷이
현재처럼 성장하게 되었는지 인터넷에서 제공하는 정보 시스템의 종류와
그 발전 방향을 중심으로 생각해보자.
먼저 인터넷 정보 시스템이란 인터넷을
기반으로 하여 각종 정보 서비스를 제공하는 시스템을 말한다.
예를 들면,
인터넷상의 전자우편 시스템이나
원하는 문서를 검색하기 위한 시스템이 있다.
실제 이러한 인터넷 정보 시스템은
다음의 몇 가지 주요한 방향을 가지고 발전되어 왔다.
이러한 방향은 기존의 인터넷 정보 시스템이
새로운 환경에 적합한 방향으로 변화하고 있다고 요약할 수 있다.
다음 [그림5-24]은
현재 이용 가능한 인터넷 정보 시스템을 분류한 것이다.
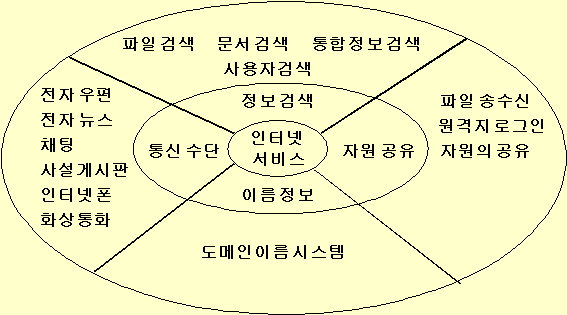 [ 그림5-24 ] 인터넷
정
보
시스템의 분류
초기
인터넷을 이용하는 사람들에게
있
어
가장 유용하고 애용되는 서비스가 바로
전자우편과 전자뉴스(USENET News) 같
은
통신 서비스였다. 국경을 초월하여
원하는 사람에게 편지를
주
고받는 전자우편과 공통의 관심거리를
갖고 있는 사람들이
그
룹을 만들고 자신의 견해와 의견을
주고받는 전자뉴스는 많은
사
용자들에 의해서 사용되고 있다.
참고로 SMTP(Simple Mail Transfer Protocol)는 전자우편을 전달할 때 이용하는
프로토콜이고 NNTP(Network News Transfer Protocol)는 전자뉴스를 전달할
때
사용하는 프로토콜이다
.
뒤를 이어 키보드 입력을 통해 원하는
사람과 일 대 일로 대화를
나
누는 Talk와 다 대 다 대화를 나누는 IRC(Internet Relay
Chat)가 인터넷 통신
서
비스로 등장했으며 최근 들어
인터넷 전화와 화상
통
화 , 사설 게시판 (BBS , Bulletin Board system)
등
이
각광을 받고 있다
.
|
서비스 형태 |
대화형 통 신 서비스 |
배치형 통 신 서비스 | ||
|
서비스 명 |
서비스 예 |
서비스 명 |
서비스 예 | |
|
일 대 일 |
대화 |
Talk , Phone |
전자 우편 |
SMTP |
|
다 대 다 |
토론 |
IRC |
전자 뉴스 |
NNTP |
인터넷이
이처럼 성장하게 된 결정적인
배
경에는 크게 몇 가지가 있을 수 있다.
먼저 가장 가깝게는
WWW(World Wide Web)의 폭발적
성장을 들 수 있겠고 멀게는
TCP/IP 프로토콜을 들 수 있다. 특히
이
프로토콜이 유닉스 운영
체
제의 일부로서 자리잡으면서 인터넷이
태동되기 시작했다고 말할
수
있
다. 이렇게 된 데에는 TCP/IP가 제공하는 다양한
정보 공유 서비스가
많
은
사용자에게 큰 유용성을 제공한 데 기인한다.
먼저 인터넷 사용자는
TELNET이나 Rlogin을 이용하여 원격지에
있는 컴퓨터에 로그인
할
수
있
으며 rsh(remote shell)같은
유닉스 명령어를 통해
원
격지 컴퓨터에 명령을 지시할 수도
있다.
또한 파일 송.수신을
위
해 FTP(File Transfer
Protocol)나 유닉스의 rcp(remote copy)같은
명
령어를 사용할 수 있으며 선 마이크로시스템의
NFS(Network File System)나
카
네기 멜론 대학에서 개발한 AFS(Andrew File
System)를 이용하여 원격지
컴
퓨터의 파일 시스템을 공유할 수도
있다.
|
서비스 형 태 |
대화형 정 보 공유 서비스 |
배치형 정보 공유 서비스 |
|
원격지 로그인 |
TELNET , Rlogin | |
|
원격지 명령 수행 |
rsh |
UUCP |
|
파일 전송 |
FTP , rcp | |
|
파일 공유 서비스 |
NFS , AFS |
인터넷
정보 검색 시스템은
현
재
가장 각광받고 있는 인터넷 서비스
분야이다. 인터넷이 점점
더
확
산될 수록 검색 서비스에 대한 요구는
증가하기 때문에 보다
쉽
고
빠르게 원하는 정보를 찾을 수 있는
검색 서비스는 중요하다고
말
할
수
있다. 여기서 하나 주의해야 할 점은 무엇을
검색할 것인가 하는
문
제이다. 가령 , 우리는 인터넷상에서
특정한 사람을 찾을
수
도
있으며 특정 컴퓨터를 찾을 수도
있다. 또한 특정
파
일이나 문서를 찾을 수도 있다.
이러한 것을 개별적인
목
적으로 하여 많은 인터넷 서비스들이 개발되어
왔다. 다행스럽게도
이
러한 개별적인 검색 서비스들이
WWW를 중심으로 하나로
통
합되는 추세이기 때문에 이 모든
검색 서비스를 익힐
필
요는 없을 것이다. 그러나 어떤
서비스들이 있는 지에
대
해서는 숙지해야 할 것이다.
예를 들어 [표5-8]에서
처
럼
컴퓨터에 대한 정보를 제공해주는 서비스로
X.500와 앞서 살펴본
DNS , NIS가 있다. 특히 X.500은 디렉토리와
이름 서비스를 제공해주기
위
한 ISO-OSI 표준이다. 또한
인터넷 사용자의 이름과
전
화번호같은 정보를 제공해주는 서비스로
중앙에 사용자에 대한
데
이타베이스를 관리하고 이를
통해 서비스를 제공하는
WHOIS 서비스와 개별적인 호스트의
사용자 정보를 제공하는
핑
거(Finger) 서비스 , 각종 인터넷
프로토콜을 이용하여 인터넷
사
용자의 정보를 제공하는 넷파인드(Netfind)가 있다
.
원하는 파일을 찾아주는
서
비스로는 인터넷상의 Anonymous
FTP서버들의 정보를 모은
후
이
를
이용하여 원하는 파일을 검색해주는
아키(Archie)와 Anonymous FTP서버
의
파일들을 마치 로컬 컴퓨터의 파일처럼
제공하여 검색해주는 프로스페로
(Prospero) , 네트웍 파일
시스템을 이용하여 Anonymous FTP상의
파
일을 가상 파일 시스템에 위치시켜주는
알렉스(Alex)등 이 있다
.
마지막으로 각종 키워드를 사용하여
원하는 문서를 찾아주는
WAIS나 고퍼(Gopher)같은 서비스와
하이퍼 텍스트 방식으로
원
하는 문서나 파일을 찾기 위해
인터넷을 항해하는 WWW가
있
다.
|
|
|
|
|
|
|
정보 검색 |
X.500 DNS NIS |
X.500 WHOIS 핑거 넷파인드 |
X.500 아키 프로스페로 알렉스 고퍼 WWW |
X.500 웨이즈 고퍼 WWW |
|
정보 선택 |
FTP NFS AFS 프로스페로 |
웨이즈 고퍼 WWW | ||
|
정보 추출 |
웨이즈 고퍼 WWW |
인터넷
이름 정보 시스템은
한
마디로 인터넷 사용자들이 주로 사용하는
도메인 이름(또는
호
스트 이름)을 컴퓨터들이 인식할 수 있는
IP주소(Internet Protocol Address)로
변
환해주는 시스템을 말한다. 다시
말해 컴퓨터의 경우
문
자를 인식하지 못한다. 따라서 인터넷상의
컴퓨터들은 서로간에 구별하기
위
한
방법으로 IP주소라는 것을 사용한다.(
예
, 202.30.143.10 ) 그런데 문제는
이
러한 주소는 사람들이 사용하기에는
불편하기 때문에 대부분의
사
용자는 도메인 이름이라는 방식을 사용하여
컴퓨터를 구별한다. (예 , www.postech.ac.kr ) 이때 IP주소와 도메인 이름사이의
변환은 항상 일관성이
유
지돼야 한다. 왜냐하면 인터넷상에서
원하는 컴퓨터를 정확히
접
속하기 위해서이다. 따라서 사용자의
도메인 이름을 IP주소로
바
꿔주는 서비스가 인터넷 이름
정보 시스템이다.
2.2.2 인
터넷
통합 정보 시스템, WWW
이해
앞서 살펴본 것처럼 인터넷에는 많은
정보 시스템이 존재한다. 그러나
이러한 시스템들은 WWW서비스로
통합되고 있는 실정이다. 그
이유로는 여러 가지가 있지만 가장 중요한 dl이유들로는
손쉬운 사용자 인터페이스 , 폭넓고
다양한 정보 서비스 , 기타
정보 시스템의 통합 기능 등을 들 수 있다.
2.2.2.1 WWW의 태동과
주요 특징
WWW는
World-Wide-Web 또는
W3
라
불린다. WWW는
스위스, 제네바에
위치한 CERN ( the European Laboratory
for Particle Physics )에 의해서
주도된 프로젝트의 소산물로써 컴퓨터 네트웍에 연결되어 있는 사용자들이
멀티미디어를 포함한 다양한 정보를 하이퍼미디어 인터페이스를 통하여
검색할 수 있게 해준다.
WWW는
CERN의
팀 버너스 리(Tim Berners Lee
)에 의해서 최초로 제안된 후
그의 주도하에 개발되었다. 본래
WWW 개발
시 기본 아이디어는 프로젝트를 수행하는 연구원들의 개인 정보를
공유하기 위해 사용하던 소규모의 개인용 하이퍼텍스트 시스템에서
출발하였다. WWW은
두개 이상의 프로젝트 사이에서 서로 관계를 맺고 있던 한 프로젝트의
정보가 변하더라도 이 변화가 다른 프로젝트에 자연스럽게 융화되도록
고안되었다.
현재 WWW는
현재 인터넷 서비스 중에서 가장 주목 받는 서비스로 부상했고 실제
NSFNET의
경우 WWW의
증가 속도가 인터넷 증가의 2배
이상 된다고 한다. 이렇듯
WWW가
급속한 확산을 하는 데는 WWW가
갖고 있는 다음의 특징에 기인한다.
WWW은
TCP/IP상에서
HTTP(Hypertext Transfer
Protocol)라는
프로토콜을 사용하는 클라이언트/서버
구조이다. 넷스케이프나
익스플로어같은 WWW클라이언트는
HTTP를
통해 해당 WWW서버에
서비스를 요청하고 이에 대한 결과를 주고받는다.
WWW서버는 WWW클라이언트에는
고퍼나 FTP처럼
모든 타입의 서버들에 대해 하나의 인터페이스를 통한 접근을 가능하게
해준다. 따라서
새로운 프로토콜을 기반으로 하는 인터넷 서비스가 출현한다고 하더라도
이 프로토콜을 WWW에
추가함으로서 완벽한 프로토콜 확장성을 보장할 수 있다.
하이퍼텍스트는 한가지 차이점만을 제외하고는 일반적인 문서와 동일하다. 한가지 차이점은 하이퍼텍스트 문서는 문서 내부에 다른 문서에 대한 연결점(hyperlink)을 갖을 수 있다는 것이다. 이 연결점을 통해 한 하이퍼텍스트 문서에서 다른 하이퍼텍스트 문서로의 이동이 가능하다. 따라서 사용자는 최초의 하이퍼텍스트 문서 내부의 연결점중 원하는 정보를 선택함으로서 정보를 검색할 수 있다. 이러한 하이퍼텍스트의 확장된 개념이 하이퍼미디어이다. 하이퍼미디어는 단순히 문서의 형태뿐만 아니라 음성이나 정지 화상, 동화상 등의 멀티미디어 데이타에 대한 연결점을 설정할 수도 있다. 따라서 사용자는 멀티미디어를 포함한 문서 정보를 검색할 수 있다. WWW이 전세계에 급속히 확산된 것은 하이퍼텍스트를 통해 수많은 정보들 사이의 관계를 설정할 수 있는 능력에 기인하는 것이다. 전체 WWW입장에서 보면 WWW 호스트의 증가나 WWW 호스트상의 정보 변화는 전체 WWW의 구성과 정보에 자연스럽게 융화되며 확장된다. WWW을 이용하는 사람은 전혀 이러한 변화에 대해 걱정할 필요가 없다.
WWW 서비
스는
넷스케이프같은 WWW클라이언트와
WWW서버사이에서
원하는 서비스 요청과 이에 대한 결과를 주고 받음으로서 이루어 진다.
따라서 이 사이에서 필요한 양식과
기능이 실제 WWW을
운영하는 데 필요한 구성요소들이다.
[ 그림5-25
]는 이 구성요소들을 통해 WWW가
어떻게 작동되고 있는지 보여주고 있다.
먼저 WWW클라이언트는
WWW서버에게
URL(Uniform Resource
Locator)라는
양식으로 원하는 서비스를 요청한다.
URL은 해당 WWW서버의
이름과 원하는 정보를 표현하고 있다.
[그림5-25]에서
http://home.netscape.com/real-index.html
이 바로 URL이다.
따라서 WWW에서
원하는 정보를 얻기 위해서는 해당 URL을
알고 있어야 한다. 물론
WWW서버에서
제공하는 문서의 하이퍼링크를 이용할 수도 있지만 하이퍼링크없이
원하는 WWW서버로
이동하기 위해서는 URL을
사용해야 한다.
일단 URL을
통해 서비스 요청을 받은 WWW서버는
해당 서비스의 요청에 따른 정보를 준비한 후 다시 WWW클라이언트에게
보낸다. 이
때 서비스 결과는 HTML이라는
문서이다. 이
문서는 멀티미디어를 포함한 하이퍼텍스트 양식으로 구성되어 있다.
따라서 이 특정한 문서를 보내기
위해 WWW는
HTTP라는
프로토콜을 사용한다.
일단 원하는 문서를 전달받은 WWW클라이언트는
해당 HTML문서를
읽은 후 이 문서를 사용자에게 보여준다.
실제 이 과정은 넷스케이프같은
WWW 클라이언트가
담당하기 때문에 걱정할 필요가 없다.
그러나 사용자는 WWW상에서
원하는 정보가 HTML이라는
양식으로 표현되고 이 문서가 HTTP라는
방식으로 전달되고 있음을 이해해야 한다.
따라서 사용자는 WWW상에서
원하는 정보를 알리기 위해 HTML양식에
맞게 정보를 구성해야 한다. 마지막으로
WWW서버는
데이타베이스 시스템이나 기타 외부의 프로그램과 연동하기 위해 CGI(Common
Gateway Interface)라는 기능을
제공한다. 이
기능을 이용하여 사용자는 원하는 정보를 검색하거나 갱신하는 등
다양한 외부의 프로그램을 WWW에서
이용할 수 있다.
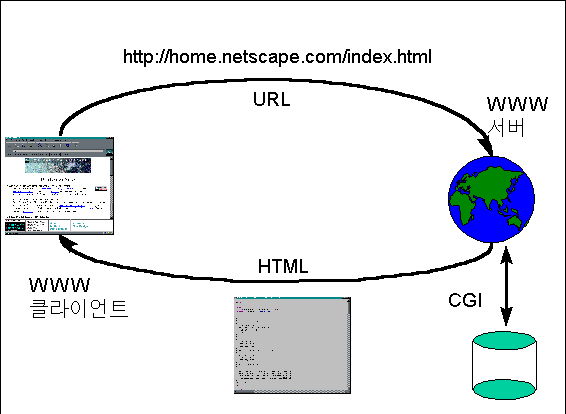
[
그림5-25
] WWW의 작동 원리
2.2.2.3 WWW 구성
요소들의 이해
앞서 WWW가
작동되는 원리와 구성요소에 대해 자세히 살펴보았다.
여기서는 해당 구성 요소들의
기능에 대해 좀 더 자세히 살펴본다.
WWW 클라 이언트는 WWW서버에게 URL이라는 양식을 이용하여 서비스를 요청하고 이에 대한 결과로 전달받은 HTML문서를 해석한 후 사용자에게 표현해주는 역할을 한다. 다양한 멀티미디어를 표현하기 위해 외부의 프로그램을 사용하기도 한다. 그러나 최근에는 외부의 프로그램을 통해 멀티미디어를 별도의 윈도우에 표현하기 보다는 WWW클라이언트내에 직접 내장(Plug-in)하여 멀티미디어를 표현한다. WWW클라이언트 프로그램으로는 넷스케이프사의 넷스케이프 , 마이크로소프트사의 인터넷 익스플로어 , Cello , WinWWW , Nynx , Emacs WWW-mode등 다양하다.
WWW서버는
해당 WWW 서비스
요청에 대한 결과인 HTML 문서를
제공한다. 특히
WWW서버는
고퍼 , 웨이즈
, FTP , 아키
,
뉴스
,
메일
등 다양한 프로토콜을 지원하기 때문에 별도의 프로그램없이 WWW상에서
이러한 서비스를 이용할 수 있다.
또한 CGI라는
방법을 사용하여 외부의 프로그램을 연동하여 사용할 수도 있다.
이용가능한 WWW서버로는
NCSA
httpd , Apache , CERN , BESTWWWD , Machttp , WWWstar , HTTPS ,
Netscape등이 있다.
본래 WWW에서
사용되던 주소 지정방식은 URIs(Universal
Resource Identifiers)라 불리는
주소 시스템으로서 WWW내의
문서나 멀티미디어 정보 등을 구별하기 위해서 사용된다.
그러나 인터넷 표준 프로토콜의
개발과 기술 검증을 담당하고 있는 IETF(Internet
Engineering Task Force Team)에서는
이와 유사한 개념으로 URL (Uniform
Resource Locators )을 정의했다
.
URIs와 URL은
그 용도와 개념 자체가 거의 같다고 말할 수 있다.
그러나 실제의 경우 URIs가
URL을
포함하는 개념이다. 그러나
일반적으로 IETF의
URL을
WWW의
주소 시스템으로 사용한다.
URL은
WWW에서
사용되는 만국 공통어이다. 따라서
사용자는 원하는 문서나 정보를 명시할 때 URL의
형식에 맞춰 기술한 후 원하는 WWW서버에
서비스를 요청하기만 하면 된다.
URL은
[
그림5-26
] 처럼 프로토콜 ,
호스트 주소 ,
해당 파일정보 등 3개의
주요한 부분으로 구성된다.
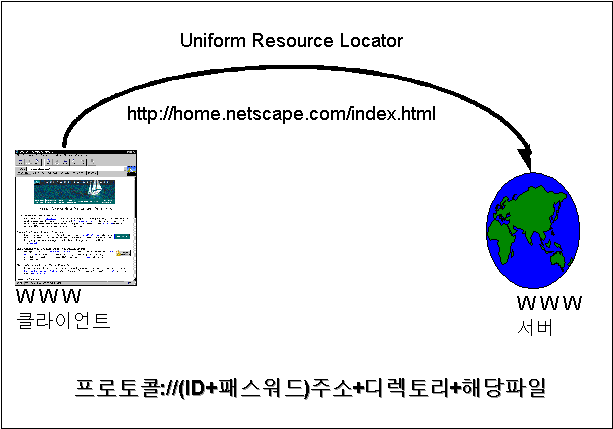
[
그림 5-26
] WWW의 URL
주소시스템
[ 그림 5-26 ]의 예에서 사용된 URL을 살펴보자. ( http://home.netscape.com/index.html ) 앞선 예는 다음과 같이 해석된다 .
프로토콜 http
호스트 식별자 ://
호스트 이름 home.netscape.com
경로명 /
파일이름 index.html
URL에서
프로토콜은 사용하고자 하는 해당 인터넷 서비스의 프로토콜을 명시한다.
앞선 예에서 http는
WWW 서비스의
사용을 의미한다. 또한
ftp
나
gopher , wais , nntp ,telnet같이
다른 인터넷 응용 프로그램 등을 명시할 수 있다.
URL에서
프로토콜을 명시한 이후에는 호스트 식별자로 ://가
나오는 데 :는
프로토콜이 끝났음을 의미한다.
: 다음에 수반되는 //는
호스트 이름이 시작됨을 의미한다.
URL에서 호스트 식별자 다음에는
호스트 이름이 명시된다. 앞선
예에서는 home.netscape.com이
호스트 이름이다. 보통의
경우 WWW는
기본적으로 80번
포트를 사용하여 서비스를 제공한다.
그러나 만약 시스템의 사정에
의해서 기존 80번
포트를 이용하지 못하는 경우에는 호스트이름:포트
번호와 같은 형식으로 명시해야 한다.
참고로 8080이나
8888같은
포트는 해당 WWW서버가
시험 운영중임을 의미한다.
URL에서
호스트 이름 다음에는 원하는 파일이 위치한 경로명이 표기된다.
이때 디렉토리간의 구분은 /(슬래쉬
)를
이용한다. 윈도우나
도스상에서 역슬래쉬는 사용하지 않는다는 점을 주의하기 바란다.
URL에서 가장 마지막에 명시되는
정보는 파일의 이름이다. 앞선
예에서는 index.html이다.
여기서 중요한 것은 html
형태의 파일이다.
WWW에서 사용하는 기본 파일 형식은
HTML(Hypertext Markup
Language)이다.
따라서 WWW에서
제공하는 모든 하이퍼미디어 문서의 확장명은 .html이다.
URL은 마치 한 디렉토리내에서
같은 이름의 파일이 동시에 존재할 수 없듯이 URL은
인터넷상에 연결되어 있는 모든 파일을 유일하게 인식할 수 있는 기능을
제공한다. 아울러
URL은
원하는 인터넷 서비스의 프로토콜을 명시하게 함으로서 이후 추가되는
인터넷 서비스를 확장할 수 있는 기능을 제공한다.
인터넷상에는 수많은 WWW서버와
클라이언트가 위치하고 있으며 이들은 각기 필요한 정보를 요청하고
이 요청에 부흥하는 정보를 주고받음으로써 WWW서비스가
이루어진다. 이때
WWW클라이언트와
WWW서버
사이에는 일정한 약속이 있는 데 이를 HTTP(Hypertext
Transfer Protocol) 라 한다.
다시 말해 HTTP는
WWW클라이언트와
WWW서버
사이에 사용되는 통신 규약이다.
이 규약에는 WWW클라이언트가
원하는 WWW 문서를
요청할 수 있는 방법과 이를 찾고 이에 대한 결과나 상태를 전달하는
방법들로 구성되어 있다.
HTTP에
대한 자세한 내용은 인터넷에서 제공하는 각종 정보를 이용하여 이해하길
바란다. 단지
여기서는 HTTP의
중요한 특징에 대해서만 살펴본다.
-> HTTP
는
WWW클라이언트의
요청에 대한 WWW서버의
응답으로 이루어지는 통신 규약이다.
WWW사용자는 WWW클라이언트를
이용하여 하이퍼 연결점(Hyperlink)을
선택함으로서 이 하이퍼 연결점에 해당하는 정보를 요청하고 WWW서버는
이 요청에 해당하는 정보를 제공한다.
이러한 과정의 연속 작업으로써
사용자는 원하는 하이퍼 연결점을 통해 인터넷의 모든 정보를 활용할
수 있다. 이때
정보란 단순히 하이퍼텍스트만을 의미하는 것이 아니라 일반 문서나
그림, 소리,
동화상 등의 가능한 모든 정보를
의미한다.
- HTTP는
단순히 WWW에서
사용하는 문서인 HTML만을
전송하는 통신 규약이 아니다.
실제 WWW클라이언트에서는
HTML문서뿐만
아니라 다른 형태의 문서도 처리 가능하다.
이 말은 실제 HTTP가
문서를 처리할 경우 특정한 형태의 문서에 의존하지 않는다는 말이다.
따라서 WWW클라이언트는
처리 가능한 문서의 종류에 대한 정보를 WWW서버에게
보내고 WWW서버는
생성 가능한 문서를 보냄으로서 HTTP는
특정한 문서에 의존하지 않는다.
이러한 처리 방법은 각종 압축파일이나
한국어나 영어, 일어같은
언어들사이에서도 적용된다.
- HTTP에서
클라이언트는 서버에게 원하는 정보에 대한 URL과
함께 GET , PUT, POST같은
메소드를 함께 WWW서버에게
보낸다. WWW서버는
요청된 URL에
해당하는 정보를 메소드를 사용하여 보낸다.
예를 들어 GET메소드는
단지 요청한 문서만을 전송하는 기능을 제공한다.
- HTTP는
전송시 패킷의 헤더부분에 전송될 객체에 대한 정보를 담고 있다.
이때 HTTP
헤더는 MIME(Multipurpose
Internet Mail Protocol)형식으로
구성되어 있다. 따라서
다른 형태의 정보를 처리할 수 있다.
가령,
하이퍼미디어 전자우편이나 표준화되지
않은 문서 등을 처리할 수 있다.
HTML은
단순하지만 멀티미디어를 포함한 강력한 비주얼 효과를 제공하는 문서이다
.
HTML은 두 가지 측면에서 중요한
원리를 갖는다. 첫번째로는
WWW 문서를
위한 마크업 언어로서 마크업 표준언어인 SGML(Standard
General Markup Language)의 일부
기능을 제공한다. 즉,
문서의 형식을 정의할 수 있다
.
또한 HTML은
한 문서에서 다른 문서로의 이동을 가능하게 하고 각종 멀티미디어
문서 기능을 지원하는 하이퍼미디어 기능을 제공한다.
마크업 언어란 원하는 문서의
형태에 적합한 마크를 선언함으로서 이 마크를 해석하는 컴파일러에
의해서 자동적으로 문서를 만들어 내는 언어를 말한다.
이러한 특징때문에 HTML문서는
Lynx같이
문자를 기반으로 하는 WWW클라이언트에서는
문자의 크기나 타입, 각종
멀티미디어 정보를 표현할 수 없다.
그러나 넷스케이프나 익스플로어같은
그래픽 브라우저 도구에서는 마크에서 제공하는 다양한 기능을 이용할
수 있다.
가장 일반적인 HTML
문서 작성 방식은 유닉스의 vi나
emacs같은
일반적인 문서편집기나 윈도우의 edit,
hwp같은 문서편집기를 이용하여
문서를 작성하거나 HTML문서
편집을 도와주는 각종 HTML편집기를
이용하는 방법이 있다. 사실
HTML문서
작성에 있어 가장 훌륭한 도구는 MS
익스플로어이나 넷스케이프같은
WWW클라이언트
그 자체이다. 왜냐하면
이들은 로컬 시스템에서 작성된 HTML문서를
화면에 보여주는 기능을 제공할 뿐만 아니라 화면상으로 표현되는
HTML문서
그 자체 내용도 확인할 수 있기 때문이다.
이 기능을 이용하여 우리는 원하는
문서를 쉽게 작성할 수 있다.
WWW는
URL을
통해 HTML문서가
전달되는 정적인 정보 전달 방식의 시스템이다.
이러한 문제점을 약간이나마
해결하고자 나온 방법이 CGI이다.
WWW클라이언트는 HTML문서내에서
NAME="jhpark"
, CreditID="1234"처럼
원하는 매개변수를 지정하여 보낸다.
서버는 이 매개변수를 사용하여
해당 호스트의 환경 변수를 지정하고 외부의 프로그램에 이 환경 변수를
전달하여 원하는 작업을 수행시킨다.
CGI에서 사용하는 환경 변수들은
대부분의 운영 체제에서 지원한다는 장점이 있지만 각 프로그램들이
미리 정의된 환경 변수들을 이용하도록 작성돼야 하고 WWW클라이언트도
사전에 어떤 환경 변수들이 있는지 알고 있어야 한다.
CGI방법말고 외부의 프로그램을
호출하는 방법으로는 BGI(Binary
Gateway Interface)라는 것이
있는데 BGI는
환경 변수를 선언하는 대신에 WWW서버상에서
외부의 프로그램이나 DLL을
수행시킨다. 이
경우, 환경
변수 대신에 미리 정의된 API를
사용한다.
2.3.1 인
터넷
기술과 CORBA 기술의
진정한 의미
최근 들어 인터넷 기술분야에서 급속도로 확산되고 있는 분야가 인트라넷이란 분야이다. 흔히들 인트라넷을 "작은 인터넷' 정도로 인식되는 경향도 있지만 정보 관리 차원에서 인트라넷은 보다 큰 의미와 가능성을 제공한다. 왜냐하면 인트라넷은 기관이나 단체에게 작은 정보 고속도로를 제공하기 때문이다. 특히 이 고속도로는 외부와의 연결에도 가장 안전한 연결방법을 제공하며 기존의 인터넷에서 개발된 정보 시스템을 그대로 이용할 수 있게 해준다. 예를 들어, 특정 기관에서 TCP/IP를 응용한 인트라넷을 구성한다면 당장 기존에 인터넷에서 사용했던 전자우편이나 뉴스, WWW기술 등을 재사용할 수 있다. 이를 통해 가장 저렴하고 효율적인 정보 네트웍을 구성할 수 있게 된다. 이 때 해당 인트라넷에는 기존의 조직이나 기관에서 사용했던 응용 프로그램이나 시스템을 통합해야 만 한다. 이 문제를 해결하기 위한 방법으로 가장 적합한 것이 바로 CORBA를 이용하는 것이다. 다음 [그 림5-27]은 CORBA를 인터넷에 이상적으로 적용하는 환경 중 하나이다. 인트라넷 또는 인터넷을 이용하는 사람들은 기존에 이용하던 WWW클라이언트를 통해 쉽게 기업에서 제공하는 WWW서버에 접근한다. 이 때, WWW서버는 CORBA를 통해 기존의 사용하던 모든 응용 시스템을 통해 보다 적극적으로 정보를 제공할 수 있다. 가령, 객체 지향 데이타베이스에 저장되어 있는 데이타나 관계형 데이타베이스에 저장되어 있는 데이타, 파일에 저장되어 있는 데이타 등 각종 정보 시스템을 총망라한 정보 시스템을 구성할 수 있다. 이 때 시스템 구축자는 단지 CORBA 인터페이스만 알고 있으면 된다 .
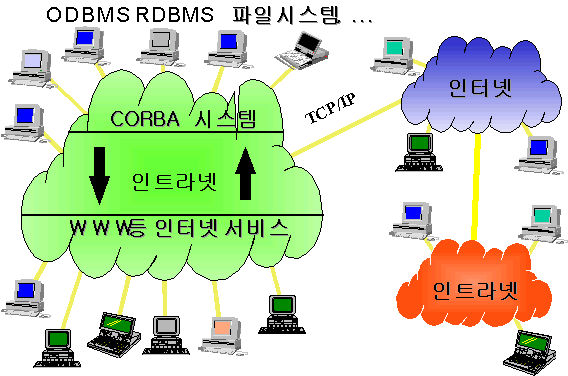
[ 그림
5-27
] 인트라넷과 CORBA
2.3.2 CORBA-WWW를
연동하기 위한 여러가지 방법
WWW와
CORBA를
통합하기 위한 방법은 크게 다음의 2가지로
대별할 수 있다. 먼저
이 두 시스템에 변경을 가하지 않고 WWW의
CGI처럼
기존의 방법을 이용하여 통합하는 방법이 있다.
다른 방법은 이 두 시스템을 확장하거나
변형시켜 통합하는 방법을 들 수 있다.
가장 기초적인 WWW와 CORBA의 연동방법은 WWW서버의 외부 프로그램 연동방법인 CGI(Common Gateway Interace)를 이용하여 CORBA게이트웨이 프로그램을 작성하는 것이다. 이때 CGI게이트웨이는 WWW의 요청을 CORBA에게 전달하고 CORBA가 이를 받은 후 수행한 결과를 HTML문서 양식으로 작성한 후 돌려주는 역할을 한다. CGI는 환경 변수를 통해 외부의 프로그램을 사용하는 방법이다. 실제 이 방법의 경우 WWW서버가 CGI프로그램의 요청에 대해 CGI를 수행하는 별도의 WWW서버(실제 CGI프로그램)를 생성하기 때문에 다수의 서비스가 요청될 경우 시스템에 많은 부하가 걸린다. 또한 프로그램 개발 시 CGI 프로그램 방법과 CORBA 응용 프로그램 작성방법을 모두를 알아야 만 한다.
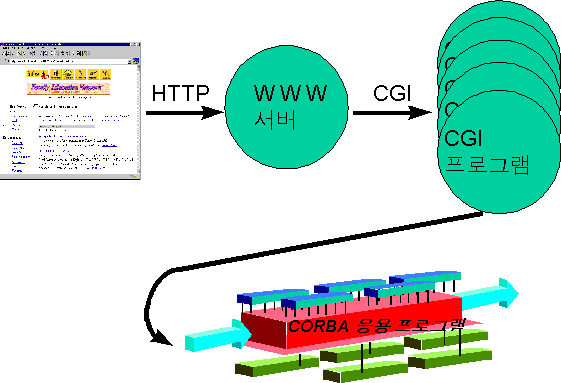
[ 그림
5-28 ] 전형적인
CGI방법을
통한 WWW-CORBA 통합
CGI방법
외에 시스템에 어떤 강제적인 변형을 주지않는 방법으로 자바 언어로
작성된 CORBA응용
프로그램을 들 수 있다. 자바
언어는 애플릿이라고 하는 인터넷 응용 프로그램의 작성을 가능하게
해준다. 다시
말해 자바로 작성한 애플릿은 넷스케이프나 익스플로어같은 웹부라우져내에서
작동되는 프로그램이다. 따라서
CORBA IDL로
작성한 프로그램을 자바로 변환하여 사용하면 시스템상의 어떠한 변형없이
인터넷상에서 CORBA의
응용 프로그램을 이용하게 된다.
이 방법에 대한 자세한 내용은
다음 장에서 중점적으로 다루기로 한다.
왜냐하면 CORBA
IDL-자바 매핑은 인터넷 환경에서
진정한 통합 솔루션을 구축하기 위한 단서를 제공하기 때문이다.
자바 언어외에도 이와 유사한
목적으로 사용되어지는 언어로 TCL(Tool
Command Language)와 Telescript가
있다.
2.3.2.2 시
스템의
변형을 통한 통합
다음의 방법들은 CORBA시스템을
활용하기 위해 WWW시스템에
변형을 가하는 방법들이다.
이 방법은 CORBA응용
프로그램을 작성하는 데 있어 기본이 되는 IDL언어를
WWW상에서
이용가능한 형태의 클라이언트를 위한 스터브 코드,
HTML 폼 화면,
CGI로 존재하는 서버를 위한
스켈로턴 코드를 작성해주는 것이다.
이 때 클라이언트 스터브 코드는
WWW 라이브러리(일반적으로
libwww)에서
제공하는 기능을 이용하여 CGI로
존재하는 서버 프로그램을 호출하게 된다.
이 방법은 CORBA서
제공하는 프로그램 작성방법을 그대로 사용할 수 있다는 장점은 있지만
규모가 큰 응용 프로그램을 작성하는 경우 많은 문제를 발생시킨다.
예를 들면,
수 백 개의 인터페이스로 정의된
IDL파일을
어떤 식으로 HTML폼과
클라이언트 코드로 구분할 것인가 하는 문제이다.
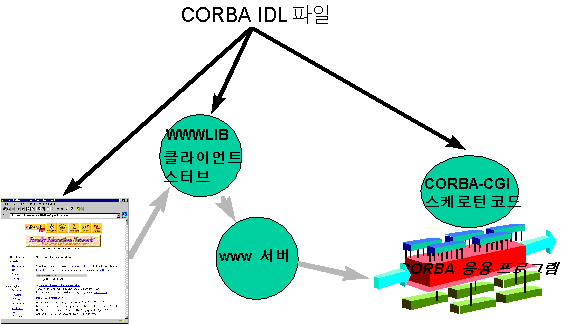
[
그림5-29
] CORBA IDL의 확장
이 방법은 크게 HTTP프로토콜을
CORBA의
기본 통신 메커니즘으로 사용하는 방법과 HTTP자체에
CORBA서비스의
사용을 위해 추가 모듈을 설치하는 방법이 있다.
전자의 경우 CORBA의
통신 방법으로 HTTP를
사용함으로서 CORBA응용
프로그램에서 WWW의
기능을 활용할 수 있는 토대를 제공할 수 있다.
후자의 경우 HTTP를
통해 CORBA서비스의
호출을 가능하게 한다. 이를
위해 WWW서버에
CORBA서비스
호출 시 각종 타입 정보 등을 관리하기 위한 모듈과 생성된 CORBA서비스를
알려주는 모듈 등 새로운 모듈을 추가해야 한다.
이러한 방법에 대한 자료는
http://www.scu.edu.au/ausweb95에서
찾을 수 있다.
2.4 현
상황과 미래
2.4.1 현
재
이용 가능한 소프트웨어들
현재 WWW에는
분산 객체기술을 도입하여 객체지향 기술을 WWW에
연동하려는 노력들이 여러 시스템에서 경주되고 있다.
이러한 노력들은 크게 순수한
객체지향 기술을 연동하려는 노력들과 분산객체 표준인 CORBA를
연동하려는 노력으로 분류할 수 있다.
2.4.1.1 WWW와
순수한 분산객체 기술의 연동 시스템
URL :
http://www.research.digital.com/SRC/Obliq/Obliq.html
Obliq는
모듈라3언어에
기반한 데이타 타입이 없는 인터프리터 언어이다.
특히 이 언어는 분산객체를 다루기
위한 기능을 제공한다. 이
기능외에도 쓰레드, 다중
네트웍 등 다양한 기능을 제공하고 있다.
이 언어를 바탕으로 WWW상에서
사용자들이 Obliq에서
제공하는 작업(Session)을
공유하도록 개발된 것이 Visual
Obliq이다.
넷스케이프나 익스플로어같은
WWW클라이언트에
Visual Obliq의
인터프리터를 외부 프로그램으로 등록함으로서 Obliq의
작업을 공유할 수 있다.
URL :
http://www.apocalypse.org/pub/u/antony/phantom/phantom.html
Phantom은
Obliq에
분산 환경에 보다 적합한 기능들을 추가한 언어이다.
특히 객체개념과 모듈,
인터페이스,
예외사황,
가베지 컬렉션 등이 추가되어
보다 안정적인 분산 프로그램이 가능하다.
URL : http://www.python.org/
Python은
그 자체로는 분산 프로그래밍 언어가 아니다.
그러나 Python은
인터프리터 방식의 객체지향 언어이며 상호작동식 프로그램이 가능하다.
이를 위해 모듈,
클래스,
예외 상황,
동적 테이타 타입,
다양한 윈도우 시스템(X윈도우
,
MFC, 맥..)등을
지원하고 있다.
URL : http://monty.cnri.reston.vaus/grail-0.2/
Grail은
마치 자바 인터프리터를 내장한 넷스케이프처럼 Python으로
작성된 코드를 수행가능하게 Python
인터프리터를 내장한 WWW부라우져이다
.
참고로 Python/Grail
은 자바/핫자바와
유사한 프로젝트의 소산물이다.
URL : http://www-swiss.ai.mit.edu/~jar/s48.html
Schema48은 가상 머쉰 환경에서 바이트 코드를 수행하는 환경이다.
URL : http://arjuna.ncl.ac.uk/arjuna/summary.html
Arjuna는
폴트톨런트(Fault-tolerant)한
분산 응용 프로그램을 작성하는 데 필요한 일련의 도구를 지원하는
객체지향 프로그래밍 시스템으로서 분산 객체상에서 중첩된 트렌젝션을
지원하며 RPC를
사용하여 객체간의 상호작동이 가능하다.
W3Objects는 Arjuna를
기반으로 하여 WWW상에서
객체지향 시스템을 통해 확장가능한 WWW하부
토대를 구축할 수 있도록 하는 시스템이다.
W3Objects에서 지원하는 기능으로
객체 중복, 동시성
제어, 캐슁,
폴트톨런트 등이 있으며 객체지향
개념을 지원한다.
CORBADesktop 은
모든 CORBA 메소드를
WWW의
폼형태로 변형시켜 사용할 수 있도록 해주는 시스템이다.
URL : http://webstar.cerc.wvu.edu/www4/www4.html
Web*는 WWW에서 실행가능한 CGI스크립트로서 TCL(Tool Commnad Language)라는 스크립트 언어를 기반으로 한다. 이 시스템은 CORBA 서비스와의 연동을 위해 TCL에 CORBA의 DII(Dynamic Invocation Interface) 호출 기능을 추가하였다. 이를 TCLDii라고 한다. 현재 아이오나의 Orbix제품과 연동되어 있다.
2.4.2 향
후
전망
현재 WWW의
기술을 주도하고 있는 W3C와
CORBA기술을
주도하고 있는 OMG는
이 두 기술을 접목하기 위한 활동을 하고 있다 현재 진행되는 방향으로는
WWW서버
데몬 프로그램인 HTTPD에
객체지향 기술을 결합한 새로운 데몬인 HTTPD/NG를
개발 중에 있다. 여기서
NG
는
Next Generation을
의미한다.
지금까지 미흡하나마 CORBA기술을 인터넷, 특히 WWW기술에 접목하기 위한 방법들에 대해 살펴보았다. 실제 이 모든 방법들은 현재 연구중이거나 테스트베드 형태로 소개되고 있다. 그러나 추후 인트라넷 환경이 가속화될수록 이종의 정보자원을 통합하기 위한 방법으로 CORBA기술의 중요성이 더욱 가중될 것이다. 특히 CORBA IDL-자바 매핑이 표준을 확정되면 CORBA를 WWW에 통합하기 위한 기술확산은 더욱 가속도가 붙으리라 생각한다.
3장
선소프트의 희망, JAVA
이 장에는 CORBA
기술을 WWW에
적용시키는 방법 중 가장 유연하고 이상적인 방법인 CORBA-자바
통합에 관해 살펴보겠다.
3.1 인터
넷
기술의 태동과 새로운 요구 사항의 출현
먼저 현재 소프트웨어 개발 환경에서
공통적으로 존재하는 문제중의 하나가 이종의 분산 환경에서 모두
호환 가능한 프로그램을 어떻게 작성할 것인가?
라는 것이다.
왜냐하면 현재 대부분의 응용
프로그램은 운영 체제에 종속적이기 때문에 개발 시 많은 시간과 비용이
들며 개발된 프로그램의 이식성도 보장받지 못한다.
예를 들면,
윈도우에서 개발된 응용 프로그램을
유닉스에서 사용할 수 없으며 그 반대도 불가능하다.
이러한 환경에서 WWW은
데이타를 조작하는 데 있어 표준방식을 제공한다.
가령,
WWW 부라우져를 사용하면
WWW서버를
통해 외부의 어떤 프로그램도 쉽게 접근할 수 있다.
그러나 WWW
가 갖고 있는 기본적인 한계는
정적인 정보만을 제공한다는 것이다.
다시 말해 WWW에서
관심있게 처리되는 것은 프로그램이 아니라 데이타이다.
따라서 이 데이타는 정적이다
.
예를 들면,
WWW를 통해서 얻을 수 있는 정보는
기껏해야 HTML이라는
정적인 문서 데이타이다.
이러한 문제를 해결할 수 있는 방법으로서
동적이고 대화형인 자바가 각광받기 시작했다.
자바는 인터프리트 언어라는 특징으로
인해 중간코드 형태로 생성된 코드를 WWW를
통해 클라이언트에서 다운로드받아 수행하므로 동적인 정보를 처리할
수 있다. 이러한
강점으로 인해 자바는 인터넷 환경에 급속하게 확산되었다.
3.2 자바
언어의 탄생과 새로운 기회의 탄생
3.2.1 자
바
언어의 탄생
자바는 선 마이크로시스템즈에서 개발한
프로그래밍 언어이다. 자바가
탄생하기 까지 역사적 과정을 잠시 정리해보면 다음과 같다.
선소프트사의 엔지니어중 제임스 고슬링이
이끄는 한 그룹은 케이블TV처럼
일련의 하드웨어를 통합.제어하기
위한 언어를 필요로 했다. 이
언어는 이질적인 하드웨어들을 통합하기 위해 보다 작고 강력한 기능을
필요로 했다. 이
프로젝트의 코드이름이 바로 "그린"이다.
"그린" 프로젝트에서 요구하는 보다 작고 강력한 언어 만들기 위해 초기 PC들에 사용했던 UCSD 파스칼이라 불리는 언어를 부활시켰고 이식성이 높은 언어를 만들기 위해 작은 크기의 중간 코드(Intermediate Code)를 생성하는 언어를 디자인했다 . 실제 이 중간 코드는 어떤 컴퓨터에서든 정확한 해석기(Interpreter)만 있으면 실행된다는 장점을 가지고 있다.
그러나 선소프트사의 엔지니어로서 그들은
파스칼보다 C++언어에
기반을 두기 시작했다. 따라서
새로 디자인되는 언어는 기존의 절차적인 방법이 아니라 객체지향
방법을 지원하게 되었다. 제임스
고슬링은 이 언어를 "오크(Oak)"라
명명하였다. 이
후 오크는 자바라는 이름으로 재명명되었다.
왜냐하면 오크란 이름의 언어가
유닉스상에 이미 존재하고 있었기 때문이다.
1992년
그린 프로젝트의 결과로서 고도의 지능적인 원격제어를 제공하는 "*7"라
불리는 제품을 출시했다. 결과적으로는
어느 누구도 "*7"
에 대해 관심을 두지 않았다. 이후
그린 프로젝트팀은 그들의 관심사를 돌려 대화형 TV에
적용하려 하였다. 그러나
이것 역시 어느 누구의 관심도 끌지 못했다.
이후 그린 프로젝트팀은 그들이 개발한
기술을 팔기위해 2년이란
세월을 허비해야 했다.
인터넷 특히 WWW의
확산에 발맞추어 제임스 고슬링은 그들의 기술을 WWW부라우져에
적용한 핫자바란 부라우져를 1995년
5월
23
일
선월드95에서
선보였다.
이후 자바 기술은 넷스케이프2.0과
인터넷 익스플로어3.0에
내장되었고 IBM, 시멘틱,
볼랜트를 비롯한 많은 회사에
라이센스되었다.
현재 자바기술은 그 적용영역을 넓히기
위해 다른 시스템과의 연동에 중심을 두고있다.
데이타베이스 시스템과의 연동을
위한 JDBC(자바
DataBase Connectivity ) , 분산객체
시스템의 표준인 CORBA와의
연동, 자바RPC인
RMI(Remote Method Invocation),
자바 OLE인
Beans 등
다양한 기능들이 추가되고 있다.
3.2.2 자
바
언어의 특징
자바 개발자들의 말을 빌려 정의해 보면
자바는 다음과 같은 특징을 갖고 있다.
자바는
- 단순하며
- 객체지향 방법을 사용하고
- 분산되어 있으며
- 인터프리트되며
- 강건하고
- 안전하며
- 아키텍터 중립적이고
- 빠른 성능을 제공하며
- 다중 쓰레드 기능을 제공하는
-
다이나믹한
언어이다.
이러한 특징들을 자세히 살펴보면 다음과
같다.
1) 자바는 단순한 언어이다.
자바 언어는 앞서 언급한 것처럼 C++과
유사하게 디자인 되어 사용하기 쉽다.
따라서 기존의 C++사용자들은
몇가지 자바 언어가 갖고 있는 특징만 이해해도 쉽게 프로그램을 할
수 있다. 물론
복잡하고 어려운 프로그램시 자바 언어의 고급 기능을 알기 위해 많은
노력을 투자해야 한다. 구문
차원에서도 자바 언어가 쉽지만 자바는 기존의 C와
C++ 언어에서
발생하는 다음의 문제들을 해결하여 보다 쉽고 안전하게 프로그램을
할 수 있게 해준다.
- 포인터 연산의 제거
C나
C++ 프로그램을
작성할 때 가장 어렵고 신경쓰이는 부분이 바로 포인터를 조작하는
것이다. 적절한
곳에서 포인터에 메모리를 할당하고 다시 해제해야 한다.
만일 정확히 제어하지 못하면
프로그램은 수행 중 중단된다.
자바는 이러한 불편을 해소해주었다
.
왜냐하면 자바에서는 포인터란
것이 없기 때문이다.
- 메모리 해제 불필요
앞서 살펴본 것처럼 메소리 해제는 프로그래머에게
절대적으로 중요한 기술이다. 왜냐하면
한정된 시스템 자원하에서 원하는 작업을 원활히 수행하려면 사용한
메모리 등 시스템 자원을 적절히 해제해야 하기 때문이다.
자바는 이러한 문제를 해결했다
.
자바 프로그래머는 더 이상 사용한
메모리를 해제할 필요가 없다.
왜냐하면 자바에서는 자동적으로
더 이상 사용하지 않은 메모리는 자동적으로 해제하기 때문이다.
이를 "자동 쓰레기 수집
(Automatic
Garbage Collection)"이라고
한다.
- 구조체
,연
산자
중복, 다중상속
등 중복되고 혼돈을 일으키는 개념을 제거하고 프로그래머에게 보다
간단하고 강력한 라이브러리를 제공한다.
또한 자바는 모든 자바 함수를 215K
RAM만을 이용해서 인터프리트할
정도로 작고 단순하다.( 실제
기본 인터프리터와 클래스를 지원하는 데 40K
가 들고 여기에 표준 라이브러리와
쓰레드를 지원하는 데 175K가
소요된다.)
2)자바는 객체지향 언어이다.
자바는 객체지향 패러다임을 기본으로
한다. 따라서
자바는 객체지향 개념 중 다중상속이나 연산자 오버로딩같이 문제를
일으키는 일부 기술들을 제외하고 꼭 필요한 객체지향 개념만을 지원한다.
3) 자바 응용 프로그램은 분산될 수 있다.
자바는 초기 디자인서 부터 네트웍 환경을
고려하였다. 따라서
자바는 TCP, UDP등
기본 네트웍 라이브러리를 비롯하여 HTTP나
FTP같이
대부분의 인터넷 프로토콜을 지원한다.
따라서 사용자는 아주 손쉽게
분산 프로그램을 작성할 수 있다.
실제로 소켓을 이용하여 클라이언트와
서버의 연결부분을 작성하는 데 10여
줄로 충분하다.
자바는 보다 강건한 프로그램을 작성하기 위해 기존의 C++언어에서 발생하는 문제를 제거하고 새로운 기능을 추가하였다. 먼저 자바는 메모리에 문제가 생기는 것을 막기 위해 자신의 메모리를 영역을 갖고 직접 다룬다. 또한 자바는 데이타가 중복되거나 붕괴되는 것을 막기위해 진정한 배열을 구현했다. 뿐만 아니라 자바는 포인터를 제거하여 프로그램 실행중에 발생하는 런타임 오류를 제거했다.
그리고 자바는 강건한 프로그램을 위해 널 포인터를 검사하고 배열의 바운드를 검사하며 수행전에 바이트 코드를 검사한다. 또한 자바구문에 예외 상황(Exception)을 처리할 수 있는 기능을 추가하였다.
자바는 하드웨어에 상관없이 수행된다. 이를 위해 자바는 다음과 같은 특징을 갖는다.
다음 [그림5-30]은
자바의 실행 환경과 수행 과정을 보여준다.
먼저 프로그래머가 작성한 자바
코드는 자바 컴파일러에 의해서 중간 실행 형태인 바이트 코드를 생성해
낸다. 이
바이트 코드는 특정 하드웨어나 운영 체제에 의존하지 않고 이 코드를
해석하여 실행할 수 있는 인터프리터만 있으면 실행이 가능하다.
따라서 이 바이트 코드는 로컬
컴퓨터에서 자바 인터프리터를 통해 수행이 가능할 뿐만 아니라 WWW를
이용하여 인터넷상의 어느 곳에서든지 자바 인터프리터가 있는 곳에서
수행된다. 예를
들면, 넷스케이프나
인터넷 익스플로어를 통해 어느 곳에서든지 자바 프로그램을 수행할
수 있다.
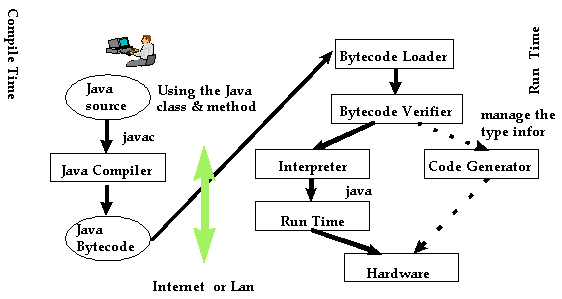
[
그림5-30
] 자바의 실행 환경
6) 자바는 안전하다.
자바는 언어측면에서 포인터나 형변환을 삭제하여 프로그램 수행 중에 발생하는 문제의 소지를 제거했다. 또한 자바 코드는 [ 그림5-30 ]에서 처럼 실제 실행하기 전에 안전성을 위해 바이트 코드에 대한 검사(Byte Code Verifier)를 하여 안전한 코드만 수행한다.
따라서 바이트 코드 검사를 통과한 코드는
- 스택 오버플로우나 스택 언더플로우의 원인이 되지않으며
- 매개변수의 타입이 정확하다. 그리고
- 비합법적인
형변환이 없다.
자바 언어는 네트웍 환경에서 수행되기
때문에 보안에 많은 문제를 안고 있다.
예를 들면,
네트웍상의 다른 곳에서 전송되어
온 자바 프로그램은 로컬 컴퓨터의 파일을 조작하거나 다른 컴퓨터에
연결되어 로컬 컴퓨터상의 정보를 전송한다면 보안상의 많은 문제를
일으킬 수 있다. 따라서
자바는 로컬 컴퓨터에 대해 조작을 가할 수 없다.
7) 자바는 다중 쓰레드를 제공한다.
다중 쓰레드란 한 프로그램내에서 여러
개의 쓰레드가 동시에 작업을 수행하는 것이다.
자바는 이러한 다중 쓰레드를
제공한다. 따라서
자바 다중쓰레딩은 하나의 자바 프로그램안에서 동시에 여러 작업들을
수행할 수 있게 해준다. 이러한
자바 다중 쓰레드는 자바를 대화형 프로그램이나 실시간 처리를 요하는
프로그램에 적합하게 해준다.
8) 자바는 동적이다.
자바는 런타임시까지 모듈들을 링크하지
않는다. 따라서
라이브러리가 변하더라도 영향을 받지 않는다.
결국 자바는 런타임시 모듈을
링크하므로 C++에서
처럼 상위 클래스이 명세가 변할 경우 모든 하위 클래스를 다시 컴파일해야
만 하는 문제를 일으키지 않는다.
일반적으로 C++에서의
이러한 문제를 "슈퍼클래스 문제"라 한다.
3.2.3 자
바
언어의 제약과 새로운 기회의 탄생
자바는 인터넷 환경에서 프로그래머들에게
보다 빠르고 적은 예산으로 시스템을 개발할 수 있는 기회를 제공할
뿐만 아니라 강력한 GUI기능과
더불어 보다 유연하고 이식성있는 프로그램을 작성할 수 있게 해준다.
그러나 자바 언어로 클라이언트/서버
방식의 프로그램을 작성하는 것은 생각보다 쉽지않다.
왜냐하면 자바 언어에서는 java.net
라이브러리에서 제공하는 저차원의
함수들만을 제공하기 때문이다.
결국 자바 언어로 클라이언트
/서
버
시스템 특히, 다양한
서버를 접근하는 다중 서버 구조의 시스템을 구성하려 한다면 각각의
서버를 조작하기 위한 클라이언트 코드를 작성해야만 한다.
( 오직 저차원의 네트웍 함수를
이용해서 ) 결국
이러한 방식은 초기 2단계
클라이언트/서버를
구성하는데서 발생하는 여러가지 문제들을 그대로 답습하는 것이다.
따라서 이러한 문제들을 해결하고자 하는
노력들이 여러 곳에서 경주되고 있다.
그 중에서 자바의 강력한 프로그래밍
기술에 응용 프로그램들간의 상호작동을 위한 표준화된 프레임웍으로
CORBA를
결합하는 방법이 가장 광범위하게 연구되고 있다.
특히 자바나 CORBA모두
객체지향 개념을 기반으로 하기 때문에 CORBA
IDL언어를 자바언어로 쉽게 변환할
수 있다.
현재 선소프트사에서는 CORBA IDL을 자바로 변환하기 위한 표준 명세를 발표했으며 이 명세에 기초하여 JOE라는 ORB를 개발.제공하고 있다. 또한 Orbix를 개발한 아이오나사는 OrbixWeb이라는 자바 연동 제품을 출시했으며 포스트 모던사의 블랙위도우(현재 비지브로커) 등 여러 회사에서 CORBA-자바 연동 제품을 개발하고 있다.
초기 WWW에서
외부 프로그램과 연동하는 방법은 [그림5-31]에서
처럼 HTTPD제공하는
CGI방법을
이용하는 것이다. 이
방법은 프로그래머에게 원하는 시스템을 빠르게 구축할 수 있게 해주지만
몇가지 심각한 문제점을 야기한다.
먼저 사용자와의 대화형 프로그램을
작성하기가 어렵다. 실제
WWW에서
사용가능한 대화방식은 HTML문서의
form을
이용하는 것이다. 따라서
극히 제한적인 대화형 프로그램만이 이용가능하다.
그리고 [그림5-31]의
방식에서는 외부의 프로그램을 수행하기 위해서 fork()나
exec()를
사용하여 WWW서버와
같은 규모의 프로세스를 생성해야 만 한다.
따라서 사용자의 요구가 발생할
때마다 새로운 연결이 맺어지고 프로세스를 생성하거나 미리 생성된
프로세스를 통해 해당 프로그램을 수행시킨 후 그 결과를 부라우져에게
반환한다. 이
과정에서 많은 통신상의 오버헤드와 많은 자원을 소모하고 CPU
계산상의 낭비를 가져오게 된다
.
그리고 가장 심각한 문제점은
이용하려는 외부의 시스템에 따라 각각 개별적인 프로그램을 작성해야
한다는 점이다.
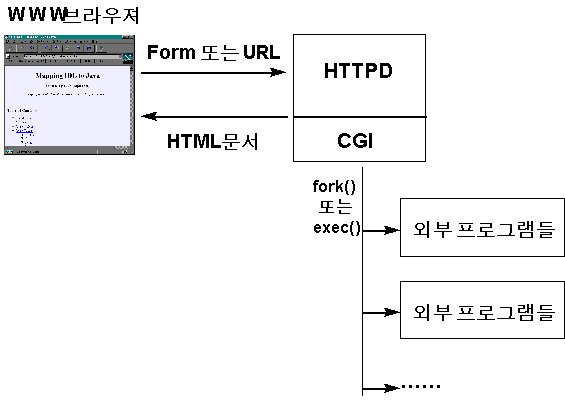
[
그림5-31
] 전통적인 CGI방식
이러한 문제들을 해결할 수 있는 방법이
바로 자바 프로그램을 이용하는 것이다.
[그림5-32]에서
처럼 자바로 작성된 클라이언트/서버
프로그램은 WWW상에서
많은 장점을 제공한다. 실제
사용자가 제출한 URL에
따라서 자바 애플릿 프로그램이 사용자의 부라우져를 통해 다운로드된다.
일단 자바 애플릿이 수행되면
더 이상 HTTPD와의
접촉은 필요없다. 왜냐하면
자바 애플릿이 직접 서버와 통신을 하기 때문이다.
따라서 앞선 CGI
방법에서 발생하는 문제를 해결할
수 있다. 그러나
한가지 남은 문제는 자바를 사용하더라도 이용하려는 외부의 시스템에
따라 각각 개별적인 프로그램을 작성해야 한다는 점이다.
예를 들어,
만약 5개의
외부 시스템을 이용하려면 5개의
자바 인터페이스 프로그램을 작성해야만 한다.
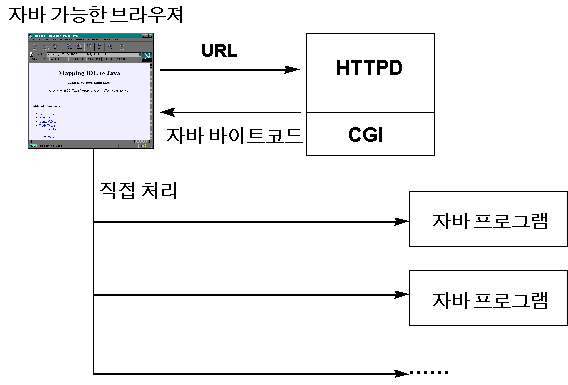
[
그림5-32
] 자바 클라이언트/서버
방식
앞선 두 방법에서 발생하는 문제에 대한
해결책으로 [그림5-33]과
같이 CORBA와
자바의 연동 시스템을 들 수 있다.
프로그래머는 CORBA를
사용하여 외부의 시스템들에 공통된 CORBA
인터페이스를 작성할 수 있다
.
이 CORBA
코드는 자바 코드로 변환되어
WWW를
통해 자유롭게 이용된다. 이때
별도의 외부의 시스템이 추가되더라도 프로그래머는 CORBA
인터페이스만 알고 있으면 쉽게
외부 시스템을 추가할 수 있다.
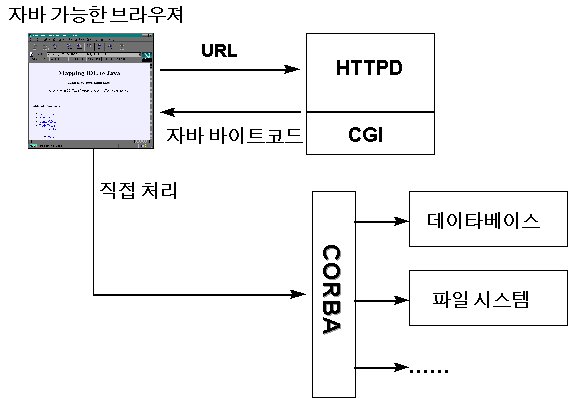
[
그림5-33
] CORBA-자바 연동시스템
3.3 CORBA-자바
매핑
CORBA-자바
매핑을 한마디로 정의하자면 CORBA
IDL언어를 자바언어로 매핑시키는
것이다. 물론
매핑이외에 ORB에서
제공하는 기능을 사용하기 위한 기본 자바 클래스들이 제공돼야 한다.
따라서 CORBA-자바
매핑을 이해하는 것은 CORBA의
IDL을
자바로 매핑하는 과정을 이해하는 것이라 말할 수 있다.
현재 CORBA-자바
매핑에 대한 안을 발표한 곳은 JEO라는
제품을 선보인 선소프트사와 OrbixWeb을
발표한 아이오나사가 있다. 물론
현재 CORBA표준안을
제정하고 있는 OMG에서도
CORBA-자바
매핑 표준안을 제정중에 있다.
특히 선소프트의 경우 CORBA-자바
매핑에 대한 공개 소프트웨어로 JIDL을
제공하고 있다. JIDL은
IDL로
작성된 프로그램을 자바 코드로 변환해주는 컴파일러로써 idlgen을
제공해준다.
idlgen은
현재 솔라리스2.x와
윈도우NT/95에서
수행된다. idlgen을
통해 여러분은 자바 클라이언트 스터브 코드를 얻을 수 있다.
이 때 생성된 스터브 코드는
복 수 개의 ORB프로토콜을
지원하기 위해 개발된 포터블 ORB
코아(Portable
ORB Core) 시스템상에서 수행된다
.
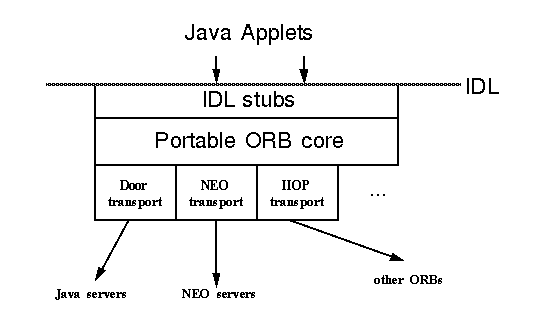
[
그림5-34
] 선소프트의 JIDL환경
3.3.1 CORBA-자바
매핑
다음은 OrbixWeb에서의
매핑 방법을 기본으로 하여 CORBA
IDL을 자바언어로 매핑 방법을
요약.정리한
것이다.
CORBA IDL 자바
float float
double double
long int
short short
unsigned long int
unsigned short short
char char
boolean boolean
octet byte
string class String
enum int
structure class
discriminated union class( 식별자와 해당 값으로 구성됨)
enumeration class(각각의
원소를 정적 변수로 처리)
Array Array
Sequence
class(버퍼와 길이 변수를 포함하고
있음)
Any CORBA.Any 클래스(타입과 값을 포함하고 있음)
module package
constant class(상수를
정적변수로 선언한 특별한 클래스)
interface interfece( 자바는 다중상속을 지원하지 않는대신
인터페이스 를 지원)
inheritance extends
object reference Ref interface
CORBA IDL
메소드는
in, out, inout 매개변수를
갖는다. 이때
inout,out을
처리하기 위해 특별한 방법을 필요로 한다.
왜냐하면 자바는 참조에 의한
전달방법을 지원하지 않기 때문이다.
따라서 각 데이타 타입을 전달하기
위해 Holder라는
특별한 클래스를 생성하여 매개변수를 전달한다.
이 클래스에는 해당 매개변수의
타입과 값이 들어있다. 예를
들면, int의
경우 intHolder가
long의
경우 longHolder가
inout과
out
매개변수로
대체된다.
attribute attribute(), attribute(
value) ( 2개의 메소드로 매핑
)
자바는 C++의
typedef같이
언어를 추가하는 기능이 없다.
따라서 자바는 이를 상속관계를
통해 처리한다. 단
int, char같은
단순한 데이타 타입은 처리할 수 없다.
typedef extends
raises throws
3.3.2 CORBA-자바
제품들
현재 CORBA-자바
연동 제품들은 아주 광범위하게 개발되고 있다.
이들에 대한 소개는 다음 장에서
하고 여기서는 상용 제품만을 간략히 소개하도록 한다.
3.3.2.1 선
소프트의
NEO , JOE
선소프트사는 OMG의
초기 멤버로서 CORBA표준을
만드는 데 있어 많은 기여를 한 회사이다.
실제 CORBA의
IDL은
선소프트에 의해서 주도적으로 작성된 언어이다.
이렇듯 분산객체 시스템과 이를
기반으로 한 환경에 많은 관심을 가져왔다.
그 구체적인 실행 방안으로 DOE(Distributed
Object Environment)라는 프로젝트를
추진하였다. 이
프로젝트는 CORBA를
근간으로 한 시스템을 구축하는 데 주안점이 있었다.
이후 이 프로젝트는 NEO라는
프로젝트로 바뀌게 되었다.
NEO는
한마디로 사용자(기업
또는 단체,...)가
급속하게 변하는 전산환경이나 기타 요구사항에 능동적으로 대처하여
경쟁력을 갖출 수 있도록 해주는 일련의 소프트웨어를 의미한다.
이러한 목적을 달성하기 위해
NEO는
네트웍 기능을 가진 객체를 기반으로 하여 기업에서 사용하는 툴의
종류에 무관하게 각종 서비스를 공유하게 해준다.
이를 선소프트는 "공유 서비스
(Shared
Service)"라고 말한다.
이러한 기능을 제공하기 위해
NEO는
다음의 소프트웨어를 포함하고 있다.
솔라리스NEO는
CORBA에
근거한 객체 네트웍 인프라 구조를 제공하며 네트웍 객체 관리도구로서
솔스틱스(Solstice NEO) NEO를
번들로 포함하고 있다.
웍샵은 기존의 제품을 NEO에
적합하게 확장한 제품으로 C,C++
컴파일을 위한 스팍 컴파일러와
개발 도구 모음인 스팍웍스, 네트웍
객체개발을 위해 IDL컴파일러와
네트웍 객체 디버거를 포함하고 있는 NEO웍스로
구성되어 있다.
JOE(Java Object Environment)는
CORBA와
자바를 연동하는 방법을 제공하는 선소프트의 열쇠이다.
다시 말해 JOE는
IDL자바
컴파일러와 ORB, 그리고
NEO에
대한 API로
구성되어 있다. 따라서
JOE로
개발된 자바 애플릿은 원격지의 NEO객체에
연결되어 다양한 서비스를 이용할 수 있다.
간략하게 JOE에서
제공하는 기능들에 대해 살펴보도록 한다.
마지막으로 현재 NEO나
JOE를
이용하려면 솔라이스2.4 이상
버전을 이용해야 한다. 따라서
윈도우 객체에 대한 접근이나 이용 기술은 현재 아이오나사의 OrbixOLE를
이용하길 권장하고 있다. 아마
이러한 방법은 솔라리스 근간 기술은 선소프트사에서 이외 플렛폼과의
연결은 Orbix을
통해서라는 선소프트사의 전략에서 기인하는 것 같다.
3.3.2.2 아
이오나사의
OrbixWeb 2.2
아이오나사의 OrbixWeb은
기존의 Orbix 제품의
자바 매핑 버전이다. 따라서
Orbix에서
제공하는 모든 기능을 자바로 이용할 수 있다.
현재 OrbixWeb에서
사용하는 IDL자바
매핑방법은 선에서 제공하는 방식이 아니라 고유한 매핑 방법을 사용하고
있다. 그러나
선의 자바 매핑안과 상당히 유사하며 앞으로 OMG의
IDL자바
매핑안을 따를 것이다.
OrbixWeb에
서
제공하는 기능을 간략히 정리해 보면 다음과 같다.
위의 기능 중 필터기능은 객체를 호출하는
과정에 원하는 기능을 추가하는 것을 말한다.
가령,
특정 서비스 객체에 접근할 때마다
과금을 매기는 기능의 필터를 추가할 수 있다.
이러한 기술을 각종 보안 기능
등에 응용할 수도 있다. 현재
OrbixWeb은
솔라리스와 윈도우95/NT에서
이용가능하며 인터넷상에서 무료로 이용할 수 있다.
.
3.3.2.3 비
지제닉사의
비지브로커
비지브로커는 전에 블랙위도우라는CORBA-자바
연동 제품을 가장 먼저 선보인 포스트모던사를 인수한 비지제닉사가
발표한 제품으로서 IIOP를
기본 프로토콜로 사용하며 CORBA
표준에서 명시한 기능을 제공할
뿐만 아니라 "값에 의한 전달" 방식 등 자바 언어의 장점들을
다양하게 제공하고 있다. 현재
비지브로커는 선의 IDL-자바
매핑안을 따르고 있다.
특히,
비지브로커는 IDL을
작성하지 않고도 CORBA-자바
프로그램을 작성할 수 있는 카페인(Caffeine)이라는
환경을 제공한다. 카페인을
사용하면 CORBA IDL을
모르더라도 프로그램을 작성할 수 있다.
특히,
카페인은 넷스케이프사의 개발
환경에 포함되어 널리 사용되고 있다.
비지브로커에 대한 보다 자세한
내용은 다음 절의 내용을 참조하기 바란다.
[ 그림
5-35
] JIDL과 Orbix을
통해 작성된 CORBA-자바
프로그램
3.4 CORBA-자바
프로그램 작성 예
3.4.1환경 구축
다음은 비지브로커 제품의 환경 구축
과정이다. 설치
환경은 윈도우95이
고
평가 버전을 이용한다고 가정한다.
[단계1]
먼저 비지브로커의 설치 소프트웨어를
인터넷상에서 다운로드 받고 라이센스를 신청한다.
(http://www.visigenic.com)
[단계2]
해당 프로그램(VisiJava_12_win.ZIP)을
풀고 setup.exe를
수행한다. 설치된
디렉토리밑에 adm
이란
디렉토리에 라이센스(license.dat)파일을
작성한다. 가령
,
c:\orb20이란 디렉토리에 설치했다면
license.dat은
다음에 위치한다.
c:\orb20\adm\license.dat.
license.dat에 기록해야
할 정보인 체크섬(Checksum)은
전자우편을 통해 전달받는다. 전달받은
체크섬 정보는 다음과 같이 license.dat 파일에
적는다.
Product Name: Orbeline2.0
Host id: 0
Num Units: 0
Expiration Time: 04/18/1997
Checksum: 1251-0101-0610-1112
[단계3]
다음은 비지브로커의 작동에 필요한
환경을 설정해야 한다. 먼저
경로(PATH)를
설정하고 ORBLINE이라는
환경 변수를 통해 설치된 디렉토리하의 adm 경로를
명시해 준다. 마지
막으로는
비지브로커에서 사용하는 자바 라이브러리 경로를 추가한다(CLASSPATH).
최종적으로 설정되는 환경 변수들은
다음과 같다.
set PATH = C:\ORB20\bin
set ORBLINE = C:\ORB20\ADM
set CLASSPATH=,;C:\ORB20\CLASSES;C:\JAVA\LIB\CLASSES.ZIP
[단계4]
모든 설정을 마친 후에 비지브로커
데몬을 수행해 본다. 비지브로커
데몬 프로그램은 osagent.exe이다.
백그라운드로 수행시킨다.
osagent는 클라이언트의 요청을
받은 후 해당 구현 객체에 연결해 주는 역할을 수행한다.
따라서 적어도 하나의 osagent가
수행하고 있어야 한다.
osagent &
[단계5] 데모 디렉토리에 있는 임의의 구현 객체를 수행한 후, 이상이 없으면 클라이언트를 수행해 본다. 이 때 만약 클라이언트가 자바 애플릿이라면 수행하기 전에 gatekeeper 라는 프로그램을 수행해야 한다 . getekeeper는 HTTP를 통해 비지브로커 서버를 호출하게 해주는 HTTP-to-IIOP 게이트웨이이다. gatekeeper가 제대로 수행되지 않으면 애플릿 형태의 클라이언트는 수행되지 않는다. gatekeeper 수행시 가장 빈번히 발생하는 것은 UnknownHost Exceprion이다. 이 경우, 실제 자바의 라이브러리(getHostByName)의 오류인데 로컬 호스트의 도메인 이름과 DNS 서버상의 도메인이름의 틀린 경우이다. 따라서 DNS 서버에서 제공하는 도메인 이름으로 설정을 바꾸면 제대로 수행할 수 있다. 만약 무사히 수행된다면 설치는 성공리에 끝난 것이다. ( 해당 구현 객체와 클라이언트를 수행하지 못했다면 다음 절에서 설명하는 과정에 따라 수행하면 된다. )
3.4.2 프로그램
개발 과정의 이해
앞서 무사히 설치를 마쳤다면 다음의
과정에 따라 응용 프로그램을 작성해 본다. 편의상
예제로서 설치 후 예제 디렉토리에 복사되는 bank
예제를 사용하기로 한다.
문제 내용
클라이언트는 원하는 계정(Account)에 대한 잔액을 조회하기 위해 구현 객체에게
서비스를 요청한다. 서비스를 요청받은 구현 객체는 해당 계정의 잔액을 반환한다.
만약 해당 계정이 존재하지 않으면 클라이언트가 요청한 이름의 계정을 생성하고
임의의 잔액을 발생시킨 후 반환한다.
[단계1]
bank 객체에 대한 IDL
파일을 작성한다.
실제 예는 다음과 같다. bank 객체는 Bank라는 모듈내에 두개의 인터페이스로 구성된다. 하나는 해당 계정의 잔액을 알려주는balance() 메소드를 갖는 Account 이 고 다른 하나는 특정 소유주의 이름을 받고 해당 계정을 개방한 후 임의의 계정 잔액을 반환하는 open() 메소드를 갖는 AccountManager 클래스이다. open() 메소드의 전달인자는 String 형태로 클라이언트에서 구현 객체로만 전달되기 때문에 in을 사용하였다.
// Bank.idl
module Bank {
interface Account {
float balance();
};
interface AccountManager {
Account open(in string name);
};
};
[단계2]
해당 IDL
파일을 컴파일한다.
C:/> idl2java Bank.idl
컴파일 후,
현재
디렉토리하에 Bank라는
이름의 디렉토리와 다수의 파일들이 생성된다.
각 파일들이 의미하는 것은 다음과
같다.
| _st_Account.java | Account의 스터브 코드 |
| _st_AccountManager.java | AccountManager의 스터브 코드 |
| Account_var.java | 클라이언트측의 Account가 서버쪽을 호출할 수 있도록 해주는 bind()메소드와 매개변수들 |
| AccountManager_var.java | 클라이언트측의 AccountManager가 서버쪽을 호출할 수 있도록 해주는 bind()메소드와 매개변수들 |
| _sk_Account.java | Account의 스켈로턴 코드 |
| _sk_AccountManager.java | AccountManager의 스켈로턴 코드 |
| _example_Account.java | Account 구현을 위한 템플릿 코드 |
| _example.AccountManager.java | AccountManager 구현을 위한 템플릿 코드 |
| Account.java | Account 인터페이스 파일 |
| AccountManager.java | AccountManager 인터페이스 파일 |
[단계3]
_example_Account.java와
_example.AccountManager.java를
이용하여 서버쪽 구현 객체를 작성한다.
볼드체 부분에 원하는 응용 프로그램의
로직을 작성하고 해당 구현 객체를 생성하고 이를 ORB에
등록하기 위한 main()함수를
작성한다. 참고로
예제 코드에서 볼드체 부분은 사용자가 작성한 부분이다.
//_example_Account.java
package Bank;
public class _example_Account extends Bank._sk_Account {
/** Construct a persistently named object. */
public _example_Account(java.lang.String name) {
super(name);
}
/** Construct a transient object. */
public _example_Account() {
super();
}
public float balance() throws CORBA.SystemException {
// 이곳에 사용자의 로직을 작성한다.
}
}
//_example_AccountManager.java
package Bank;
public class _example_AccountManager extends Bank._sk_AccountManager {
/** Construct a persistently named object. */
public _example_AccountManager(java.lang.String name) {
super(name);
}
/** Construct a transient object. */
public _example_AccountManager() {
super();
}
public Bank.Account open(
java.lang.String name
) throws
CORBA.SystemException {
// 이곳에 사용자의 로직을 작성한다.
}
}
실제 작성된 코드는 다음과 같다.
//Server.java
import java.util.*;
class Account extends Bank._sk_Account {
Account(float balance) {
_balance = balance;
}
public float balance() throws CORBA.SystemException {
return _balance;
}
private float _balance;
}
class AccountManager extends Bank._sk_AccountManager {
AccountManager(String name) {
super(name);
}
public Bank.Account open(String name) throws CORBA.SystemException {
// 계정 Dictionary에서 해당 계정을 얻어 온다.
Bank.Account account = (Bank.Account) _accounts.get(name);
if(account == null) {
// 0 과 1000달러 사이의 계정을 생성한다.
float balance = Math.abs(_random.nextInt()) % 100000 / 100f;
account = new Account(balance);
System.out.println("Created " + name + "'s account: " + account);
// 새로운 객체 참조자를 얻어온다.
_boa().obj_is_ready(account);
// 계정 목록에 해당 계정을 저장한다.
_accounts.put(name, account);
}
// 계정을 반환한다.
return account;
}
private Dictionary _accounts = new Hashtable();
private Random _random = new Random();
}
public class Server {
public static void main(String[] args) {
try {
// ORB를 초기화 시킨다.
CORBA.ORB orb = CORBA.ORB.init();
// BOA를 초기화 시킨다.
CORBA.BOA boa = orb.BOA_init();
// account manager 객체를 생성한다.
AccountManager manager =
new AccountManager("CORBA Bank");
// 새롭게 생성된 객체를 BOA에 등록한다.
//지금부터 사용준 비가 된 셈이다.
boa.obj_is_ready(manager);
System.out.println(manager + " is ready.");
//클라이언트의 요청을 기다린다.
boa.impl_is_ready();
}
catch(CORBA.SystemException e) {
System.err.println(e);
}
}
}
[단계4] 클라이언트 코드를 작성한다.
// Client.java
public class Client {
public static void main(String args[]) {
try {
// ORB를 초기화 시킨다.
CORBA.ORB orb = CORBA.ORB.init();
// 서 버 account manager 객체에 대한 객체 참조자를 얻어온다.
Bank.AccountManager manager =
Bank.AccountManager_var.bind("CORBA Bank");
// 디 폴트 사용자 이름이나 args[0]를 계정 이름으로 설정한다.
String name = args.length > 0 ? args[0] : "Jirubak";
// 해 당 계정이름의 계정을 열라고 요청한다
Bank.Account account = manager.open(name);
// 계 정의 잔액을 얻어온다.
float balance = account.balance();
// 잔 액을 출력한다.
System.out.println ("The balance in " + name + "'s account is' + balance);
}
catch(CORBA.SystemException e) {
System.err.println(e);
}
}
}
[단계5]
작성된 클라이언트와 서버 코드를
컴파일한다.
C:/> javac Client.java -> Client.class 생성
C:/> javac Server.java -> Server.class
생성
[단계6]
먼저 osagent라는
비지브로커 데몬을 수행시킨다.
osagent는 클라이언트와
구현 객체사이의 위치 서비스를 제공한다. 따라서
LAN환경에
적어도 하나의 osagent가
수행되어야 한다.
C:/> start osagent
다음으로 구현 객체를 수행시킨다.
C:/> start java Server
예제에서는 osagent와
구현 객체를 서로 다른 프로세스상에서 수행하기 위해 start
명령어를 사용하였다.
[단계7]
다른 윈도우를 생성한 후,
클라이언트 프로그램을 수행한다
.
C:/> java Client
만약 별도의 전달인자가 없다면 다음과
같은 결과를 생성해 낸다.
The balance in jirubak's account is $73.17
만약 전달인자로 younghan을
사용하면 다음과 같은 결과를 생성해 낸다.
The balance in younghan's account is $11.17
마지막으로 주의 할 점은 앞서 설명한
것처럼 클라이언트가 자바 애플릿인 경우 반드시 실행하기 전에 osagent와gatetkeeper(IIOP
GeteKeeper)라는 프로그램을 수행해야
한다는 사실이다. gatekeeper는
HTTP 터널링을
통해 방화벽 내에 있는 구현 객체들과 통신하게 해준다.
다시 말해 getekeeper는
클라이언트 애플릿이 다운로드된 호스트외에 다른 곳에 위치한 구현
객체들과 통신하게 해준다.
4장
개발자들의 희망, CORBA
+ WWW + JAVA
4.1 새로운 패러다 임의 출현인가 기존 패러다임의 진화인가?
구조적 방법론과 개발론을 기반으로 과거의
소프트웨어 업계는 "소프트웨어의
위기(Software crisis)"라는
말처럼 수많은 자가당착적 오류에 빠져버렸었다.
기업의 시스템 프레임웍이 중앙집중식에서
클라이언트/서버
구조로 전환되고 이종의 하드웨어와 운영 체제,
네트웍 환경 그리고 이종의 데이타베이스들이
산적해 있는 상황에서 소프트웨어 개발자들은 다양한 요구 사항에
직면했다. 먼저
보다 높은 생산성과 신뢰성, 효율성
그리고 환경 변화에 적절히 규모 조정할 수 있는 소프트웨어를 개발해야
했으며 개발된 소프트웨어는 유지.보수가
쉬워야 했고 이를 위해 가능한 한 단순하게 설계.구현해야만
했다.
이러한 문제점을 극복하고자 출현한 해결방안이
바로 객체지향(Object-Oriented)이라는
새로운 패러다임이었다. 이
패러다임은 실세계의 모든 문제를 속성과 함수로 포장되는 객체로
선언하고 상속 관계나 포함 관계처럼 이들 객체사이의 연관 관계를
지정함으로서 가능한 한 문제를 추상화시키고 이들 문제간의 물리적
연관성을 줄여주었다. 따라서
기존의 구조적 방법론이 줄 수 없었던 많은 기능들을 이용할 수 있었다.
이러한 객체지향 패러다임의
구체적 방법들에는 OMT 같은
객체지향 분석과 객체지향 디자인, C++나
자바같은 객체지향 언어, ObjectStore나
O2같은 객체지향
데이타베이스 등이 있으며 실제 많은 제품들이 사용중에 있다.
이러한 상황하에서 단기간에 급속히 성장한
인터넷은 "네
트웍이
컴퓨터"라는
말을 컴퓨터 업계를 표현하는 대명사로 만든 것처럼 많은 분야에 영향을
주었다. 물론
이중에서 가장 많은 영향을 받은 분야는 소프트웨어 분야이다.
수 많은 소프트웨어와 벤처 기업이
폭발적으로 등장했으며 사라지기도 했다. 이
중에서 가장 두드리진 것이 바로 WWW의
급속한 확산이다.
이제
모든 컴퓨터에는 WWW 클라이언트인
부라우져가 적어도 하나씩은 설치되어 있으며 이를 통해 다양한 부가
서비스를 이용하고 있다. "부라우져가
운영 체제"
또는
"운영
체제가 부라우져"라는
말은 결코 과장된 표현은 아닐 것이다.
WWW의 확산은 마침내
정보 시스템 분야에 까지 불어와 기존의 정보 시스템을 WWW상에
연동시켜 WWW
부라우져를
통해 인터넷이 연결되어 있는 곳은 어디서나 이용할 수 있게 되었다.
물론 새롭게 개발되는 시스템은
WWW 기반하에서
WWW의 프로토콜
인
HTTP(Hyper Text Transfer Protocol)와
WWW의 멀티미디
어
문서인 HTML(Hyper Text Markup Language)
그리고
WWW의 외부
연동 방법인 CGI(Common Gateway Interface),
전자 우편이나 전자 게시판 처럼
이미 개발되어 있는 인터넷 서비스들을 기반으로 한다.
이러한 환경을 인트라넷이라고
한다.
그러나 WWW상의 클라이언트와 서버는 계속 상태를 유지하면서 정보를 교환할 수 없으며 부라우져는 단순히 HTML 문서를 표현해 주기 때문에 동적인 사용자 인터페이스와 지속적인 상태정보를 요구하는 정보 시스템을 구축할 때 많은 문제가 발생한다. 이러한 문제를 해결하고자 등장한 기술이 바로 선마이크로시스템즈의 객체지향 인터프리트 언어인 자바이다. 자바 언어는 객체지향 개념을 지원하며 바이너리 코드가 아니라 중간 코드 형태의 바이트 코드를 생성해내기 때문에 해당 바이트 코드를 해석하는 컴파일러가 있는 곳이면 어디서나 실행될 수 있는 구조를 가지고 있다. 이러한 구조를 적극 활용하여 자바 인터프리터를 WWW 부라우져에 삽입하고 자바 응용 프로그램을 부라우져에서 실행시킴으로서 정적인 WWW에 동적인 기능을 불어넣고 클라이언트와 서버 사이의 상태정보를 유지할 수 있게 해주었다.
WWW 를 중심으로
한 인터넷과 자바 못지않게 또 하나의 중요한 환경 변화가 바로 분산
환경이다. 네트웍
의
확산과 아울러 기존의 클라이언트/서버
환경을 보다 적극적으로 발전시켜 여러 시스템을 지리적으로 분산되어
있는 곳에 분산시켜 각기 독립적인 기능을 수행하거나 필요시 협력하는
분산 시스템이 보편화되기 시작했다. 이러한
분산 시스템은 초기 소켓이나 RPC ( Remote Procedure
Call)같은 하위 수준의 네트웍
기능을 이용하여 개발되었으나 이후 DCE(Distributed
Computing Environment)같은 통합
분산 환경을 통해 개발되었다. 그러나
기존의 이러한 방법은 분산 환경하에서 다양한 하드웨어와 응용 소프트웨어
,
운영 체제,
데이타베이스 등을 일관되게 연결해주지
못했다. 따라서
앞서 언급한 것처럼 새로운 환경에 적합한 해결책을 제시해 주지 못한
것이었다. 이러한
상황을 해결하고자 나온 방법이 바로 OMG(Object
Management Group)의 CORBA(Common
Object Request Broker)이다.
CORBA는 구현 언어나 개발 환경이라기
보다는 객체 기술에 근거한 통합 기술이다. 따라서
실제 구현된, 또는
구현되는 언어에 상관없이 각 시스템들을 연결.통합할
수 있는 방법을 제공한다.
지금까지 많은 개발자들은 각종 시스템
구축시 기본 환경으로서 WWW를,
WWW 환경하에서 동적인 시스템을
구축하기 위한 개발 언어로서 자바를, 이종의
다양한 시스템을 통합하기 위한 중간 기술로서 CORBA를
각기 따로 사용해 왔다. 그러나
현재 많은 곳에서 자바와 CORBA의
기능을 통합하여 시스템을 구축하고 있으며 통합된 시스템 또한 상당수
존재한다. 그렇다
면
당연히 여러분은 왜 자바와 WWW, CORBA를
통합하는 지 그 이유에 대해 궁금해질 것이다.
그 궁금증은 다음 절에서 풀어보도록
한다. 여기서는
간단히 개념에 대해서만 살펴보자. Robert
Orfali와
Dan Harkey의
책인 "Client/Server Programming with
Java and CORBA"라는 책에서
자바와 CORBA에
대해서 다음과 같이 표현했다.
"Java is the first step toword creating an Object Web, but it is
still not enough. Java offers tremendous flexibility for distributed
application development, but it currently does not support a client/
server paradigm. To do this, Java needs to be augmented with a
distributed object infrastructure, which is where OMG's CORBA
comes into the picture. CORBA provides the missing link between
the Java portable application environment and the world of intergalactic
back-end services. The intersection of Java and CORBA object
technologies is the natural next step in the evolution of the
Object Web"
그들은 자바가 제공하는 유연성(flexibility)과
이식성(portability), CORBA가
제공하는 분산 객체 인프라를 결합함으로써 인터넷 환경하에서 WWW서버를
포함한 다양한 서버들과 자바의 이식성있는 코드를 기반으로 한 클라이언트를
구축할 수 있다고 보았다. 아울러
자바와 CORBA의
통합 환경을 Object Web이란
용어로 표현했다.
이들의
기술적 견해는 정확한 것이며 현재 수 많은 곳에서 Object
Web 환경하에서 시스템을 개발하고
있다.
지금까지 과거부터 지금까지의 기술적
전환 과정을 살펴보았다. 지금까지의
내용을 정리하면 [
그림5-36]과
같다. 여기서
중요한 것은 초기 구조적 방법론에서 객체지향 방법론으로의 전환은
분명히 과거의 낡은 패러다임을 버리고 새로운 패러다임으로 전환한
것이다. 그러나
객체지향 패러다임하에서 WWW환경과
자바 객체지향 언어, CORBA 분산
객체 시스템은 새로운 패러다임이 아니라 현재의 기술을 기반으로
상승효과를 얻자는 데 있다. 한마디로
현재 패러다임하에서의 진화이다. 다음
절에서 보다 자세히 Object Web으로의
진화에 대해 살펴보자.
[ 그림5-36
] 패러다임의 전이
4.2 CORBA + 자바
+WWW = Object Web
4.2.1 Object Web
자바는 완전한 또하나의 객체지향 프로그래밍
언어이다. 따라서
자바를 통해 클래스나 상속 등 다양한 객체지향 패러다임에 준하는
시스템을 개발할 수 있다. 자바가
갖는 프로그램적인 명세외에 자바는 인터프리터 언어로서 운영 체제에
상관없이 수행할 수 있다는 장점을 제공한다.(물론
속도가 느리다는 단점도 안고 있다.) 일단
작성된 자바 코드는 컴파일러에 의해서 자바 바이트 코드로 변환된다.
이 코드는 로컬 컴퓨터나 네트웍을
경유하여 다른 지점에 위치한 컴퓨터상에게 전달된다.
전달받은 자바 코드는 먼저 바이트
코드 로더에 의해서 로드되고 바이트 코드 검사기에 위해서 검사된
후 인터프리터를 통해 수행된다. 따라서
윈도우건 유닉스건 상관없이 바이트 코드를 수행하기 위한 환경이
있는 곳이면 어디서나 수행될 수 있다. 특히,
자바 수행환경을 내장하고 있는
WWW 부라우져는
인터넷상의 어디서나 자바 코드를 수행하게 해 준다.
바로 이 기능으로 인해 자바는
정적인 WWW환경
에
동적인 생명력을 불어넣었으며 많은 개발자들은 운영 체제에 상관없이
개발된 코드를 어디서나 수행할 수 있다는 득을 볼 수 있다.
그러나 자바가 제공하는 수행 환경상의
장점에도 불구하고 자바는 대규모의 시스템을 개발하는 데에는 많은
문제점을 내포하고 있었다. 가령,
데이타베이스에 대한 연결기능이나
기존의 리거시 시스템에 대한 연동기능 등...
따라서 선소프트사는 이러한 환경을
구축하고자 많은 노력을 기울였다. 그
결과 선소프트사는 자바 엔터프라이즈라는 자바 개발 프레임웍을 발표했다
.
다음의 [그림5-37]은
바이트지의 97년
8월호 커버스토리
를
장식한 글인 "Web Component"
라는 글에서 소개한 자바 엔터프라이즈 구조이다(http://www.byte.com/art/9708/sec5/art1.htm).
자바 엔터프라이즈 구조는 WWW환경하에서
엔터프라이즈 규모의 응용 시스템을 개발할 때 필요한 자바 기술들의
빌딩 블럭을 나타낸다.
[ 그림
5-37 ] 자바
엔터프라이즈 개발 프레임웍
각각의 빌딩 블럭들을 설명하는 것은
본 글의 목적이 아니기 때문에 참고문헌을 통해 이해하기 바란다.
그러나 한가지 눈에 뛰는 점은
자바 엔터프라이즈 개발 프레임웍에서 클라이언트와 서버사이의 통신
프로토콜로서 IIOP
를
지원하다는 점이다. 이
말은 IIOP를
이용하면 자바로 개발된 클라이언트가 다른 언어로 작성된 서버를
이용할 수 있다라는 의미를 포함하고 있다. 실제
[그림
5-37]의
구조는 앞으로 설명하게 될 Object Web에
대한 밑그림을 제시한다고 말할 수 있다. 그러나
자바가 제공하는 많은 장점들에도 불구하고 아직 해결해야 할 많은
문제점들이 있다.
먼저,
자바가 진정한 개발 언어가 되기
위해서는 높은 성능과 빠른 수행 속도를 보장해야 한다.
또한 기존의 리거시 시스템을
손쉽게 연동하기 위한 기능을 제공해야 한다.
대부분의 엔터프라이즈 시스템들은
빠른 성능을 요구하는 한편 기존의 개발된 리거시 시스템들을 적극
활용해야 하기 때문이다. 정리하자면,
자바는 객체지향 개발 언어로서
출발했으면 개발 언어 그 이상은 아니다. 따라서
엔터프라이즈 솔루션을 제공하기 위해서는 보다 고도의 시스템 통합
기능을 지원해야 한다. 바로
이 점이 자바가 CORBA와의
통합을 통해 얻고자 있는 기능이기도 한다.
앞서 정리한 것처럼 CORBA와
자바는 각기 시스템 통합 기술로서, 개발
언어로서 출발하였다. 그러나
인터넷, 인트라넷
이
보편화된 환경하에서 CORBA는
자바의 모빌 코드 기능과 웹 부라우져에 플러그-인할
수 있는 자바 클라이언트를 수용할 수 밖에 없었고 자바 언어는 CORBA를
통해 표준 시스템 통합 기술을 확보할 수 있었다.
이 기술을 Object
Web 이라고 표현한다.
[ 그림5-38
] Object Web의 구조
Object Web은
[그림
5-38]에서
처럼 기존의 CORBA의
IDL언어를
자바 언어로 변환하고 기존의 WWW환경에서
클라이언트와 서버 사이의 통신은 IIOP(Internet
Inter ORB Protocol)를 사용하는
것이다. IDL은
본래 구현 언어 중립의 인터페이스 정의어이다.
따라서 해당 인터페이스를 자바로
변환하는 과정이 필요하다. 이
과정은 CORBA 에
서
자동적으로 제공한다. 또한
Object Web의
클라이언트와 서버는 WWW상에서
웹의 프로토콜인 HTTP(Hyper Text Transfer
Protocol)를 사용하기 않고 CORBA가
제공하는 객체간 통신 프로토콜인 IIOP를
통해서 작동한다.
현재, Object
Web의
구축 환경은 기존의 WWW환경과
동일하다. 단지
다른 점은 CORBA IIOP를
지원하는 웹 부라우져와 CORBA와
연동가능한 웹서버에 있다. 일단
Object Web을
통해 개발된 클라이언트 프로그램은 CORBA
IIOP를
지원하는 웹 부라우져에 HTTP를
통해 다운로드된다. 다운로드된
프로그램은 IIOP를
통해 CORBA와의
서비스를 개시하게 된다. 이
때 유의할 점은 다운로드된 프로그램 역시 자바 애플릿이기 때문에
자바 애플릿이 갖고 있는 보안상의 제약, 특히
다운로드 받은 호스트에만 연결을 설정할 수 있는 제약에 지배된다.
따라서 기본적으로 다운로드된
WWW서버를
통해 서비스 연결을 시도한다. 결국
WWW서버는
클라이언트가 요청한 서비스를 네트웍상의 다른 곳에 위치한 CORBA에게
전달하기 위한 방법을 갖고 있어야 한다. Object
Web 환경은 CORBA
서비스 외에도 기존의 웹서비스가
제공하고 있는 CGI 인터페이스와
HTML 문서
서비스를 여전히 제공한다. 현재
넷스케이프4.0에
내장된 CORBA IIOP 기능을
통해 Object Web
서비스를
이용할 수 있다.
4.2.2 CORBA,자바
,WWW
의 연동 노력
4.2.2.1 Object Web의
개발 노력들
현재 Object Web
환경을 지원하는 많은 CORBA
제품들이 소개되고 있다.
다음은 해당 제품들이다.
이 중에서 주목할 만한 제품으로는
넷스케이프사와 볼랜드 등에서 CORBA IIOP
기능을
지원하기 위해 라이센스한 제품으로 비지제닉사의 비지브로커와 가장
많은 플랫폼과 다양한 CORBA 서비스를
제공하는 Orbix와
선소프트사의 JOE
가
있다.
OrbixWeb http://www.iona.com
Visibroker for Java http://www.visigenic.com
JOE http://www.sunsoft.com
CHORUS/COOL http://www.chorus.com/Products/Cool/index.html
JacORB http://www.inf.fu-berlin.de/~brose/jacorb
Julu http://Coho.stanford.EDU/~hassan/Jylu
ELECTRA http://www.olsen.ch/~maffeis/electra.html
Omnibroker http://www.ooc.com/ob.html
Jade http://pariah.ansa.co.uk:8080/~jade/
DOME http://www.realobj.demon.co.kuk/
JORBA http://www.progsoc.uts.edu.au/~raz/jorba/
Java IDL http://splash.javasoft.com/JavaIDL/pages/index.html
4.1.2.2 Object Web 을
위한 표준화 노력
과거 자바와 CORBA의
장점을 결합하려는 시도는 주로 학교나 기업의 연구기관에서 많이
진행되어 왔었다.
그러나
현재 Object Web
의
진보된 방법론이 대두되면서 본격적으로 자바와 CORBA의
통합이 진행되고 있다. 특히,
CORBA 표준을 만들고 있는
OMG와
자바를 향상시키고 있는 선소프트사의 노력은 점점 가속화되고 있다.
1997년 7월에
열린 Object World West 97에서는
향후 1년내지
2년안에
자바와 CORBA의
경계는 없어질 것이라고 발표했다, 이를
뒷바침이라도 하듯 OMG에서는
CORBA3.0 표준안
에
자바빈스를 기반으로 한 컴포넌트 모델과 값에 의한 객체 전달,
자바 스크립팅 기술 등을 지원할
것이라고 발표했으며 선소프트사의 경우 CORBA의
이름 서비스, 디렉
토리
서비스, 트렌젝션
서비스 등 다양한 CORBA 기능을
자바 엔터프라이즈 솔루션에 첨부할 것이고 기존의 CORBA와
자바 RMI와의
상충되는 문제를 풀기위해 RMI의
하위 프로토콜로 CORBA의
IIOP를 사용할
것이라고 발표했다. 다음은
이러한 노력들을 정리한 것이다.
- 자바를 수용하려는 OMG의 활동
* 자바 인터페이스로 부터 직접 IDL을 생성해내기 위한 명세를 개발 중에 있다.
* 자바 RMI와 유사하게 값에 의한 객체 전달을 지원할 것이다.
* 자바 빈스에 기반한 컴포넌트 모델을 채택할 것이다.
* 자바 스크립팅
기술을 향후 CORBA3.0명세에
포함할 것이다.
- CORBA를 수용하려는 선의 노력
* CORBA IIOP를 채용함으로서 기존의 CORBA객체와의 연동과 개방형 구조를 확보 중에
있다.
* 자바의 투명성과 효율성을 잃지 않고 RMI를 사용하기 위해 IIOP기반의 RMI 제안중이다 .
* JTS(Java Transaction Service API)의 기반 기술로 CORBA의 OTS(Object Transaction Service)를 채택했다.
* CORBA 명명 서비스
,
디렉토리 서비스 등 기타 서비스를
자바 엔터프라이즈 프레임웍에 도입중이다.
지금까지 살펴본 자바와 CORBA의
통합 노력들은 실제 기술적인 효과외에 급속히 확산되고 있는 분산객체
시장에서 헤게모니를 선점하려는 의도가 숨어 있는 게 사실이다.
실제 OMG와
선소프트사는 CORBA와
자바빈스에 기반한 CORBA 컴포넌트들을
통해 마이크로소프트의 DCOM(Distributed Component
Object Model)에 기반한 ActiveX
컴포넌트들을 격퇴할 꿈에 부풀어
있다. 물론
이 꿈은 실제 상황이 될 수 있다. 그러나
이를 이루기 위해서는 몇가지 우려할 만한 사항들에 대한 해결책을
제시해야 할 것이다.
먼저,
CORBA에서
가장 중요하고 근간이 되는 철학 중 하나는 개발 언어에 종속되지
않는 중립적인 솔루션을 제공하는 것이다. 다시
말해, CORBA IDL
은
특정 언어에 종속되서는 안된다는 것이다. 따라서
CORBA가
자바와 투명하게 통합될수록 수많은 CORBA
공급업자들은
그들의 제품을 완전무결한 자바 버전으로 바꿔야만 한다.
물론 바꾸지 않아도 상관없겠지만
시장에서 살아남을 수 없을 것이다. 왜냐하면
CORBA 표준이
자바의 기능을 중심에 놓고 있기 때문이다. 특히,
CORBA의 경우 700개가
넘는 회사들이 참여하여 표준을 만들지만 자바의 경우 선의 독점적인
기술이기 때문에 실제 모든 합의 도출과정에서 많은 문제가 발생할
수 있다. 이러한
문제점들은 기존의 분산 객체시장을 또다시 세분화할 위험이 발생한다.
실제 이러한 상황을 우려하는
목소리는 높다. Orbix을
개발한 아이오나사의 기술담당자인 Annrai
O'Toole는
향후 CORBA 시장
은
C++을 중심으로
한 리거시 시스템 통합 시장과 자바를 기반으로 한 새로운 시스템
구축 시장으로 양분될 것으로 전망했다. 필자의
경우, 이러한
의견에 전적으로 동의한다. 그러나
또 하나 생각해야 할 점은 마이크로소프트의 행보이다.
마이크로소프트는 윈도우NT를
기반으로 한 솔루션을 계속 확장하고 있으며 표면적으로는 많은 성과를
보이고 있다. 비록
마이크로소프트의 DCOM기반의
ActiveX가
윈도우 환경에 국한된 기술이하는 제약을 갖고 있지만 윈도우NT의
확산은 분산 객체 시장에 많은 영향을 미칠 것이다.
또 하나 재미난 시나리오는 향후
마이크로소프트가 지금보다 더 급속히 자바 기술을 채용하여 선의
자바가 아니라 마이크로소프트의 자바를 발표한다면 또 다른 상황이
발생할 것이다. 지
금까지
마이크로소프트의 사업 스타일을 볼 때 자바의 시장의 안정기를 접어들수록
윈도우를 기반으로 한 마이크로소프트의 자바 시나리오는 더욱 가능성이
높을 수 있다.
5막을 마치며
CORBA는
시스템 통합 기술로서 기존의 다른 기술들을 손쉽게 통합하게 해 준다.
실제 CORBA를
마이크로소프트의 COM/DCOM
시스템과
통합할 수 있으며 선소프트의 자바 언어,
그리고 인터넷의 핵심 서비스인
WWW과
통합할 수 있다.
특히,
CORBA와 WWW,
자바의 통합은 Object
Web이란 새로운 개발 환경을 제공해주고
있다. Object Web은
CORBA가
제공하는 시스템 통합 기술과 자바가 제공하는 모빌 코드환경,
그리고 WWW가
제공하는 강건한 통신 환경을 제공해 준다.
우리는 이 통신 환경위에 대규모의
강건한 시스템을 구축할 수 있다.
[ 다음
| 이전
]